






当AI大模型遇上千亿网格,当数字孪生要求毫秒级响应——你的硬件,是瓶颈还是加速器?
2026年,中国CAE行业正经历一场静默而深刻的算力革命。
Ansys SimAI将电池包热管理设计周期从3个月压缩到2周;国产GalaxyEDS实现千亿网格、十万核并行的多物理场耦合仿真;GB 20072-2024碰撞新标将台车质量提升至1400kg,仿真网格精度要求进入毫米级时代;PINN物理信息神经网络的推理速度达到传统求解器的100-1000倍……
这些突破的背后,不仅是算法的胜利,更是一场硬件算力的重新定义。
作为深耕高性能计算领域多年的UltraLAB图形工作站方案提供商,我们深度拆解了2026年CAE四大核心计算场景,为你匹配真正能释放软件潜力的硬件架构。
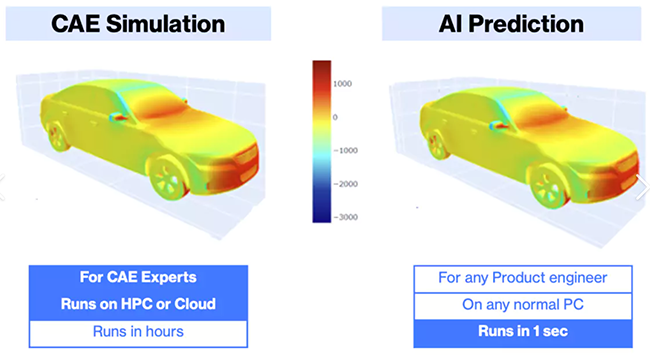
一、AI for Science:PINN与ROM的"显存战争"
计算特点解码
2026年CAE最大的变量是AI。物理信息神经网络(PINN)和降阶模型(ROM)正在颠覆传统仿真流程:
-
训练阶段:需要处理千万级甚至亿级参数,显存占用呈指数级增长
-
推理阶段:Ansys TwinAI要求毫秒级响应,单精度FP32/半精度FP16 Tensor Core加速成为刚需
-
数据吞吐:SimAI需要30-100组高保真CFD数据作为训练集,单组数据可达数十GB,存储带宽直接决定训练周期
关键瓶颈:显存容量 > CUDA核心数 > 存储带宽
UltraLAB硬件配置方案
【方案A】AI仿真工程师个人工作站(PINN/ROM开发+中小规模训练)
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon W7-3495X (56核112线程, 4.8GHz睿频) | 高频多核,兼顾数据预处理与多线程训练 |
| GPU | NVIDIA RTX Pro 6000 96GB ×1 | 96GB大显存,轻松加载千万级参数PINN模型;Blackwell架构FP4/FP8支持,AI推理提速2-3倍 |
| 内存 | 512GB DDR5-4800 ECC (8×64GB) | 训练数据集常驻内存,避免磁盘交换 |
| 存储 |
系统盘:2TB NVMe Gen4 SSD 数据盘:8TB NVMe Gen4 SSD (RAID 0) 归档盘:16TB SATA企业级 |
并行读写训练数据,RAID 0带宽突破14GB/s |
| 网络 | 双万兆以太网 | 快速拉取云端训练数据集 |
| 散热 | 360mm分体式水冷+机箱风道优化 | 350W CPU+300W GPU长时间满载稳定运行 |
| 相关机型 | UltraLAB GT430P 塔式超频静音工作站 | 办公室环境友好,满载噪音≤45dB |
适用场景:Ansys SimAI训练、电池热管理ROM模型开发、AI网格生成算法研究
【方案B】企业级AI仿真训练节点(大规模PINN训练+多任务并行)
| 组件 | 配置规格 |
|---|---|
| CPU | 双路 AMD EPYC 9655 (192核384线程, 3.8GHz) |
| GPU | NVIDIA RTX Pro 6000 96GB ×2 |
| 内存 | 2TB DDR5-4800 ECC RDIMM |
| 存储 | 4×4TB NVMe Gen4 SSD (RAID 0, 读速28GB/s) + 32TB SATA归档 |
| 网络 | 双25GbE SFP28 + 100GbE IB/RoCE (可选) |
| 相关机型 | UltraLAB GA668 机架式服务器 |
核心优势:双卡NVLink实现192GB显存池化,支持十亿级参数大模型全量训练;192核CPU负责数据增强与特征工程,GPU专注矩阵运算,Pipeline效率最大化。
二、云原生与超大规模并行:当网格数量达到"千亿级"
计算特点解码
GalaxyEDS 5.0实现千亿网格、十万核级并行,这背后是极致的并行计算架构需求:
-
内存容量:千亿网格的CFD/FEA模型,仅网格数据+矩阵方程即可占用数TB内存
-
内存带宽:稀疏矩阵求解是内存带宽敏感型任务,DDR5-4800的带宽优势远超DDR4
-
互联延迟:十万核并行意味着多节点MPI通信,节点间延迟决定并行效率天花板
-
存储I/O: checkpoint文件可达TB级,并行文件系统或高速NVMe阵列是刚需
关键瓶颈:内存容量 > 内存带宽 > 网络延迟 > CPU核心数
UltraLAB硬件配置方案
【方案C】超大规模仿真计算服务器(GalaxyEDS/Fluent/LS-DYNA千亿网格)
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 双路 Intel Xeon 6787P (172核344线程, 2.0/3.8GHz, 336MB L3) | 单路86核,双路172核,为十万核并行提供基础密度;336MB超大L3缓存减少内存访问延迟 |
| 内存 | 4TB DDR5-5600 ECC RDIMM (32×128GB) | 千亿网格模型常驻内存,预留50%余量用于求解器临时数据 |
| 存储 |
系统层:2×1.6TB NVMe SSD (RAID 1) 计算层:8×7.68TB NVMe SSD (RAID 0) 带宽:~56GB/s顺序读 |
分布式并行I/O,TB级模型秒级加载 |
| 网络 | 双100GbE RoCE v2 / InfiniBand HDR | 微秒级延迟,十万核MPI通信不卡顿 |
| 扩展 | 支持4×双宽GPU插槽 (未来升级AI+CAE融合) | 保护投资,平滑过渡到智能仿真 |
| 平台 | UltraLAB GX670 4U机架式服务器 | 企业机房标准,冗余电源,IPMI远程管理 |
适用场景:GalaxyEDS多效应耦合仿真、整车外流场十亿级网格、核电站结构安全评估
三、多物理场耦合与数字孪生实时计算:毫秒级响应的硬件哲学
计算特点解码
电池包的电-热-结构三场协同,以及数字孪生的实时预测,对硬件提出了截然不同的要求:
-
实时性:数字孪生要求毫秒级温度预测,这意味着模型必须常驻内存,CPU缓存命中率至关重要
-
可靠性:BMS嵌入式数字孪生需要7×24小时运行,ECC内存+企业级SSD是底线
-
低延迟:2RC等效电路模型+ROM降阶模型虽然计算量不大,但要求单核高频保证响应速度
-
数据流:IIoT传感器数据持续涌入,需要高并发I/O处理能力
关键瓶颈:单核频率 > 内存延迟 > 系统可靠性 > I/O并发
UltraLAB硬件配置方案
【方案D】数字孪生实时计算边缘工作站(电池热管理/BMS集成)
| 组件 | 配置规格 |
|---|---|
| CPU | Intel Core i9-14900KS (24核32线程, 6.2GHz睿频) 或 Xeon W9-3595X |
| 内存 | 128GB DDR5-5600 ECC (低延迟CL36规格) |
| 存储 | 2×2TB NVMe SSD (系统+数据双冗余) |
| GPU | RTX Pro 5000 72GB (可选,用于复杂ROM推理) |
| 网络 | 4×千兆网口 + 5G模块 (工业现场部署) |
| 平台 | UltraLAB A330 紧凑型塔式工作站 |
核心优势:6.2GHz超高频确保单线程ROM模型毫秒级求解;双冗余存储+ECC内存满足车载/产线7×24小时可靠性要求;紧凑机箱可部署于产线边缘机房。
四、碰撞仿真:新标准下的"网格精度风暴"
计算特点解码
2026年7月1日实施的碰撞新标,将仿真计算强度推向新高度:
-
网格密度:白车身关键区域3-5mm,电池模组内部1-2mm,整车模型网格量轻松突破千万级
-
显式动力学:LS-DYNA/PAM-CRASH等求解器依赖高主频CPU,时间步长与单元尺寸成正比,小网格意味着更多计算步数
-
电池模型升级:从质量点变为电化学-热耦合详细模型,新增大量非线性方程
-
AI碰撞仿真:Luminary SHIFT-Crash等工具需要GPU进行深度学习推理
关键瓶颈:CPU主频 > 内存容量 > GPU推理能力 > 存储随机读写
UltraLAB硬件配置方案
【方案E】碰撞安全仿真专用工作站(GB 20072-2024合规验证)
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核192线程, 5.1GHz睿频) | 显式求解器吃主频,5.1GHz睿频缩短单次仿真周期;96核支持多工况并行提交 |
| 内存 | 1TB DDR5-4800 ECC RDIMM | 千万级网格+详细电池模型+假人约束系统,内存占用轻松破500GB |
| GPU | RTX Pro 5000 72GB ×1 | SHIFT-Crash AI推理加速;72GB显存支持整车级点云模型直接加载 |
| 存储 |
系统:2TB NVMe Gen4 计算:4×4TB NVMe Gen4 (RAID 0) 备份:16TB SATA企业级 |
碰撞仿真频繁读写重启动文件,RAID 0提供28GB/s带宽,减少I/O等待 |
| 平台 | UltraLAB GR450P 超频静音工作站 | 支持多GPU扩展,为未来AI+物理联合仿真预留空间 |
实战效率:相比传统4核工作站,该配置可将单次整车碰撞仿真从72小时压缩至8-12小时,工程师可在下班前提交任务,次日早晨获取结果。
五、选型决策树:找到你的"算力甜蜜点"
| 你的核心场景 | 首选配置 | 关键指标 |
|---|---|---|
| AI仿真训练/PINN/ROM开发 | 方案B (双路EPYC+双RTX Pro 6000) | 显存容量 > 192GB,存储带宽 > 20GB/s |
| 千亿网格超大规模CFD/FEA | 方案C (双路Xeon 6767P+4TB内存) | 内存容量 > 2TB,网络延迟 < 2μs |
| 数字孪生实时计算/边缘部署 | 方案D (i9-14900KS+128GB ECC) | 单核频率 > 5.5GHz,系统MTBF > 5万小时 |
| 碰撞安全仿真/GB 20072合规 | 方案E (TR PRO 7995WX+1TB内存) | CPU睿频 > 5.0GHz,内存 > 512GB |
| 个人全能型仿真工程师 | 方案A (Xeon W7-3495X+RTX Pro 6000) | 静音办公,一机覆盖90%仿真场景 |
结语:算力即竞争力
2026年的CAE行业,软件层面的差距正在通过AI和云原生被快速抹平,但硬件算力的鸿沟却在拉大。
当你的竞争对手已经用RTX Pro 6000在2天内完成SimAI模型训练,而你还在用老旧工作站等待72小时的单次CFD结果;当别人的数字孪生系统已经实时预测热失控,你的模型还在因为内存不足频繁读写虚拟内存……
硬件,已经成为CAE工程师的核心竞争力之一。
UltraLAB深耕高性能计算领域,所有工作站均针对CAE软件(Ansys、Abaqus、LS-DYNA、Fluent、GalaxyEDS等)进行BIOS级优化,确保求解器线程调度、内存时序、PCIe带宽达到最佳状态。
2026年,别让硬件成为你的仿真瓶颈。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


