






从"生成代码示例"到"直接操控求解器会话",CAE-Agent-Hub 正在重新定义 AI 辅助仿真的边界。前处理环节(几何→网格→材料→接触→边界条件)首次实现了自然语言驱动的全链路自动化。
一、从 Text-to-Code 到 Text-to-CAE:范式跃迁
传统的大模型辅助仿真工作流,往往停留在"生成一段 Python 脚本,用户自行粘贴运行"的阶段。CAE-Agent-Hub 的突破性在于:它通过 MCP(Model Context Protocol)服务器 在 AI 客户端与 CAE 应用之间建立实时桥梁,使 AI 能够直接操控真实的求解器会话。
1.1 传统模式 vs 智能前处理 Agent 模式
| 对比维度 | 传统 AI 辅助模式 | CAE 智能前处理 Agent 模式 |
|---|---|---|
| 交互方式 | 生成脚本代码,用户手动复制粘贴执行 | 自然语言指令直接驱动 CAE 会话实时执行 |
| 执行环境 | 离线代码片段,需人工集成到工作流 | 实时连接 Abaqus/HyperMesh/Fluent 等活跃会话 |
| 状态感知 | 无状态,不了解当前模型上下文 | 持续跟踪几何、网格、材料、接触、边界条件的实时状态 |
| 错误处理 | 脚本报错后用户自行排查 | Agent 自主观察执行结果,判断重试、修正或请求人工确认 |
| 知识复用 | 依赖个人经验与培训 | 专家经验封装为 SKILL.md 可复用技能包,团队共享 |
| 学习曲线 | 需记忆复杂 API(Python/Tcl/Journal) | 对话式交互,零代码门槛完成高质量前处理 |
1.2 核心能力矩阵
| 能力层级 | 具体表现 | 代表工具/技能 |
|---|---|---|
| L1 脚本生成 | 生成可复用代码片段,人工执行 | SKILL.md 技能包(Level 1) |
| L2 实时操控 | AI 直接调用 CAE 内核命令 | MCP Server(Level 2) |
| L3 闭环验证 | 执行→观察→判断→修正的完整闭环 | Agent + Subagent 协作 |
| L4 知识沉淀 | 专家经验封装为团队共享资产 | SKILL.md 指令包 + 向量数据库 |
二、大模型本地部署:软件清单与架构
要在本地构建一套完整的 CAE 智能前处理系统,需要以下核心软件组件:
2.1 基础软件清单
| 层级 | 软件/组件 | 功能说明 | 适用平台 | 推荐版本 |
|---|---|---|---|---|
| 操作系统 | Windows 11 Pro / Ubuntu 22.04 LTS | 稳定运行环境,支持主流 CAE 软件 | 全部 | 22.04.4 LTS |
| CAE 平台 | Abaqus 2024 / HyperWorks 2025 / ANSYS Fluent 2024 R1 | 核心求解与前处理平台 | 厂商授权 | 2024/2025 |
| AI 推理引擎 | Ollama / LM Studio / vLLM | 本地大模型加载与推理服务 | 全部 | Ollama 0.3.x |
| 大语言模型 | Qwen2.5-72B / DeepSeek-Coder-V2 / Llama 3.1-70B | 自然语言理解、代码生成与 CAE 指令解析 | 全部 | 最新版 |
| MCP 协议层 | CAE-Agent-Hub MCP Server | AI 客户端与 CAE 应用的实时通信桥梁 | 开源 | GitHub 最新 |
| 技能包管理 | SKILL.md 指令包体系 | 几何、网格、材料、接触、边界条件等可复用技能 | 开源 | 社区版 |
| 向量数据库 | ChromaDB / Milvus | 仿真规范、历史案例、材料库的语义检索 | 全部 | 0.5.x |
| 任务编排 | LangChain / LlamaIndex | 复杂前处理任务的拆解、规划与执行链管理 | 全部 | 0.2.x |
| 浏览器查看器 | CAE-Agent-Hub Viewer (React/Vue) | 零求解器环境下的结果预览与教学演示 | npm | 最新 |
| 监控日志 | LangSmith / Grafana | Agent 执行过程的可观测性与性能分析 | 云/本地 | 最新 |
2.2 推荐部署架构
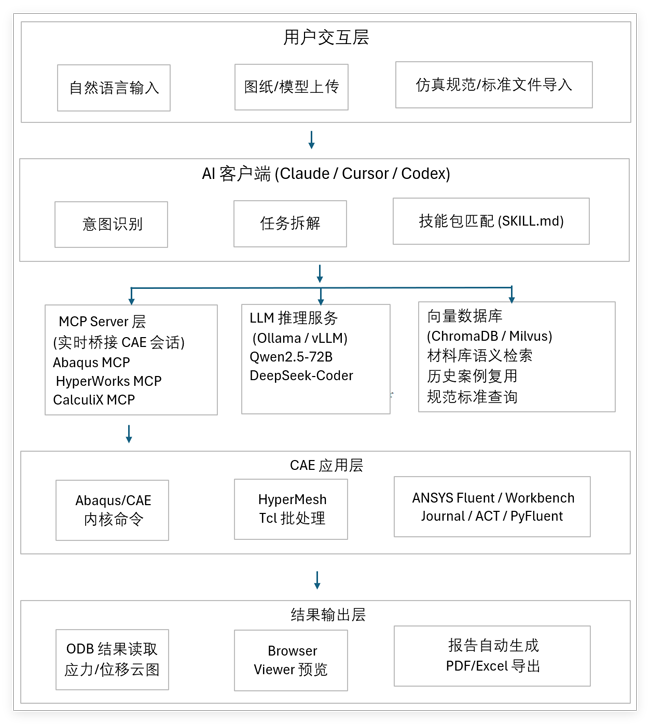
三、主要应用环节:FEM 前处理全链路 AI 覆盖
前处理(Preprocessing)是有限元分析中最耗时、最依赖经验的环节。CAE-Agent-Hub 针对这一痛点,提供了覆盖几何→网格→材料→接触→边界条件的完整 AI 技能链。
3.1 前处理环节全景图
| 环节编号 | 应用环节 | 具体任务描述 | 对应 Skill / MCP | 效率提升 |
|---|---|---|---|---|
| P01 | 几何建模与导入 | 创建部件、草图、拉伸、装配体;导入 STEP/IGES CAD 模型;几何清理与修复 |
abaqus-geometry / FreeCAD MCP
|
50%~70% |
| P02 | 网格划分 | 生成有限元网格并选择单元类型(C3D8R、C3D10 等);2D/3D 网格自动划分;拓扑清理与质量检查 |
abaqus-mesh / HyperMesh Subagent / Elmer FEM MCP
|
60%~80% |
| P03 | 材料定义 | 定义材料属性、截面、密度、弹性模量、塑性曲线及常见工程属性库匹配 |
abaqus-material
|
40%~60% |
| P04 | 接触与相互作用 | 定义接触对、摩擦系数、Tie 约束、连接器、绑定表面;自动识别接触区域 |
abaqus-interaction
|
50%~70% |
| P05 | 边界条件与载荷 | 边界条件、载荷施加、分析步设置、幅值曲线、场输出与历史输出请求配置 |
abaqus-bc / load / step
|
40%~60% |
| P06 | 作业提交与监控 | 模型检查、作业提交、求解器状态监控、错误自动诊断与重试 |
abaqus-job
|
30%~50% |
| P07 | 结果提取与报告 | ODB 结果读取、应力/位移云图提取、关键数据自动汇总、报告自动生成 |
abaqus-odb
|
50%~70% |
| P08 | 优化与参数扫描 | 尺寸优化(LHS 采样 + 坐标下降)、模态分析、参数化设计变量编辑 | CalculiX MCP / FEP Agent Hub | 60%~80% |
3.2 三大核心方案详解
方案一:Abaqus 前处理技能链(Skill-based)
这是目前最完整的商业 FEA 前处理 AI 化方案。用户只需发送自然语言指令:
"创建一个钢制的悬臂梁,长度 1m,截面 0.1×0.1m,一端固定,另一端施加 1000N 集中力,划分 C3D8R 网格,运行静力分析并提取最大应力。"
AI 自动调用完整技能链:
abaqus-geometry → abaqus-material → abaqus-mesh → abaqus-bc → abaqus-load → abaqus-step → abaqus-job → abaqus-odb
在实时 Abaqus 会话中完成建模、求解和后处理闭环。
方案二:HyperMesh 实时操控(MCP-based)
面向航空、汽车等需要复杂几何清理和高质量网格的行业:
| 功能模块 | 具体能力 |
|---|---|
| 拓扑检查 | 检查 component、surface、edge 状态,自动识别几何缺陷 |
| 网格划分 | 2D/3D 自动网格划分,支持自动拓扑识别与批量网格策略 |
| Tcl 批处理 | 运行经筛选的批处理脚本,自动拓扑修复、面网格→体网格转换 |
| 求解器管理 | 管理 OptiStruct、Radioss 作业提交与状态监控 |
| 子代理协作 | HyperMesh Meshing Subagent 支持自动拓扑识别与批量网格策略 |
方案三:CalculiX 开源全栈(零许可证成本)
面向教育、初创团队或大量参数扫描场景:
| 功能 | 说明 |
|---|---|
| .inp 解析 | 解析 CalculiX 输入文件卡片 |
| 设计变量编辑 | 就地编辑参数化设计变量 |
| ccx 求解 | 后台运行 CalculiX 求解器 |
| 结果读取 | 读取 .dat 文本结果,导出 result_mesh.json |
| 尺寸优化 | 两阶段优化:LHS 采样 + 坐标下降,最小化质量并满足应力/位移约束 |
| 模态分析 | 提取固有频率和振型,与 Euler-Bernoulli 手算解端到端验证 |
四、UltraLAB 硬件配置推荐(2026v3 基准配置表)
CAE 智能前处理对硬件有特殊要求:既要支撑大模型本地推理(显存密集型),又要保障 CAE 软件流畅运行(CPU 多核性能 + 大内存),同时网格划分和求解阶段对多核并行有极高需求。
4.1 配置选型总览
| 配置等级 | 定位 | 适用模型规模 | CAE 并发规模 | 对应 UltraLAB 机型 | 预估价格 |
|---|---|---|---|---|---|
| 入门版 | 个人工程师 / 教育用途 | 7B~14B 参数模型 | 单模型轻量前处理 | A350 超频图形工作站 | ¥25,500~52,000 |
| 标准版 | 中型仿真团队 | 32B 参数模型 | 中型装配体 + 中等规模网格 | A350 高配 / GR450P | ¥76,000~128,000 |
| 专业版 | 大型设计院 / 车企 / 航空 | 70B Q4 量化模型 | 大型装配体 + 千万级网格 | GR450P / AE450 / AX450 | ¥99,000~275,000 |
| 旗舰版 | 集团级仿真中心 / 超算节点 | 多模型并发 70B+ | 整车/整机级全尺度仿真 | EA660 / GX660M / AlphaPro660 | ¥252,000~999,900 |
4.2 详细配置清单
入门版 —— A350 超频图形工作站
推荐型号:A35014832-MBX / A35015696-MCB
| 组件 | 规格参数 | 说明 |
|---|---|---|
| CPU | Intel Ultra-245K(14 核,6 性能核 4.8GHz)/ Intel Ultra 9-285K(24 核,8 性能核 5.6GHz) | 高主频保障 Abaqus/HyperMesh 交互响应,超频架构提升单线程效率 |
| GPU | RTX 5060 8GB / RTX A2000 | 8GB 显存可运行 7B~13B 量化模型,支持 CUDA 加速部分 CAE 运算 |
| 内存 | 32GB / 96GB DDR5 | 满足模型加载与中型网格前处理 |
| 存储 | 2TB NVMe SSD + 8TB SATA / 4TB NVMe + 8TB SATA | 快速启动与项目数据归档 |
| 显示器 | 27" 2K / 32" 2K 专业图显 | CAE 前后处理界面细节呈现 |
| 报价 | ¥25,500 / ¥43,990 | 高性价比入门方案 |
适用场景:个人工程师学习 CAE-Agent-Hub、小型装配体前处理、7B~14B 模型辅助代码生成。A350 系列采用 Intel Ultra 超频处理器,单核高频特性完美匹配 CAE 软件的交互响应需求。
标准版 —— GR450P 极致超频工作站
推荐型号:GR450P15064-MCT / GR450P150128-MCX
| 组件 | 规格参数 | 说明 |
|---|---|---|
| CPU | AMD 锐龙 TR-7970X(32 核 5.0GHz)/ TRpro-7975WX(32 核 5.0GHz) | 32 核超高频,Abaqus 多核并行 + HyperMesh 网格划分无压力 |
| GPU | RTX 5080 16GB / RTX 5090 D 32GB |
16 |
| 内存 | 64GB / 128GB DDR5 | 大型装配体前处理 + 多模型并发 |
| 存储 | 4TB NVMe SSD + 8TB SATA | 高速缓存 + 数据归档 |
| 散热 | 全水冷系统 | 长时间 CAE 求解 + AI 推理高负载稳定运行 |
| 显示器 | 27" 2K / 双 27" 4K 专业图显 | 多窗口并行:CAE 界面 + AI 交互面板 |
| 报价 | ¥108,000 / ¥128,000 | 中型团队标准方案 |
适用场景:中型仿真团队、汽车/航空零部件前处理、32B 模型推理辅助。GR450P 的 AMD TR-7970X 32 核 5.0GHz 是 CAE 前处理的黄金配置——高主频保障交互响应,32 核并行加速网格划分与求解。
专业版 —— AE450 / AX450 水冷图形工作站
推荐型号:AE450135256-MCX / AX450135128-MCX / AE450141256-MCX
| 组件 | 规格参数 | 说明 |
|---|---|---|
| CPU | AMD 霄龙 9375F(32 核 3.1GHz,768MB 缓存)/ Xeon 6980P(128 核 3.2GHz,503MB 缓存)/ AMD 霄龙 9755(128 核 4.1GHz,512MB 缓存) | 霄龙超大缓存加速 FEM 矩阵运算,Xeon 128 核海量并行 |
| GPU | RTX 5080 16GB / RTX Pro 5000 48GB | 16~48GB 显存,70B Q4 模型推理 + 电磁仿真 GPU 加速 |
| 内存 | 128GB / 256GB DDR5 / DDR4 | 千万级网格驻留 + 超大上下文 |
| 存储 |
2TB |
高速缓存 + 安全归档 |
| 散热 | 全水冷系统 | 持续高负载稳定运行 |
| 显示器 | 27" 2K / 27" 4K 专业图显 | 复杂仿真结果可视化 |
| 报价 | ¥99,000 / ¥116,000 / ¥165,000 | 专业级方案 |
适用场景:大型设计院、车企整车仿真、航空结构分析、70B Q4 大模型推理。AE450 系列的 AMD 霄龙处理器配备超大三级缓存(768MB),对 FEM 稀疏矩阵运算有显著加速效果。AX450 的 Xeon 6980P 128 核配置适合超大规模并行求解。
旗舰版 —— EA660 全水冷双路 / GX660M AI 计算 / AlphaPro660 超级图形工作站
推荐型号:EA660235512-MCX / GX660M235640-MD4A / AlphaPro660241768-MDF
| 组件 | 规格参数 | 说明 |
|---|---|---|
| CPU | 2× AMD 霄龙 9755(256 核 4.1GHz)/ 2× AMD 霄龙 75F3(128 核 3GHz+)/ 2× AMD 霄龙 9755(256 核 4.1GHz) | 双路服务器级,256 核+ 海量并行算力 |
| GPU | RTX 5090 32GB + 水冷 / 4× A100 80GB + 水冷 / A100 80GB + 水冷 | 128GB~320GB 总显存,多模型并发推理 |
| 内存 | 512GB / 640GB / 768GB DDR5 | 超大规模装配体 + 多模型驻留 |
| 存储 | 4TB~8TB NVMe SSD(14GB/s)+ 20TB SATA | 全闪存高速缓存 + 海量归档 |
| 散热 | 双塔式水冷(双 2000W~2600W 电源) | 4 卡高负载持续稳定 |
| 网络 | 40G 以太网 / 万兆口 | 团队级模型分发与数据协同 |
| 显示器 | 27" 4K 专业图显 | 超大规模结果可视化 |
| 报价 | ¥252,000 / ¥620,000 / ¥515,000 | 集团级算力中枢 |
适用场景:集团级仿真中心、多物理场耦合分析、多 Agent 智能体并发、API 服务部署、5~20 人团队共享。GX660M 的 4× A100 80GB 可同时运行多个 70B 模型实例 + 大规模电磁仿真 GPU 加速,是 CAE 智能前处理的终极配置。
4.3 UltraLAB 全系列机型对照表(CAE 智能前处理专用)
| 机型系列 | 核心定位 | CPU 特点 | 典型 GPU | 内存范围 | 适用模型 | 价格区间 |
|---|---|---|---|---|---|---|
| A350 | 超频图形工作站 | Intel Ultra 超频,高主频 4.8~5.6GHz | RTX 5060 / A2000 | 32~128GB | 7B~14B | ¥25,500~76,000 |
| GR450P | 极致超频工作站 | AMD TR 超频,32 核 5.0GHz | RTX 5080 / 5090 D | 64~256GB | 32B~70B Q4 | ¥92,000~198,000 |
| AE450 | 水冷图形工作站 | AMD 霄龙,超大缓存 768MB | RTX 5080 / Pro 5000 | 128~384GB | 70B Q4 | ¥59,990~275,000 |
| AX450 | 水冷图形工作站 | Xeon 至强,最高 128 核 | RTX 5060Ti~5080 | 128~256GB | 70B Q4 | ¥116,000~192,000 |
| EA660 | 全水冷双路工作站 | 双路 AMD 霄龙,最高 256 核 | RTX 5080~5090 | 192~768GB | 多模型并发 | ¥89,990~420,000 |
| GX660M | AI 计算工作站 | 双路 AMD 霄龙 | 4×A100 / 4×RTX Pro 6000 | 640GB~1TB | 多模型并发 | ¥142,000~1,150,000 |
| AlphaPro660 | 超级图形工作站 | 双路 AMD 霄龙,最高 256 核 | RTX Pro 5000~H200 | 512GB~1.5TB | 全参数微调 | ¥330,000~999,900 |
五、常见问题:硬件配置深度分析
5.1 CAE 前处理 + 大模型推理,硬件瓶颈在哪里?
| 工作阶段 | 主要瓶颈 | 关键硬件 | 优化建议 |
|---|---|---|---|
| 自然语言交互 | 大模型推理延迟 | GPU 显存 + Tensor Core 算力 | 显存 ≥ 模型量化后大小的 1.2 倍 |
| 几何清理 | 复杂曲面布尔运算 | CPU 单核性能 + 内存带宽 | 单核频率 ≥ 5.0GHz,内存 ≥ 64GB |
| 网格划分 | 千万级单元生成 | CPU 多核并行 + 内存容量 | 核心数 ≥ 16,内存 ≥ 128GB |
| 材料/接触设置 | 大量参数配置 | 内存容量 + AI 推理并发 | 内存 ≥ 256GB(专业版) |
| 求解阶段 | 大规模矩阵运算 | CPU 多核 / GPU 加速 / 分布式 | 根据求解器选择 CPU 或 GPU 加速 |
| 结果后处理 | 大 ODB 文件读取 | NVMe SSD 顺序读写 + 内存 | PCIe 4.0/5.0 NVMe,内存缓存 |
5.2 显存到底需要多大?
| 模型规模 | FP16 显存需求 | INT8 量化需求 | INT4 量化需求 | 推荐 UltraLAB 机型 |
|---|---|---|---|---|
| 7B | ~14 GB | ~7 GB | ~4 GB | A35014832-MBX(RTX 5060 8GB) |
| 14B | ~28 GB | ~14 GB | ~7 GB | A35015064-MBX(RTX 5060 8GB + 内存 offload) |
| 32B | ~64 GB | ~32 GB | ~16 GB | GR450P150128-MCX(RTX 5080 16GB) |
| 70B | ~140 GB | ~70 GB | ~35 GB | GR450P148192-MCC(RTX 5090 D 32GB) |
| 110B | ~220 GB | ~110 GB | ~55 GB | GX660M229768-MD4H(4×RTX Pro 6000 96GB) |
核心结论:显存是本地部署的第一瓶颈。CAE 智能前处理通常需要 32B~70B 级别的代码/推理模型以保证指令解析准确性,GR450P 的 RTX 5090 D 32GB 是 70B INT4 量化的黄金配置,GX660M 的 4×A100 80GB 适合多模型并发场景。
5.3 CPU 在 CAE 前处理中的双重角色
| 角色 | 具体任务 | 性能要求 | 推荐 CPU |
|---|---|---|---|
| CAE 前处理核心 | 几何布尔运算、网格生成算法、装配体管理 | 单核高频(≥ 5.0GHz)+ 大缓存(≥ 36MB L3) | Intel Ultra 9-285K(5.6GHz) |
| AI 推理辅助 | Tokenize、Prompt 组装、后处理解码、向量检索 | 多核并行(≥ 16 核),内存带宽敏感 | AMD TR-7970X(32 核 5.0GHz) |
| 求解器主机 | 隐式求解、显式求解、优化迭代 | 根据求解器类型:Abaqus Standard 重单核,Abaqus Explicit 重多核 | AMD 霄龙 9755(128 核 4.1GHz) |
建议:CAE 前处理优先选择高主频桌面级 CPU(Intel Ultra 9-285K / AMD TR-7970X);若求解规模巨大,再考虑 AE450/AX450 的霄龙/Xeon 多核扩展性。AMD 霄龙处理器的超大三级缓存(768MB)对 FEM 稀疏矩阵运算有显著加速。
5.4 内存容量如何规划?
| 场景 | 内存需求 | 推荐 UltraLAB 配置 |
|---|---|---|
| 7B 模型 + 小型装配体 (<10万单元) | 32~64GB | A35014832-MBX / A35015064-MBX |
| 32B 模型 + 中型装配体 (10~100万单元) | 128GB | GR450P150128-MCX |
| 70B 模型 + 大型装配体 (100~500万单元) | 256GB | AE450141256-MCX / AX450132256-MCX |
| 整车/整机级仿真 (500万+ 单元) | 512GB~768GB | EA660235512-MCX / GX660M235640-MD4A |
| 向量数据库 + 历史仿真库 | +64~128GB | 叠加计算 |
建议:内存容量 ≈ 显存容量 × 3
5 倍。CAE 前处理的网格数据极其消耗内存,内存不足会导致网格划分失败或求解器换页崩溃。UltraLAB GR450P 系列支持 128256GB,EA660 双路系列支持 512~768GB。
5.5 NVMe SSD 为什么不可或缺?
| 文件类型 | 典型大小 | SATA SSD 加载 | NVMe Gen4 加载 | 性能差异 |
|---|---|---|---|---|
| 32B 模型权重 (INT4) | ~18 GB | 45s | 10s | 4.5× |
| 70B 模型权重 (INT4) | ~40 GB | 100s | 25s | 4× |
| 大型 CAE 装配体 | 200~500 MB | 3s | 0.5s | 6× |
| 千万级网格 ODB 结果 | 5~20 GB | 60s | 15s | 4× |
| 向量数据库 (100万条) | 2~5 GB | 10s | 2s | 5× |
建议:UltraLAB 全系列标配 NVMe SSD(2TB~8TB),AlphaPro660 系列更配备 8TB NVMe(14GB/s 极速读取)。模型文件与 CAE 工作目录必须存放于 NVMe Gen4/Gen5 SSD。
5.6 为什么推荐 UltraLAB 而非普通组装机?
| 对比维度 | 普通组装机 / 游戏主机 | UltraLAB 工作站 |
|---|---|---|
| 长时间稳定性 | 高负载易降频、蓝屏 | 面向 7×24 小时 Vivado 综合设计,全水冷散热 |
| ECC 内存 | 不支持 | 专业版/旗舰版支持,防止长时间仿真数据错误 |
| 多 GPU 扩展 | 最多 2 槽,散热不足 | 支持 4 路 GPU,双塔式水冷,独立风道设计 |
| 超大缓存 CPU | 无 | AE450 系列配备 AMD 霄龙 768MB 三级缓存,FEM 运算加速显著 |
| ISV 认证 | 无 | 通过 Abaqus、ANSYS、HyperWorks 等 ISV 认证 |
| 驱动兼容性 | 消费级驱动,CAE 软件偶发兼容性问题 | 工作站级驱动,CAE 厂商联合认证 |
| 噪音控制 | 高负载风扇噪音大,开放式办公干扰 | 双塔式水冷设计,≤ 35dB 办公环境友好 |
| 售后服务 | 消费级保修,返厂周期长 | 3 年上门 + 专属工程师 + CAE 环境调优支持 |
| 远程测试 | 无 | 全系列支持远程测试,可先体验后决策 |
六、快速上手:5 分钟接入你的工作流
CAE-Agent-Hub 的安装分为三个层次,根据需求选择:
6.1 Level 1 —— 使用 Skills(无需安装 CAE 软件)
将技能目录复制到 Agent 的技能目录,AI 即可在生成脚本时引用最佳实践:
# Codex 示例
New-Item -ItemType Directory -Force -Path "$env:USERPROFILE\.codex\skills"
Copy-Item -Recurse -Force ".\Skill\abaqus\analysis\abaqus-static-analysis" `
    "$env:USERPROFILE\.codex\skills\abaqus-static-analysis"
6.2 Level 2 —— 部署 MCP Server(需本地安装 CAE 软件)
Set-Location ".\MCP\Abaqus\abaqus_mcp"
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install -e .
# 然后按 README 配置客户端注册(Claude Desktop / Cursor)
6.3 Level 3 —— 使用 Text-to-CAE 查看器(零求解器)
Set-Location .\viewer
npm install
npm run dev
# 打开 http://127.0.0.1:4178/?case=cantilever
实用建议:已使用 Abaqus 或 HyperMesh 的工程师,建议从 Level 2 开始——MCP Server 安装仅需 10 分钟,但"自然语言操控 CAE"的体验是颠覆性的。希望先了解 AI 辅助仿真潜力的团队,建议从 Level 3 浏览器查看器开始零成本体验。
七、技术意义与行业展望
CAE-Agent-Hub 的出现标志着仿真工程的一个转折点:
| 变革维度 | 传统模式 | 智能前处理 Agent 模式 |
|---|---|---|
| 知识沉淀 | 专家经验→培训→个人技能 | 专家经验→SKILL.md 指令包→AI 复用→团队共享 |
| 前处理效率 | 几何清理、网格划分、接触设置耗时数小时 | 自然语言指令 + 自动化脚本,压缩至分钟级 |
| 使用门槛 | 需记忆复杂 API(Python/Tcl/Journal) | 对话式交互,初级工程师也能完成高质量前处理 |
| 成本结构 | 高许可证成本(Abaqus、HyperMesh) | CalculiX MCP 提供零许可证成本的高质量 FEM 方案 |
| 验证闭环 | 人工检查结果,周期长 | Agent 自主观察执行结果,自动纠错与验证 |
展望未来,随着更多求解器 MCP 的加入(COMSOL、LS-DYNA、Star-CCM+ 等)以及多物理场耦合技能的完善,**"一句话跑完一个多物理场仿真"**的愿景正在从想象变为现实。
八、结语
CAE 智能前处理不是替代仿真工程师,而是将工程师从重复性、规则性的前处理工作中解放出来,聚焦物理建模、结果判读与工程决策。
当大模型从"生成代码"走向"操控软件",当 Agent 从"建议"走向"执行",仿真工程的工作流正在被重新定义。选择合适的硬件、搭建稳定的本地推理环境、理解 Agent 的能力边界——这三件事,将决定你在 AI 辅助仿真浪潮中能走多远。
立即行动:访问 UltraLAB 官网获取定制化配置方案,或前往 GitHub 搜索
CAE-Agent-Hub获取开源工具集,开启你的智能仿真之旅。UltraLAB 全系列支持远程测试,可先体验后决策。
本文基于 CAE-Agent-Hub 开源项目公开信息整理,首发于 IFEM「仿真工具智能化」专栏,2026 年 8 月。
项目信息:
- 仓库地址:github.com/Cai-aa/CAE-Agent-Hub
- 作者:Cai-aa
- 许可证:开源
- 最近更新:2026 年 8 月 22 日(HyperWorks 2025 兼容性修复)
- 核心覆盖:Abaqus / ANSYS Fluent / ANSYS Workbench / AEDT-HFSS / HyperWorks / CalculiX / LAMMPS / COMSOL / FreeCAD / Elmer FEM / FEniCS
关键词:CAE 智能前处理, AI Agent, MCP 协议, 大模型本地部署, Abaqus, HyperMesh, ANSYS Fluent, CalculiX, UltraLAB 工作站, 有限元仿真, SKILL.md, CAE-Agent-Hub, A350, GR450P, AE450, GX660M


