






摘要:HyperMesh作为Altair HyperWorks平台的核心前后处理工具,广泛应用于汽车、航空航天、能源等领域的复杂有限元分析。随着AI大模型在生成式设计、智能网格划分、仿真结果预测等CAE场景的深度融合,工程师面临"传统CAE仿真+AI推理训练"的双重算力需求。本文基于HyperMesh的硬件需求特征,结合AI大模型本地部署的算力要求,提供UltraLAB工作站的完整选型方案、软件生态清单、应用场景配置推荐及常见问题深度分析。
目录
- HyperMesh CAE仿真技术解析
- AI大模型赋能CAE工程智能
- CAE+AI混合负载的算力需求特征
- UltraLAB硬件配置选型指南
- 软件清单与工具链
- 应用场景与配置推荐
- 常见问题与硬件配置分析
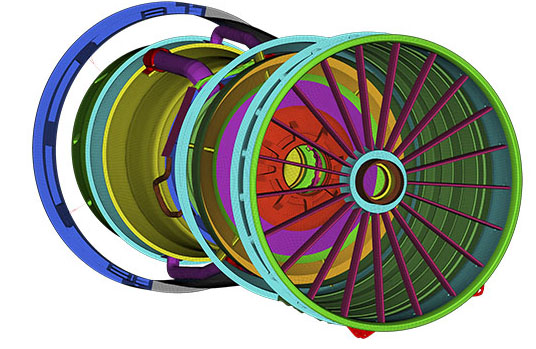
一、HyperMesh CAE仿真技术解析
1.1 HyperMesh核心能力与应用领域
HyperMesh是一款先进的有限元分析(FEA)前后处理软件,作为Altair HyperWorks平台的核心组件,广泛应用于以下领域:
| 应用领域 | 典型分析类型 | 模型规模特征 | 硬件敏感组件 |
|---|---|---|---|
| 汽车 | 整车碰撞、NVH、疲劳耐久、拓扑优化 | 千万级网格、多工况并行 | CPU多核、大内存 |
| 航空航天 | 复合材料分析、鸟撞、气动弹性、结构强度 | 复杂曲面、各向异性材料 | CPU主频、内存带宽 |
| 能源 | 涡轮叶片强度、管道应力、风电塔筒 | 非线性接触、热固耦合 | CPU多核、SSD存储 |
| 电子电器 | 跌落仿真、热管理、EMC | 精细几何、多物理场 | 内存容量、GPU加速 |
| 轨道交通 | 车体模态、轨道耦合、被动安全 | 超大规模装配体 | 内存容量、多核并行 |
1.2 HyperMesh核心工作流程与硬件瓶颈
HyperMesh的工作流程可分为三大阶段,各阶段对硬件的需求差异显著:
| 工作阶段 | 核心操作 | 计算特征 | 硬件瓶颈 | 优化方向 |
|---|---|---|---|---|
| 前处理 | 几何清理、网格划分、材料属性赋予、边界条件设置 | 单线程为主,交互响应敏感 | CPU单核性能、内存容量 | 高主频CPU、大内存 |
| 求解计算 | 矩阵求解、迭代运算、非线性分析 | 多核并行,计算密集型 | CPU多核性能、内存带宽 | 多核处理器、多通道内存 |
| 后处理 | 结果可视化、云图渲染、动画生成、报告输出 | 图形渲染为主,数据吞吐大 | GPU图形性能、存储I/O | 专业显卡、高速SSD |
1.3 HyperMesh官方硬件需求基准
根据HyperMesh官方及工程实践推荐,基础硬件配置需求如下:
| 组件 | 基础配置 | 推荐配置 | 高性能配置 |
|---|---|---|---|
| CPU | Intel Core i7 / AMD Ryzen 7 | Intel Core i9 / Xeon W / AMD Ryzen 9 | Xeon W-3400 / Threadripper PRO 双路 |
| 内存 | 16 GB DDR4 | 32-64 GB DDR4/DDR5 | 128-512 GB DDR5 ECC |
| 显卡 | 一般独立显卡 | 中端专业显卡(NVIDIA T1000/A2000) | RTX A5000/A6000 / RTX 4090 |
| 存储 | 100 GB HDD | 256 GB SSD + 1 TB HDD | 1 TB NVMe Gen4 + 4 TB SSD RAID |
| 操作系统 | Windows 10/11 | Windows 11 / Linux RHEL | Linux CentOS/RHEL / Windows 11 Pro |
关键洞察:HyperMesh的前处理阶段高度依赖CPU单核性能(几何清理、网格划分算法多为串行),而求解阶段则依赖多核并行。这种"单核+多核"的双重需求,对工作站CPU的架构设计提出了独特挑战。
二、AI大模型赋能CAE工程智能
2.1 CAE工程智能化的三大方向
AI大模型正在重塑传统CAE工程流程,形成"仿真驱动设计"向"AI驱动仿真"的范式转变:
| 智能化方向 | 传统方式 | AI大模型增强方案 | 技术实现 |
|---|---|---|---|
| 智能网格划分 | 工程师手动调整网格参数、反复试错 | 自然语言描述→自动网格生成 | 几何LLM + 强化学习网格策略 |
| 生成式设计 | 拓扑优化需多次迭代、人工后处理 | 文本/草图→可直接制造的3D方案 | 3D生成大模型(Point-E/SDFusion) |
| 仿真结果预测 | 每次设计变更需重新求解(数小时~数天) | 秒级预测新方案的应力/变形/模态 | 神经算子(FNO/DeepONet) + 代理模型 |
| 报告智能生成 | 人工撰写仿真报告、提取关键结论 | 自动分析结果、生成专业报告 | 多模态LLM + CAE知识图谱 |
| 故障根因分析 | 依赖专家经验排查失效模式 | 自动关联设计参数与失效概率 | 因果推理大模型 + 历史案例库 |
2.2 CAE领域大模型的本地化部署价值
工程仿真数据涉及产品核心设计参数、材料性能、工艺秘密,云端部署存在严重的知识产权泄露风险。本地部署的核心价值:
- 数据主权:几何模型、仿真结果、优化方案完全留存在本地
- 低延迟交互:设计师与AI助手实时对话,秒级生成设计建议
- 离线可用:无外网环境下的独立工作能力
- 领域适配:基于企业历史仿真数据持续微调,形成专属设计智能
三、CAE+AI混合负载的算力需求特征
3.1 双重工作负载画像
当HyperMesh CAE仿真与AI大模型部署在同一工作站时,系统面临两类截然不同的计算负载:
| 工作负载类型 | 计算特征 | 显存需求 | 典型模型/任务规模 | 延迟要求 |
|---|---|---|---|---|
| HyperMesh前处理 | 单线程交互、几何布尔运算 | 2-4 GB(显存) | 百万级曲面、千万级网格 | <100ms交互响应 |
| HyperMesh求解 | 多核并行、稀疏矩阵求解 | 纯CPU计算 | 百万自由度~亿级自由度 | 分钟~小时级 |
| 3D生成式设计 | 扩散模型推理、高分辨率生成 | 12-24 GB | Point-E / SDFusion 1B-3B | <10s/方案 |
| 仿真代理模型 | 神经算子推理、时序预测 | 8-16 GB | FNO / DeepONet 50M-500M | <1s/预测 |
| 智能报告生成 | 长文本生成、多模态理解 | 16-48 GB | LLaMA-3 / Qwen2 7B-70B | <5s/报告 |
| 领域微调训练 | 企业数据适配、LoRA训练 | 24-80 GB | 7B-13B参数 LoRA/QLoRA | 小时级 |
3.2 混合负载硬件瓶颈分析
| 组件 | CAE仿真瓶颈 | AI大模型瓶颈 | 混合场景影响 |
|---|---|---|---|
| CPU | 单核主频决定前处理流畅度;多核决定求解速度 | 数据预处理、Tokenizer、后处理 | 需兼顾高主频与多核心 |
| GPU | 后处理可视化、GPU加速求解(OptiStruct) | 模型推理/训练核心算力 | 显存容量成为最大约束 |
| 内存 | 大型装配体网格数据驻留 | 模型权重、KV Cache、数据集 | 128GB起步,512GB为佳 |
| 存储 | 大型结果文件(数十GB)读写 | 模型权重(数十GB)、训练数据 | NVMe SSD为刚需 |
| 散热 | 长时间满负载求解(数小时) | GPU持续高功耗推理/训练 | 稳定性与噪音平衡 |
四、UltraLAB硬件配置选型指南
4.1 UltraLAB产品矩阵与CAE+AI场景匹配
| 系列定位 | 典型型号 | 核心特征 | 适用场景 |
|---|---|---|---|
| 专业设计型 | A350系列 | 高主频单路CPU、静音、紧凑 | 设计师个人工作站、HyperMesh前处理 |
| 工程仿真型 | GR450P系列 / EX660/EA660系列 | 双路Xeon/Threadripper、大内存 | CAE求解密集型、多工况并行 |
| AI仿真融合型 | AlphaPro660系列 / GA650M系列 | 双路CPU+双卡/四卡GPU、均衡配置 | CAE+AI混合负载、设计与分析一体 |
| 数据中心型 | GX660M系列 | 多节点IB网络、并行文件系统 | 企业级代理模型训练、生成式设计 |
4.2 关键硬件组件选型原则
CPU选型:CAE前处理的单核性能 vs AI的多核预处理
| 平台 | 推荐型号 | 核心/线程 | 基频/睿频 | 内存通道 | 适用场景 |
|---|---|---|---|---|---|
| Intel 高主频单路 | Core Ultra 9 285K / Ultra 270K | 24C/24T | 3.5/5.5 GHz | 2通道DDR5 | 纯前处理、交互设计 |
| Intel 均衡仿真 | Xeon W7-2475X | 20C/40T | 3.5/5.1 GHz | 4通道DDR5 | 前后处理+中等规模求解 |
| Intel 双路扩展 | 2×Xeon 6530 / 2×Xeon 8592+ | 64C/128T~128C/256T | 2.7/3.9 GHz | 16通道DDR5 | 大规模并行求解、多工况 |
| AMD 高主频 | Ryzen 9 9950X3D | 16C/32T | 4.3/5.7 GHz | 2通道DDR5 | 游戏级主频、性价比之选 |
| AMD 仿真+AI | Threadripper PRO 7995WX / 2×EPYC 9755 | 96C/192T~256C/512T | 2.5/4.8 GHz | 8-12通道DDR5 | 超大内存、多核均衡 |
选型要点:HyperMesh前处理对CPU单核主频极度敏感,建议选择睿频≥5.0GHz的处理器;若求解任务占比高,则优先多核心。UltraLAB GR450P/EX660系列支持双路AMD EPYC/Xeon,可兼顾两者。
GPU选型:从可视化到AI推理的跨越
| 应用场景 | 推荐GPU | 显存 | 算力(FP16) | 关键特性 | 单卡功耗 |
|---|---|---|---|---|---|
| HyperMesh后处理可视化 | NVIDIA RTX 5060 Ti / RTX 5070 Ti | 16 GB | — | ISV认证、稳定驱动 | 180-285W |
| CAE+轻量AI推理 | RTX 5080 16GB / RTX 5090D 32GB | 16-32 GB | 高Tensor Core吞吐 | 高性价比、INT4量化 | 360-450W |
| 专业CAE+AI融合 | RTX Pro 5000 72GB / RTX Pro 6000 96GB | 72-96 GB | 专业级算力 | ISV认证、大显存、ECC | 300-400W |
| 企业级AI训练 | A100 80GB / H100 80GB | 80 GB | 312-989 TFLOPS | NVLink、Transformer Engine | 400-700W |
关键提示:若工作流以HyperMesh前后处理为主、AI为辅,推荐RTX Pro系列专业卡(ISV认证驱动稳定性高);若AI训练推理占比高,则RTX 5080/5090D性价比更优。CAE+AI融合场景建议显存≥24GB。
内存与存储配置
| 配置等级 | 内存容量 | 内存类型 | 系统盘 | 数据盘 | 适用场景 |
|---|---|---|---|---|---|
| 个人设计师 | 64-128 GB | DDR5-5600 | 2TB NVMe Gen4 | 4TB SSD | HyperMesh前处理、中小模型 |
| 仿真工程师 | 128-256 GB | DDR5-4800 ECC | 4TB NVMe Gen5 | 8TB NVMe SSD | 大规模求解、多工况 |
| CAE+AI融合 | 256-512 GB | DDR5-4800 ECC RDIMM | 4TB NVMe Gen5 | 16TB NVMe SSD RAID | 混合负载、企业数据 |
| 数据中心 | 512 GB-1 TB | DDR5-4800 ECC RDIMM | 8TB NVMe Gen5 | 全闪存阵列 | 大规模训练、多用户 |
HyperMesh特别提示:大型整车碰撞模型(千万级网格)求解时,内存占用可达100GB+。建议内存容量为模型规模的3-5倍,以确保求解过程中不发生内存溢出。
五、软件清单与工具链
5.1 CAE仿真软件栈
| 软件层级 | 软件组件 | 版本/厂商 | 功能说明 |
|---|---|---|---|
| 前处理 | HyperMesh | Altair 2024+ | 几何清理、网格划分、模型装配 |
| 求解器 | OptiStruct / Radioss / Abaqus / Nastran | 各厂商最新版 | 线性/非线性结构分析、显式动力学 |
| 后处理 | HyperView / ParaView | Altair / Kitware | 结果可视化、云图、动画 |
| 拓扑优化 | OptiStruct / Inspire | Altair | 生成式设计、拓扑优化 |
| 多物理场 | STAR-CCM+ / Fluent / COMSOL | Siemens / ANSYS / COMSOL | CFD、热分析、电磁场 |
5.2 AI大模型推理与训练框架
| 框架 | 适用场景 | 核心优势 | 推荐版本 |
|---|---|---|---|
| TensorRT | 生产级推理加速 | 极致性能、INT8/FP8量化 | 9.0+ |
| vLLM | 高并发报告生成服务 | PagedAttention、高吞吐 | 0.5.x+ |
| PyTorch | 模型训练与微调 | 生态完善、动态图灵活 | 2.3+ |
| JAX + Flax | 神经算子研究 | 自动微分、XLA编译加速 | 0.4+ |
| ONNX Runtime | 跨平台推理部署 | 模型格式统一、硬件无关 | 1.18+ |
| Ollama | 本地快速体验 | 一键部署、简易API | 0.3.x+ |
5.3 CAE+AI专用工具链
| 工具类型 | 推荐工具 | 功能描述 |
|---|---|---|
| 3D生成式设计 | Point-E / SDFusion / MeshGPT | 文本/草图→3D模型生成 |
| 神经算子 | NeuralOperator (FNO/DeepONet) | 偏微分方程快速求解、代理模型 |
| 几何深度学习 | PyTorch3D / Kaolin | 3D形状分析、网格处理 |
| CAD接口 | OpenCASCADE / PythonOCC | CAD几何引擎、参数化建模 |
| 数据管理 | SimData Management / PLM | 仿真数据版本管理、知识沉淀 |
| 可视化 | NVIDIA Omniverse / ParaView | 大规模数据可视化、协同评审 |
| 知识图谱 | Neo4j + LLM RAG | 仿真知识库、智能问答 |
5.4 CAE领域AI模型生态
| 模型类型 | 代表模型/架构 | 应用场景 | 参数规模 |
|---|---|---|---|
| 几何理解 | PointTransformer / PointNet++ | 3D点云分类、分割、特征提取 | 1M-50M |
| 网格生成 | MeshGPT / PolyGen | 自动网格划分、质量优化 | 10M-100M |
| 物理场预测 | FNO (Fourier Neural Operator) | 流场、应力场快速预测 | 1M-50M |
| 生成式设计 | SD-Fusion / Point-E | 概念设计生成、拓扑优化初始化 | 100M-1B |
| 报告生成 | LLaMA-3 / Qwen2 / CodeLlama | 仿真报告撰写、Python脚本生成 | 7B-70B |
| 多模态分析 | LLaVA-1.6 / Qwen-VL | 仿真云图理解、缺陷识别 | 7B-72B |
六、应用场景与配置推荐
6.1 场景一:个人设计师——HyperMesh前后处理+轻量AI辅助
需求特征:
- 以HyperMesh几何清理、网格划分为主
- 偶尔使用AI生成初始设计方案、自动撰写报告
- 预算有限,追求性价比
- 办公环境,对噪音敏感
UltraLAB推荐配置:
| 组件 | 规格 | 选型理由 |
|---|---|---|
| 机型 | A35015064-MBX(¥36,000) | 紧凑静音塔式,适合办公桌面 |
| CPU | Intel Ultra 5 265K(20核,8性能核5.1GHz) | HyperMesh前处理极致流畅 |
| GPU | RTX 5060 Ti 16GB | 兼顾可视化与7B模型推理,性价比高 |
| 内存 | 64 GB DDR5 | 满足百万级网格模型处理 |
| 存储 | 4TB NVMe Gen4 + 8TB SATA | 快速加载大型模型文件 |
| 显示器 | 27英寸 2K | 大视野几何显示 |
| 散热 | 塔式静音风冷 | 办公环境噪音≤30dB |
升级路径:若需更强AI推理能力,可升级至A35015396-MCT(AMD 9950X3D 16核5.7GHz + RTX 5090D 32GB水冷 + 96GB内存,¥89,990),支持32B模型INT4量化推理。
6.2 场景二:仿真工程师——大规模求解+AI代理模型
需求特征:
- 频繁运行千万级网格规模的求解任务
- 使用神经算子构建仿真代理模型,加速设计迭代
- 多工况并行计算需求
- 需要长时间稳定运行(数小时~数天)
UltraLAB推荐配置:
| 组件 | 规格 | 选型理由 |
|---|---|---|
| 机型 | GR450P150128-MCX(¥128,000) | 双路平台,大内存扩展,双冷排水冷 |
| CPU | AMD Threadripper PRO 7975WX(32核5.0GHz) | 32核64线程,兼顾主频与多核 |
| GPU | RTX 5080 16GB ×1 | 大显存支撑代理模型训练 |
| 内存 | 128 GB DDR5-4800 ECC RDIMM | 千万级网格求解不溢出 |
| 存储 | 4TB NVMe Gen5 + 8TB SATA | 高速读写大型结果文件 |
| 散热 | 双冷排全水冷 | 长时间满载稳定运行 |
升级路径:若需更大内存支持亿级自由度,可选GR450P150192-MCX(AMD 7980X 64核5.0GHz + 192GB内存 + RTX 4000 Ada 20GB,¥145,000);若需AI训练能力,可选GR450P150192-MCT(同CPU + RTX 5090D 32GB水冷,¥192,000)。
6.3 场景三:CAE+AI融合中心——设计仿真智能一体化
需求特征:
- 设计团队与仿真团队共享算力资源
- 运行13B-70B多模态大模型,支持智能设计、报告生成
- 多用户并发访问,资源动态调度
- 企业数据安全,完全本地部署
UltraLAB推荐配置:
| 组件 | 规格 | 选型理由 |
|---|---|---|
| 机型 | EX660 229512-MCD(¥385,000) | 双路CPU+双GPU,均衡融合,支持机架转换 |
| CPU | 2×Xeon Platinum 8592+(128核) | 128核256线程,多用户并发求解 |
| GPU | RTX Pro 5000 48GB ×2 | NVLink互联,大模型推理+可视化 |
| 内存 | 512 GB DDR5-4800 ECC RDIMM | 超大规模模型+多用户缓存 |
| 存储 | 4TB NVMe Gen5 + 20TB SATA | 高IOPS支撑并发访问 |
| 网络 | 双25GbE | 企业内网高速数据共享 |
| 虚拟化 | VMware vSphere / Proxmox | 资源池化、动态分配 |
高端替代:若需四卡AI训练能力,可选GA650M 235640-MC4A(2×AMD 75F3 64核3.5GHz + 640GB内存 + 4×A100 80GB水冷,¥620,000),支持70B模型LoRA微调。
6.4 场景四:企业级AI训练中心——生成式设计模型进化
需求特征:
- 全参数微调13B+多模态设计模型
- 训练企业专属的生成式CAD/CAE模型
- 多项目并行训练
- PB级历史仿真数据存储与检索
UltraLAB推荐配置:
| 组件 | 规格 | 选型理由 |
|---|---|---|
| 机型 | GX660M 2311T-ME4H(¥1,150,000) | 旗舰训练平台,双塔式全水冷 |
| CPU | 2×Xeon Gold 6530(64核2.7GHz) | 最高PCIe带宽,8卡全速 |
| GPU | H20 141GB NVLink ×4 | 最大显存、Transformer Engine |
| 内存 | 1 TB DDR5-4800 ECC | 大规模数据并行 |
| 存储 | 4TB NVMe Gen5 + 20TB SATA | 并行文件系统 |
| 网络 | InfiniBand NDR 400G | 多节点扩展 |
性价比替代:若预算有限但仍需强大训练能力,可选GA650M 235768-MC4F(2×AMD 75F3 64核 + 768GB内存 + 4×RTX Pro 6000 96GB,¥920,000),支持虚拟化与私有云部署。
七、常见问题与硬件配置分析
7.1 HyperMesh前处理卡顿:几何清理与网格划分缓慢
问题现象:导入大型装配体后旋转/缩放卡顿;网格划分进度条长时间停滞;布尔运算失败。
根因分析:
- HyperMesh前处理算法(几何清理、面网格生成)多为单线程,依赖CPU单核性能
- 复杂曲面(如汽车整车、航空发动机)数据量巨大,内存不足导致频繁换页
- 机械硬盘I/O瓶颈,模型加载耗时数分钟
UltraLAB解决方案:
| 策略 | 配置调整 | 效果 | 成本 |
|---|---|---|---|
| 升级高主频CPU | 睿频≥5.5GHz(Ultra 285K/9950X3D) | 前处理速度提升30-50% | 中 |
| 扩容内存 | 128GB+,确保模型全内存驻留 | 消除磁盘换页,交互流畅 | 中 |
| 系统盘换SSD | NVMe Gen4/Gen5 SSD作为系统+软件盘 | 启动/加载速度提升5-10倍 | 低 |
| 使用专业显卡 | RTX Pro系列(ISV认证驱动) | 图形稳定性提升,减少崩溃 | 中 |
| 模型轻量化 | 简化不必要的几何细节 | 从根本上降低负载 | 零 |
7.2 求解任务内存溢出:千万级网格无法求解
问题现象:OptiStruct/Radioss求解至中途报错"Out of Memory";系统频繁使用虚拟内存,求解时间暴增。
根因分析:
- 求解器内存需求与自由度数量正相关,千万级网格模型需100GB+内存
- 多工况并行时内存需求成倍增加
- 内存通道不足导致带宽瓶颈
UltraLAB解决方案:
| 优化层 | 具体措施 | 预期提升 |
|---|---|---|
| 内存扩容 | 升级至256-512GB ECC RDIMM | 支持亿级自由度求解 |
| 多通道内存 | 8通道DDR5(Threadripper/EPYC) | 内存带宽提升2-4倍 |
| 分布式求解 | 多机MPI并行(OptiStruct支持) | 突破单机内存上限 |
| 模型简化 | 子模型技术、超单元法 | 降低自由度数量 |
| 求解器设置 | 调整内存管理参数、使用迭代求解器 | 降低内存峰值占用 |
7.3 AI模型推理延迟高:报告生成等待时间长
问题现象:使用大模型生成仿真报告时,响应时间>30秒;多用户并发时系统卡死。
根因分析:
- 13B+模型在CPU上推理,速度极慢(数token/秒)
- 单卡显存不足,无法加载大模型
- 缺乏批处理优化,每次请求独立加载
UltraLAB解决方案:
| 策略 | 配置调整 | 效果 |
|---|---|---|
| GPU推理加速 | RTX 5080/RTX Pro 5000运行vLLM | 速度提升50-100倍 |
| 模型量化 | INT8/INT4量化(TensorRT/AWQ) | 显存减半,速度提升2-4倍 |
| 推理服务化 | vLLM/Ollama常驻服务 | 避免重复加载,支持并发 |
| 显存扩容 | 升级48GB+专业卡 | 支持更大模型或更长上下文 |
| 模型蒸馏 | 使用7B小模型替代70B大模型 | 速度提升10倍,精度可接受 |
7.4 CAE+AI混合负载资源冲突
问题现象:同时进行HyperMesh求解和AI训练时,系统响应极慢;GPU被AI训练占满,后处理可视化卡顿。
根因分析:
- CPU核心争夺:求解器占用全部核心,AI数据预处理无资源
- GPU显存争夺:AI训练占满显存,后处理无显存可用
- 内存带宽饱和:CAE数据搬运与AI数据预处理争抢带宽
UltraLAB解决方案:
| 层级 | 优化措施 | 实现方式 |
|---|---|---|
| CPU隔离 | 求解器绑定特定NUMA节点,AI使用其余核心 | numactl/taskset进程绑定 |
| GPU分区 | 双卡配置,一卡专用于CAE可视化,一卡用于AI | NVIDIA MIG / 物理隔离 |
| 内存分配 | 大容量内存(512GB+)确保双方不溢出 | 硬件扩容 |
| 任务调度 | 错峰运行,求解夜间跑,AI白天交互 | 作业调度系统(Slurm) |
| 虚拟化隔离 | CAE与AI分虚拟机运行,资源硬隔离 | VMware/KVM + GPU直通 |
7.5 存储I/O瓶颈:大型结果文件读写缓慢
问题现象:求解结果文件(数十GB)导入HyperView耗时极长;后处理旋转云图卡顿。
根因分析:
- 机械硬盘顺序读取仅200MB/s,大型文件加载需数分钟
- 结果文件为二进制大文件,随机访问性能差
- 网络存储(NAS)带宽不足,多用户并发时更慢
UltraLAB解决方案:
| 策略 | 配置 | 效果 |
|---|---|---|
| 全NVMe存储 | 系统+数据盘均使用NVMe Gen4/Gen5 SSD | 读取速度>5GB/s,加载时间缩短10倍 |
| RAID0阵列 | 多块NVMe SSD组RAID0 | 线性提升带宽 |
| 本地缓存 | 结果文件先拷贝至本地NVMe,再后处理 | 避免网络存储瓶颈 |
| 数据分级 | 热数据NVMe、温数据SSD、冷数据HDD | 成本与性能平衡 |
7.6 成本与性能平衡决策
| 预算等级 | 核心矛盾 | 推荐策略 | UltraLAB配置要点 |
|---|---|---|---|
| <5万 | 基础HyperMesh前后处理 | 高主频CPU+中端GPU+64GB内存 | A35014832-MBX(¥25,500)或A35015064-MBX(¥36,000) |
| 5-15万 | 中大型模型求解+轻量AI | 多核CPU+大内存+专业GPU | GR450P15064-MCT(¥108,000)或GR450P150128-MCX(¥128,000) |
| 15-50万 | CAE+AI融合、多用户 | 双路CPU+双GPU+512GB内存 | EX660 229512-MCD(¥385,000) |
| >50万 | 企业级训练、生成式设计 | 四卡/八卡A100/H100集群 | GA650M 235640-MC4A(¥620,000)起 |
结语
HyperMesh作为CAE领域的标杆前后处理软件,其硬件需求已从传统的"高主频CPU+大内存",演进为"CAE仿真+AI智能"的双重算力需求。工程师不仅需要流畅完成千万级网格的划分与求解,更需要借助AI大模型实现智能设计、快速预测和自动报告生成。
UltraLAB工作站以其从个人桌面到数据中心的全栈产品线——A350系列入门塔式、GR450P系列双路Threadripper、EX660/EA660系列双路EPYC/Xeon、AlphaPro660系列双塔式全水冷、GA650M系列四卡AI训练平台——以及对CAE ISV的认证支持、对AI工作负载的深度优化,为工程智能化转型提供了坚实的硬件底座。
无论是追求极致前处理流畅度的个人设计师,还是需要大规模求解与AI训练融合的企业研发中心,选择匹配自身工作流的UltraLAB配置,都是将仿真效率转化为产品竞争力的关键一步。
技术咨询与配置定制
如需针对HyperMesh及CAE+AI混合负载定制UltraLAB工作站方案,请联系专业顾问团队获取详细配置建议。
本文技术参数与报价基于UltraLAB 2026v3基准配置表,实际配置请以官方最新产品手册为准。


