






当“工业设计的大脑”开始国产化:本文基于湖南迈曦软件自主 CAE 产品体系(MxSim / MxDesign / MxCloud / MxSim.Edu),解析其高效非结构自主 CAE 核心算法与 GPU 异构并行计算特点,并按入门、标准、专业、旗舰四级给出 UltraLAB 图形工作站的选型方法、应用场景配置与常见问题硬件分析。
2026-10-09 | 作者:UltraLAB 方案团队 | 阅读约 12 分钟
目录
- 核心应用软件:MxSim 产品矩阵
- 核心算法:非结构自主求解 + GPU 异构并行
- 计算特点:负载决定硬件
- UltraLAB 硬件配置怎么选
- 应用场景与配置推荐
- 常见问题:硬件配置深度分析
- 结语与参考
一、核心应用软件:MxSim 产品矩阵
湖南迈曦软件有限责任公司成立于 2020 年 8 月,脱胎于湖南大学“高效非结构自主 CAE 软件核心算法、GPU 并行计算及优化设计平台”科技成果作价转化,团队 200 余人、研发占比 85% 以上,是中部地区唯一入选工信部优秀工业软件名单的 CAE 厂商,产品已进入中国一汽、比亚迪、华为、中航工业、中国商飞、中船重工等供应链。其产品体系覆盖“底层引擎 + 仿真 + 设计 + 云服务 + 教育”全链路:
| 产品 | 定位 | 主要负载类型 | 典型用户 | 硬件需求侧重 |
|---|---|---|---|---|
| MxSim | 自主 CAE 仿真分析引擎(2025 年度工信部首版次软件,湖南唯一上榜) | 结构强度、疲劳寿命、碰撞、爆炸冲击、多物理场耦合 | 车企、航空航天、船舶、装备制造企业 | 高主频 + 大内存 + 大显存 GPU 并行 |
| MxDesign | 优化设计平台 | 多工况批量求解、代理模型寻优、设计迭代 | 研发中心、设计院所 | 多核并发、任务调度、大内存 |
| MxCloud | 云端仿真服务 | 弹性算力、多人协同、远程前后处理 | 集团级仿真中心、高校平台 | 服务器/集群、IB 网络、并行存储 |
| MxSim.Edu | 教育版 | 教学案例、课程实验、轻量建模与求解 | 高校、职校、学生个人 | 高主频 CPU、中端 GPU、静音 |
二、核心算法:非结构自主求解 + GPU 异构并行
迈曦的技术底座由湖南大学崔向阳教授团队十余年积累(约 40 万行代码)打磨而成,三项核心算法直接决定了其对硬件的“口味”:
| 核心算法 | 技术要点 | 对硬件的直接要求 |
|---|---|---|
| 高效非结构自主 CAE 核心算法 | 面向复杂几何的非结构网格离散求解,覆盖强冲击、爆炸、多物理场耦合等极端工况 | 内存容量与带宽敏感;稀疏矩阵运算受益于大缓存(L3)处理器 |
| 三角形网格算法精度突破 | 国际上首次解决基于三角形网格的算法精度问题,降低前处理网格门槛 | 非结构前处理为单线程串行为主 → 依赖 CPU 单核高频 |
| GPU 异构并行 CAE 计算 | 国内较早系统化研究 GPU 异构并行求解的团队,求解器可 offload 至 GPU | 大显存 GPU(≥16GB,建议 32GB+)+ 高 PCIe 带宽 + 稳定驱动 |
三、计算特点:负载决定硬件
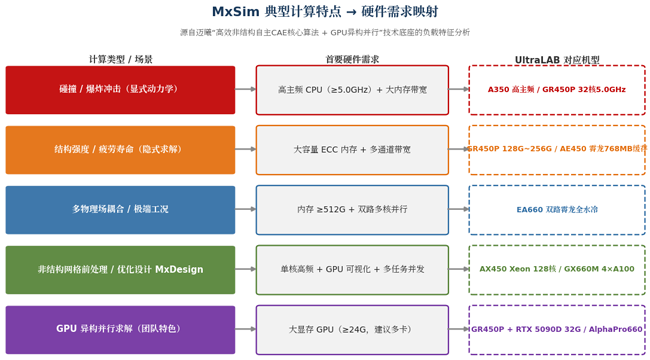
从公开工程实践看,MxSim 的求解负载可分为四类,硬件敏感点各不相同——选型的第一原则是“先分清自己的主负载”:
| 计算类型 | 典型场景 | 首要瓶颈 | 次要瓶颈 |
|---|---|---|---|
| 显式动力学 | 整车碰撞、爆炸冲击、强冲击防护 | CPU 单核频率(时间步积分) | 内存带宽、GPU 并行 offload |
| 隐式求解 | 结构强度、静刚度、疲劳寿命 | 内存容量(刚度矩阵驻留) | 内存通道数、L3 缓存 |
| 多物理场耦合 | 热-力-流耦合、极端工况可靠性 | 内存容量(≥512GB 级) | 双路多核并行、稳定散热 |
| 前处理/优化 | 非结构网格划分、MxDesign 批量寻优 | 单核高频(交互与网格) | 核心数(多工况并发)、GPU 可视化 |
四、UltraLAB 硬件配置怎么选
4.1 先选平台,再定配置
| 系列 | 核心特征 | 匹配 MxSim 负载 | 价格区间(2026v3) |
|---|---|---|---|
| A350 超频图形工作站 | Intel Ultra 高主频(睿频 4.8~5.6GHz)、静音紧凑 | MxSim.Edu 教学、前后处理、轻量求解 | ¥25,500 ~ 52,000 |
| GR450P 极致超频工作站 | AMD TR 32 核 5.0GHz、全水冷、大内存扩展 | 碰撞/爆炸显式求解、结构强度、GPU 并行 | ¥92,000 ~ 198,000 |
| AE450 / AX450 水冷工作站 | 霄龙 768MB 超大 L3 / Xeon 最高 128 核 | 隐式大模型、疲劳寿命、多工况并发 | ¥59,990 ~ 275,000 |
| EA660 全水冷双路 | 双路霄龙最高 256 核、512GB~768GB 内存 | 多物理场耦合、整机/整车级全尺度仿真 | ¥89,990 ~ 420,000 |
| GX660M / AlphaPro660 | 4×A100 / 4×RTX Pro 6000 多卡、1TB 级内存 | GPU 异构大规模并行、MxCloud 私有算力池 | ¥142,000 ~ 1,150,000 / ¥330,000 ~ 999,900 |
4.2 四级配置推荐(2026v3 基准)
| 等级 | CPU | GPU | 内存 / 存储 | 参考机型与报价 |
|---|---|---|---|---|
| 入门版 | Intel Ultra 9-285K(24 核,8P 核 5.6GHz) | RTX 5060 8GB / RTX A2000 | 64~96GB DDR5 / 4TB NVMe + 8TB SATA | A35015064-MBX(约 ¥36,000) |
| 标准版 | AMD TR-7970X(32 核 5.0GHz) | RTX 5080 16GB | 128GB DDR5 / 4TB NVMe + 8TB SATA,全水冷 | GR450P150128-MCX(约 ¥128,000) |
| 专业版 | 霄龙 9755(128 核 4.1GHz,512MB L3)/ Xeon 6980P(128 核) | RTX 5090D 32GB / RTX Pro 5000 48GB | 256GB ECC / 4TB NVMe Gen5 | AE450141256-MCX(约 ¥165,000)/ AX450 系列 |
| 旗舰版 | 2×霄龙 9755(256 核) | 4×A100 80GB / 4×RTX Pro 6000 96GB,NVLink | 512GB~1TB ECC / 8TB NVMe(14GB/s)+ 20TB SATA | EA660235512-MCX(约 ¥252,000)/ GX660M235640-MD4A(约 ¥620,000) |
4.3 关键组件选型原则
| 组件 | 选型原则 | 推荐基准 |
|---|---|---|
| CPU | 前处理与显式求解吃单核频率;隐式与多工况吃核心数;大 L3 缓存加速 FEM 稀疏矩阵 | 主频 ≥5.0GHz;求解占比高选 32 核起步;多物理场上双路 |
| GPU | 迈曦 GPU 异构并行 + 结果可视化 + AI 辅助三位一体,显存是第一瓶颈 | 单机 ≥16GB,建议 32GB;并发/训练多卡 NVLink |
| 内存 | 容量 ≈ 模型规模的 3~5 倍;8 通道带宽对隐式求解提速显著;必须 ECC | 教学 64GB / 工程 128~256GB / 耦合 512GB+ |
| 存储 | 网格文件与结果文件(数十 GB 级)随机访问频繁,NVMe 不可或缺 | 系统+工作目录 NVMe Gen4/Gen5 ≥2TB,归档配 SATA 大容量 |
| 散热/电源 | CAE 是数天级满载长跑,降频=算力腰斩 | 全水冷、冗余电源、双塔风道(UltraLAB 全系水冷方案) |
五、应用场景与配置推荐
场景一:高校教学与科研(MxSim.Edu)
需求特征:课程实验、竞赛、小模型求解,预算敏感、环境安静。
| 项目 | 推荐 | 理由 |
|---|---|---|
| 机型 | A35015064-MBX(约 ¥36,000) | 高主频保障交互流畅,静音塔式适合实验室 |
| CPU / GPU / 内存 | Ultra 9-285K / RTX 5060 / 64GB | 覆盖教学全负载,预留扩展余量 |
场景二:汽车/装备企业仿真工程师(碰撞·强度·疲劳)
需求特征:千万级网格整车/部件模型,显式+隐式混合,长时间满载。
| 项目 | 推荐 | 理由 |
|---|---|---|
| 机型 | GR450P150128-MCX(约 ¥128,000) | 32 核 5.0GHz 黄金平衡点,全水冷 7×24 稳定 |
| CPU / GPU / 内存 | TR-7970X / RTX 5080 16GB / 128GB | 显式求主频、隐式求内存,两头兼顾 |
| 升级路径 | GPU 升 RTX 5090D 32GB;内存升 256GB | 支撑 GPU 异构并行与更大自由度 |
场景三:航空航天/船舶多物理场耦合
需求特征:极端工况、热-力-流耦合、亿级自由度,内存与稳定性为王。
| 项目 | 推荐 | 理由 |
|---|---|---|
| 机型 | EA660235512-MCX(约 ¥252,000) | 双路 256 核 + 512GB ECC,双塔水冷满载不降频 |
| CPU / GPU / 内存 | 2×霄龙 9755 / RTX 5090 32GB / 512GB | 多物理场耦合的内存容量与并行算力一次到位 |
场景四:集团仿真中心 / MxCloud 私有算力池(MxDesign 批量优化)
需求特征:多用户并发、批量工况排队、GPU 异构大规模并行、数据不出内网。
| 项目 | 推荐 | 理由 |
|---|---|---|
| 机型 | GX660M235640-MD4A(约 ¥620,000) | 4×A100 80GB NVLink + 640GB 内存,多模型/多工况并发 |
| 网络/调度 | 40G 以太网 / IB + 作业调度系统 | 对接 MxCloud,弹性分配、夜间批量 |
| 替代方案 | AlphaPro660 系列(约 ¥515,000 起) | 超大内存 + 专业卡,兼顾可视化与推理 |
六、常见问题:硬件配置深度分析
Q1:MxSim 前处理与网格划分卡顿,该升级什么硬件?非结构网格的几何清理与网格生成以单线程串行为主。首要升级高主频 CPU(睿频 ≥5.0GHz,如 TR-7970X / Ultra 9-285K),内存 ≥128GB 保证模型全内存驻留,工作目录迁至 NVMe Gen4/Gen5 SSD。实测前处理环节高主频平台可带来 30%~50% 的交互提速。
Q2:整车碰撞、爆炸冲击大模型求解内存溢出怎么办?显式求解内存与自由度正相关,千万级网格建议内存为模型规模的 3~5 倍(256GB~512GB ECC);优先 8 通道平台(TR PRO/EPYC)补带宽;超大规模转 EA660 双路或 MxCloud 云求解。同时可用子模型、质量缩放降低峰值占用。
Q3:迈曦 GPU 异构并行见长,GPU 到底该怎么选?GPU 并行求解、后处理可视化与 AI 辅助共享一块卡,显存是第一瓶颈:单机建议 RTX 5080 16GB 起步,千万级网格 GPU 加速或 70B 级 AI 辅助选 RTX 5090D 32GB;多卡并发选 GX660M(4×A100 80GB / 4×RTX Pro 6000 96GB,NVLink)。注意确认驱动版本与求解器 GPU 精度设置。
Q4:MxDesign 批量优化排队太久如何破局?优化设计=多工况并发调度问题。单机选多核高主频(GR450P 32 核 / AX450 128 核)+ 作业调度错峰运行;团队级以 EA660/GX660M 建私有算力池虚拟化切分,或直接对接 MxCloud 弹性扩展,夜间集中批量求解。
Q5:高校教学与学生学习 MxSim.Edu 该选哪款?A350 超频图形工作站(约 ¥25,500~36,000):高主频 CPU + 64GB 内存 + RTX 5060 级 GPU,流畅覆盖教学案例与小规模求解,静音设计适合机房与办公室。
Q6:为什么选 UltraLAB 而不是普通组装机?| 维度 | 普通组装机 | UltraLAB 工作站 |
|---|---|---|
| 满载稳定性 | 高负载降频、蓝屏风险 | 全水冷 7×24 小时满载设计 |
| 内存 | 无 ECC | ECC 纠错,防长时间仿真数据错误 |
| GPU 扩展 | 槽位/散热/电源受限 | 4 卡位 + 双塔水冷 + 大功率冗余电源 |
| 驱动与认证 | 消费级驱动偶发兼容问题 | ISV 级驱动稳定性、联合调优 |
| 售后 | 返厂周期长 | 3 年上门 + CAE 环境调优 + 远程测试 |
数十 GB 级结果文件是典型顺序+突发混合负载:系统盘与工作目录全 NVMe(Gen4/Gen5),热数据 NVMe、冷数据 SATA 分级;多人共享场景配合 40G/IB 网络与并行文件系统,避免 NAS 带宽成为瓶颈。
七、结语与参考
国产 CAE 正从“能用”走向“好用”:迈曦以 40 万行代码与 GPU 异构并行底座,把结构强度、疲劳寿命、碰撞、爆炸冲击与多物理场耦合的仿真能力交到工程师桌面。而算力是仿真生产力的放大器——前处理要快、求解要稳、并行要猛、长跑要冷。先分清主负载,再按四级配置对号入座,是让每一分硬件预算都转化为产品竞争力的关键。
参考信息
- 《国产芋头在星城·长沙打工人的求职情报站》第 64 期(微信公众号,迈曦软件公司背景与产品信息)
- 《UltraLAB 图形工作站基准配置表 2026v3》(机型、价格与配置参数)
- 工信部 2025 年度首版次软件名单、迈曦软件公开报道
免责声明:本文机型与价格基于 UltraLAB 2026v3 基准配置表整理,实际配置与报价以官方最新手册为准;迈曦 MxSim 相关软件信息以厂商官方文档为准。文中性能描述为工程经验值,具体以实测为准。本文不构成任何采购投资建议。


