






——从 HPC China 2026「解法器墙」报告到 UltraLAB 工作站落地配置
导读(TL;DR):2026 年 10 月 18 日,CCF 全国高性能计算学术大会(HPC China 2026)上,解得科技首席科学家刘伟峰在《异构计算新时代的高性能解法器》报告中提出「解法器墙」概念:CAE/EDA 等工业软件的核心是求解Ax=b,稀疏直接法运行时间近似与矩阵阶数平方成正比——10 万阶 1 秒、1000 万阶 2.78 小时、1 亿阶 11.6 天、10 亿阶 3.17 年。破解之道是把解法器搬到 GPU 上重做一遍。本文拆解三大核心算法(PanguLU / LinglongAMG / XianzhiKrylov)的计算特征,并给出对应的 UltraLAB 硬件选型方案。
一、核心内容分析:什么是「解法器墙」?
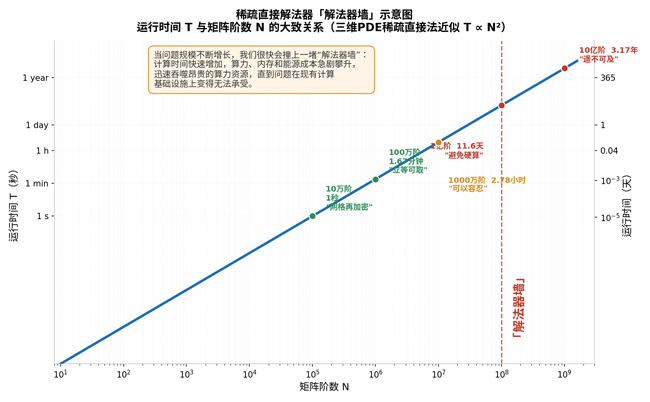
图 1:稀疏直接解法器「解法器墙」——运行时间随矩阵阶数近似平方增长
汽车气动仿真、飞机外流场、芯片电磁仿真、油藏数值模拟、血流动力学模拟……这些工业场景千差万别,底层却共享同一个核心问题:大规模稀疏线性方程组 Ax=b 的求解。求解放慢,整个工业软件就「撞墙」——算力、内存与能源成本急剧攀升,直到问题在现有计算基础设施上无法承受。
与此同时,硬件却给出了破局窗口:
| 硬件指标(GPU vs. CPU,数据中心级) | GPU 相对 CPU 提升 | 对解法器的意义 |
|---|---|---|
| 峰值 FP64 性能(矩阵运算) | 约 10 倍 | 稠密子矩阵计算(直接法消元核心)大幅加速 |
| 峰值 FP64 性能(向量运算) | 约 5 倍 | 迭代法 SpMV/向量更新获得数倍吞吐 |
| 峰值内存带宽 | 约 5 倍 | 稀疏计算是典型的带宽受限负载,受益最直接 |
结论很明确:GPU 的峰值算力和带宽都是 CPU 的 5–10 倍,GPU 上的稀疏解法器理应拿到同样的 5–10 倍性能。但稀疏矩阵结构复杂、访存不规则,要在 GPU 上真正释放性能,需要「重新发明解法器」——这正是 PanguLU、LinglongAMG、XianzhiKrylov 三款产品的出发点。
二、三大核心算法解析:直接法、多重网格与 Krylov 迭代
| 产品 | 算法类别 | 核心思想 | 复杂度特征 | 适用矩阵/场景 |
|---|---|---|---|---|
|
PanguLU 直接解法器 |
稀疏 LU 分解(稀疏高斯消元) | 对系数矩阵做 LU 分解:A = LU,前代回代求解;含重排序、填充控制与多级并行调度,面向 GPU 重新设计消元流水 | 三维 PDE 近似 O(N²),内存与带宽饥渴;但对病态矩阵稳健、结果可复现,多右端项成本极低 | 电路仿真(EDA)、结构力学、电磁场、需要高精度/多右端项的问题 |
|
LinglongAMG 代数多重网格解法器 |
代数多重网格(Algebraic Multigrid) | 无需几何网格信息,自动构造粗化层次,在粗网格上快速消除低频误差分量,迭代次数近似与问题规模无关 | 近线性复杂度 O(N),是超大模型(亿阶以上)的首选;对预处理质量与 GPU 访存模式敏感 | 油藏模拟、CFD 压力泊松方程、地球物理、千万/亿级自由度问题 |
|
XianzhiKrylov 迭代解法器 |
Krylov 子空间方法(CG/GMRES/BiCGStab 等) | 在 Krylov 子空间内最小化残差,每次迭代核心是稀疏矩阵-向量乘(SpMV)+ 预处理器;GPU 化后迭代吞吐成倍提升 | 每步代价低、访存带宽受限;收敛速度依赖预处理器与条件数 | 通用稀疏问题、特征值/特征向量求解、与 AMG 组合使用 |
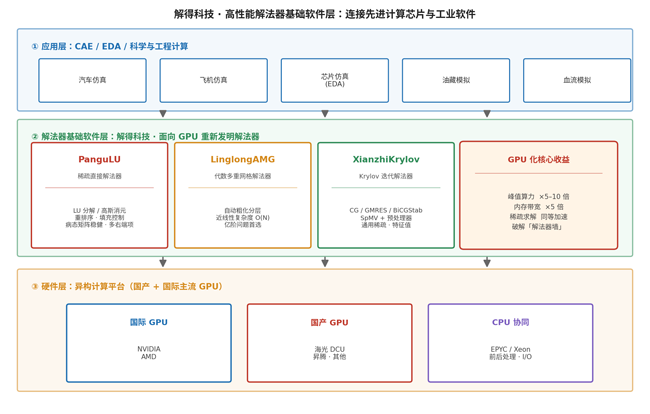
图 2:解得科技面向 GPU 构建的高性能解法器基础软件层(三类产品互补覆盖)
三、计算特点:稀疏求解负载的硬件画像
稀疏线性求解不是「堆核心数就行」的负载。要选对硬件,先看清它的四个计算特征:
| 计算特征 | 技术本质 | 对硬件的直接要求 |
|---|---|---|
| 内存带宽受限(Memory-Bound) | SpMV 与消元过程中计算/字节比极低,大量时间花在搬数据上 | 高 HBM 带宽 GPU 优先;CPU 平台需要 8–12 通道 DDR5/高带宽内存 |
| 不规则访存(Irregular Access) | 稀疏矩阵非零元分布无规律,缓存命中率低 | 大容量 L2/L3 缓存、高并行度掩盖延迟;GPU 需要定制内核与重排序算法 |
| 显存/内存容量敏感 | 直接法填充(Fill-in)使内存需求远超原始矩阵;10 万阶 → 千万阶,内存需求跨数量级增长 | 直接法优先大显存(48GB–80GB/卡);多 GPU NVLink 扩展显存池 |
| 多层级并行 + 通信敏感 | 消元树并行、网格分层并行、迭代内积全局归约 | NVLink/NVSwitch 全互联优于 PCIe;多机场景需要 IB/RoCE 低时延网络 |
四、应用场景:谁最需要这套算力?
| 行业场景 | 典型软件 | 主导算法 | 算力画像 |
|---|---|---|---|
| 汽车/航空航天 CFD 与结构仿真 | ANSYS Fluent/Mechanical、STAR-CCM+、OpenFOAM、Abaqus | AMG + Krylov(瞬态大模型)/ 直接法(中小模型、多工况) | 千万–亿级自由度,GPU 直接法单机极限约 1000 万阶 |
| 芯片 EDA 仿真 | Cadence Spectre、Synopsys、Sentaurus | 稀疏直接法(电路矩阵病态、需高精度) | PanguLU 类直接法,大显存单卡或多卡是关键 |
| 油藏/能源数值模拟 | Eclipse、tNavigator、自研模拟器 | AMG(黑油模型压力方程)+ Krylov | 亿级网格常态化,迭代法 + 大显存多卡 |
| 生物医学/血流模拟 | Ansys CFX、SimVascular、自研 FSI 求解器 | Krylov + AMG 预处理器 | 高分辨率网格,带宽敏感型 |
| 高校/科研院所算法研发 | PETSc、Trilinos、自研求解器 | 三类算法全谱系 | 需要灵活的 CPU+GPU 异构开发平台 |
五、UltraLAB 硬件配置怎么选:三级配置矩阵
根据上文的负载画像,我们把 UltraLAB 方案分为三档:单机入门型(模型验证/中小规模)、单机旗舰型(千万阶级生产仿真)、多机/集群型(亿阶以上持续生产)。选型逻辑一句话:直接法看显存容量,迭代法看带宽,规模看互联。
配置 A:单机入门型 —— 算法验证 / 百万阶以下模型
| 部件 | 推荐规格 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005 / Intel Xeon 6 系列,32–64 核 | 前后处理、网格剖分与 I/O 仍重度依赖 CPU 单线程与多核性能 |
| GPU | NVIDIA RTX 5880 Ada 48GB ×1–2 | 48GB 大显存可承载千万阶级稀疏直接法;双卡 NVLink 扩显存 |
| 内存 | DDR5 ECC 512GB(8–12 通道满配) | 直接法填充后矩阵可驻留内存,避免磁盘换页 |
| 存储 | 2TB NVMe Gen4 SSD(系统/软件)+ 4–8TB NVMe Gen4(算例库) | 千万自由度网格与结果文件动辄数百 GB,随机读写性能决定加载时间 |
| 网络/电源 | 10GbE / 2000W 冗余 | 算例数据远程传输与满载稳定性 |
配置 B:单机旗舰型 —— 千万阶级 CAE/EDA 生产仿真
| 部件 | 推荐规格 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005 系列,64–96 核 | 高内存通道数喂饱多 GPU;复杂前处理并行化 |
| GPU | NVIDIA RTX 6000 Ada 48GB ×4(NVLink 互联)或数据中心级 80GB 卡 ×2–4 | 千万阶三维 PDE 直接法需 1TB 级显存池;多卡消元树并行 |
| 内存 | DDR5 ECC 1TB–2TB | 重排序、符号分解与内存超定额换页的缓冲空间 |
| 存储 | 2TB NVMe Gen5(系统)+ 15.36TB NVMe U.2 ×2–4(并行算例 I/O) | 多工况批量仿真需要并发读写吞吐 |
| 散热/电源 | 机架式水冷或高风道机箱 / 2×3000W 冗余 | 4 卡满载 FP64 长时间运行,风冷噪音与温度是隐形瓶颈 |
配置 C:多机/集群型 —— 亿阶以上规模、7×24 生产
| 部件 | 推荐规格 | 选型理由 |
|---|---|---|
| 计算节点 | 同配置 B ×N 节点(3–8 台起步) | 分布式直接法(如 PanguLU 分布式版本)或并行 AMG 扩展 |
| 互联网络 | InfiniBand NDR 200/400Gb 或 100/200Gb RoCE | 迭代法内积归约与消元树通信对时延极度敏感,千兆网是灾难 |
| 共享存储 | 并行文件系统(Lustre/BeeGFS)100TB+ NVMe 层 | 亿阶模型文件 + 多节点并发 checkpoint |
| 调度系统 | Slurm / PBS Pro + 容器化运行环境 | 多用户多任务排队,GPU 利用率最大化 |
六、软件清单:从求解器到调度,一套配齐
| 层级 | 软件 | 用途 | 许可类型 |
|---|---|---|---|
| 核心解法器 | PanguLU | GPU 稀疏直接法(替代/超越 CPU 直接法库) | 商业 |
| LinglongAMG | GPU 代数多重网格,亿阶问题近线性求解 | 商业 | |
| XianzhiKrylov | GPU Krylov 迭代求解与特征值计算 | 商业 | |
| 开源生态(备选) | PETSc / Trilinos | 科研级 KSP/PC 框架,含 GPU 后端 | 开源(BSD) |
| cuSPARSE / hipSPARSE / rocSPARSE | NVIDIA/AMD GPU 稀疏线性代数基础库 | 随驱动/ROCm 免费 | |
| SuperLU_DIST / MUMPS(GPU 分支) | 分布式直接法基准对比 | 开源 | |
| AMGX / hypre(GPU) | NVIDIA AMG / LLNL 多重网格参考实现 | 开源 | |
| 行业应用 | ANSYS / Abaqus / STAR-CCM+ | 结构/流体 CAE,GPU 求解需对应版本许可 | 商业 |
| Cadence Spectre / Synopsys PrimeSim | EDA 电路仿真(矩阵直接法重度用户) | 商业 | |
| OpenFOAM / SU2 | 开源 CFD,可深度耦合自研 GPU 求解器 | 开源 | |
| 系统与调度 | Ubuntu 22.04 LTS / Rocky Linux 9 | 基础 OS,配套 CUDA/ROCm 驱动 | 开源 |
| NVIDIA HPC SDK / CUDA Toolkit | 编译器(nvcc/nvc++)与数学库 | 免费 | |
| Slurm / PBS Pro + Docker/Apptainer | 集群调度与容器化算例环境 | 开源/商业 | |
| 性能分析 | Nsight Systems / Nsight Compute | 定位 SpMV 带宽利用率与内核瓶颈 | 免费 |
七、常见问题(FAQ):硬件配置深度分析
Q1:我有一台 512GB 内存的双路服务器,还有必要上 GPU 吗?有,而且往往是质变。稀疏直接法在 CPU 上极易卡在访存带宽(内存带宽通常是 CPU 的 5–10 倍短板),典型三维 PDE 问题 GPU 直接法可提速 5–10 倍。判断方法很简单:记录当前模型求解时间与矩阵阶数,对照图 1 的 O(N²) 曲线推算升级后的求解时间,如果仍撞在「2.78 小时」以上的区间,GPU 化就是必选项,而不是可选项。
Q2:直接法(PanguLU)和迭代法(LinglongAMG/XianzhiKrylov),硬件配置有什么本质区别?直接法是「容量 + 带宽」双饥渴:LU 填充会使内存/显存占用数倍于原始矩阵,优先保证单卡大显存与显存池总量;迭代法是「带宽优先」:AMG/Krylov 每步主要是 SpMV,对容量要求温和,但极度依赖 HBM 带宽与多卡归约通信质量。经验配比:直接法每千万阶三维自由度建议预留 ≥192GB 显存;迭代法同规模 96–192GB 即可,但应把预算向更多 GPU、更高带宽与 NVLink 互联倾斜。
Q3:多卡之间用 PCIe 还是必须 NVLink?差多少?对稀疏求解,差别是「能用」和「好用」的区别。直接法的消元树并行、迭代法的全局内积归约都会产生大量小消息通信,PCIe 的时延和拓扑(常常经过 CPU/PCIe Switch 跳转)会让 GPU 空转等待。NVLink/NVSwitch 全互联可把多卡归约时延降低一个数量级。建议:≥3 卡直接法、≥4 卡迭代法,选 NVLink 机型;1–2 卡可接受 PCIe。
Q4:为什么我把任务放到 4 张卡上,速度反而不如 2 张卡?三种常见原因:① 矩阵阶数不足以喂饱 4 卡(低于千万阶时并行收益被通信吃光);② 使用了 PCIe 拓扑且跨 NUMA 通信;③ 求解器未开启多 GPU 模式或默认按卡切分了多个独立任务。对策:用 Nsight Systems 抓取一次运行,看 GPU 利用率与通信占比——通信占比超过 30%,就该降卡数或换 NVLink 平台,而不是继续加卡。
Q5:国产 GPU(如海光 DCU、昇腾等)能跑这类解法器吗?硬件怎么选?可以,且是明确的趋势。解得科技已明确面向国产与国际主流 GPU 双平台推进。国产平台选型要点:确认求解器提供对应后端(HIP/ROCm 或 CANN 移植版);优先选 HBM 带宽高、卡间互联带宽大的机型;编译工具链(HIP/clang 或毕昇编译器)与调优支持需要厂商配合验证。UltraLAB 可提供国产 GPU 平台的兼容性验证环境,建议先小规模 PoC 再定配置。
Q6:预算有限,先升 GPU 还是先升内存/存储?按瓶颈排序投入:① 若求解时间主导(计算瓶颈)→ 先升 GPU 显存与数量;② 若任务频繁 OOM 或频繁读写交换区 → 先升内存/显存容量;③ 若每轮算例加载/写结果要几十分钟 → 升 NVMe 并行 I/O。不要平均分配预算——稀疏求解的瓶颈高度集中,精准打击才有 ROI。
Q7:工作站和云 HPC 哪个更划算?取决于利用率:年运行时长超过 2000 小时、且有数据保密要求(军工、汽车主机厂、芯片设计)→ 自建 UltraLAB 工作站/集群 2–3 年 TCO 通常低于云;偶发大算例(每月几次)→ 云上弹性扩容更省。混合策略是目前主流:日常千万阶以内本地工作站跑,亿级任务上云或排队到集群。
结语:把「墙」变成「门」
「解法器墙」不是硬件不够快,而是算法没有跟上硬件。GPU 用 10 倍矩阵性能与 5 倍带宽重新划定了仿真的规模上限,而 PanguLU、LinglongAMG、XianzhiKrylov 这类为 GPU 重新发明的解法器,决定了你能吃到其中几成红利——剩下的部分,取决于你的硬件平台是否喂得饱它。选对 UltraLAB 工作站,让每一阶自由度都算得其所。
如需针对您的算例(矩阵阶数/非零元数/求解时限)做免费容量核算与配置方案,请联系 UltraLAB 应用工程团队。
参考资料:解得科技《异构计算新时代的高性能解法器:解得科技与产品体系》,HPC China 2026,2026-10-18,深圳。本文硬件配置为通用工程建议,具体以实际算例压测为准。


