






导语:在生物制药研发成本持续攀升、疾病机理日益复杂的今天,"虚拟筛选替代湿实验、AI 生成加速先导化合物优化"已成为行业共识。达索系统 BIOVIA 生物科学解决方案,以 Discovery Studio 分子建模与仿真、Generative Therapeutics Design AI 生成式药物设计、Discoverant 制造分析三大核心平台为支柱,构建了一条从靶点发现、分子设计、虚拟验证到工艺优化的全数字研发链路。而要驱动这套融合量子力学、分子动力学、机器学习与统计建模的复杂计算引擎,一套经过精准调优的高性能科学计算工作站,则是决定研发效率的关键基础设施。
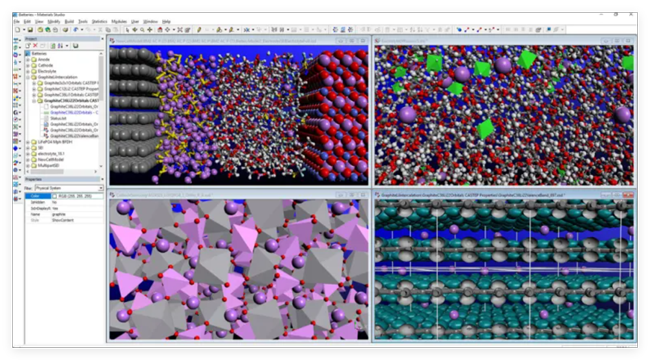
一、BIOVIA Discovery Studio:生命科学综合建模与仿真平台
BIOVIA Discovery Studio 是生物科学领域的旗舰级分子模拟环境,基于 BIOVIA Pipeline Pilot 服务器-客户端架构,整合了从蛋白质结构预测、分子动力学模拟到基于结构的药物设计等 30 余年学术积累的核心算法。2026 版本新增 OpenMM GPU 加速、mmCIF 多字符链名完全支持、GOLD v2025.1 对接引擎等增强功能。
1. 蛋白质建模与开发模块 —— 从序列到三维结构的精准预测
核心功能:
应用场景:未知结构靶点同源建模、抗体序列注释与全长结构预测、蛋白-蛋白相互作用位点识别、突变体稳定性评估。
2. 抗体设计与生物治疗开发模块 —— 从序列到可开发性的一站式方案
核心功能:
应用场景:抗体药物早期发现、生物类似药开发、制剂处方前研究、聚集效应预测与优化。
3. 分子动力学与自由能计算模块 —— 原子级相互作用的热力学快照
核心功能:
应用场景:药物-靶点结合机制研究、膜蛋白动态行为分析、蛋白质折叠/去折叠过程、配体解离路径预测、变构效应位点识别。
4. 基于结构与片段的药物设计模块 —— 虚拟筛选与先导优化
核心功能:
应用场景:高通量虚拟筛选、先导化合物骨架跃迁、ADMET 性质早期预测、毒性风险评估、组合化学库设计。
5. 量子力学与材料交叉模块 —— 电子结构层面的精准计算
核心功能:
应用场景:酶催化机理研究、金属配位中心电子结构、药物分子电荷分布与静电势分析、反应自由能面计算。
二、BIOVIA Generative Therapeutics Design:AI 驱动的小分子药物设计
核心模块:V+R 主动学习循环引擎
核心功能:GTD 是一款基于 3DEXPERIENCE 云的敏捷 AI 解决方案,将"虚拟生成-测试-打分-剪枝"循环与"真实合成-实验验证"循环深度融合,形成持续迭代的主动学习(Active Learning)闭环。
应用场景:激酶抑制剂从头设计、临床前候选化合物快速优化、专利规避结构创新、多靶点药物设计。
三、BIOVIA Discoverant:制造分析与流程优化平台
核心模块:数据驱动的制药 4.0 引擎
应用场景:生物制药批次偏差调查、工艺参数优化、稳定性趋势监控、全球制造网络协同、监管审计报告自动化。
四、BIOVIA 生物科学计算特点与硬件需求分析
BIOVIA 生物科学平台的计算负载呈现鲜明的"多模态并行"特征,不同模块对硬件的需求差异显著:
表格
| 计算模块 | 计算类型 | CPU 需求 | GPU 需求 | 内存需求 | 存储需求 |
|---|---|---|---|---|---|
| Discovery Studio 建模/对接 | 单线程/轻并行 | 高主频(>5.0GHz) | 可选 | 中等(32-64GB) | 中等 IOPS |
| CHARMm/NAMD MD 模拟 | 高度并行(GPU 加速) | 中等 | 必需(CUDA) | 大(显存+内存) | 高吞吐(轨迹文件) |
| DMol3 DFT 计算 | CPU 密集并行 | 多核(>32核) | 不支持 | 大(128GB+) | 中等 |
| GTD AI 训练/推理 | GPU 密集 | 辅助 | 必需(大显存) | 大(256GB+) | 高 IOPS |
| Discoverant 数据分析 | 内存/IO 密集 | 多核 | 可选 | 极大(256GB+) | 极高 IOPS |
五、BIOVIA 生物科学高性能计算平台配置推荐
方案一:入门级分子建模工作站(适合 Discovery Studio 单机操作、中小规模蛋白建模、虚拟筛选)
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | Intel Core Ultra 9 285K(8P+16E,24核32线程,P核睿频 5.7GHz) | Discovery Studio 界面操作、序列分析、药效团编辑以单线程高频为主,285K P核确保建模响应跟手无延迟 |
| 散热器 | 双 360mm 一体式水冷(静音方案) | 压制长时间 MD 模拟中的 CPU 发热,维持睿频稳定 |
| GPU | NVIDIA RTX 4000 SFF Ada(20GB GDDR6) | 支持 CHARMm/NAMD GPU 加速;20GB 显存可流畅运行 10万-30万原子体系的显式溶剂 MD 模拟 |
| 内存 | 64GB DDR5-5600(双通道) | 满足官方"每核心 4GB"推荐,支持中等规模蛋白(<500 残基)+ 显式水盒全加载 |
| 系统盘 | 1TB PCIe 4.0 NVMe SSD | 秒级启动 Discovery Studio 与 Pipeline Pilot Server |
| 数据盘 | 2TB NVMe SSD | 存储 PDB 结构库、轨迹文件(.dcd/.xtc)、对接结果 |
| 显示器 | 27英寸 2K IPS(100% sRGB) | 分子结构可视化与轨迹分析 |
预估性能:500 残基蛋白显式溶剂 MD 模拟(CHARMm GPU)> 50 ns/day;10,000 分子虚拟筛选(CDOCKER)< 4 小时;同源建模(MODELER)< 5 分钟/结构。
方案二:专业级分子动力学与 AI 药物设计工作站(适合大规模 MD 模拟、GTD 本地模型训练、抗体设计)
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | AMD Ryzen Threadripper 7970X(32核64线程,全核 4.0GHz+)或 Intel Core i9-14900K(24核32线程,全核 5.6GHz+) | 建模阶段:14900K 单核高频,蛋白结构编辑、药效团调整响应迅速;模拟阶段:7970X 32 核在 DMol3 DFT、大规模对接批量任务中效率提升显著 |
| 散热器 | 压缩机水冷系统(600W 级制冷功率) | 针对 14900K/Threadripper 超频场景,全核满载温度压制在 70°C 以内,确保 MD 模拟与 DFT 计算不降频 |
| GPU | NVIDIA RTX Pro 5000(48GB GDDR7) 或 RTX 5000 Ada(32GB) | 32GB 大显存支持 50万-100万原子超大规模体系(膜蛋白+脂质双分子层+水)的 NAMD GPU-resident 模式;支持 GTD 本地 ML 模型训练 |
| 内存 | 128GB DDR5-5600(四通道,Threadripper 平台) | 支持百万原子级 MD 体系全加载、DMol3 大体系 DFT 计算、GTD 批量分子描述符生成 |
| 系统盘 | 2TB PCIe 4.0 NVMe SSD(企业级,带 DRAM 缓存) | 支持 Pipeline Pilot Server 频繁读写大型工作流缓存 |
| 数据盘 | 4TB NVMe SSD(RAID 0,可选) | MD 轨迹文件(50GB+/100ns)、对接结果库、GTD 虚拟化合物库高速读写 |
| 网络 | 双 2.5GbE 以太网 | 连接 3DEXPERIENCE 云平台(GTD)、NCBI/PDB 数据库下载 |
| 显示器 | 双屏 27英寸 4K IPS(100% Adobe RGB) | 一屏分子视窗、一屏轨迹分析/对接结果矩阵 |
预估性能:100万原子膜蛋白 MD 模拟(NAMD GPU)> 30 ns/day;DMol3 500 原子体系几何优化 < 2 小时;GTD 单轮 10,000 分子生成+评分 < 30 分钟。
方案三:旗舰级多物理场生物计算集群节点(适合超大规模 MD、AI 生成式药物设计、Discoverant 制造大数据、企业级研发平台)
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | AMD Ryzen Threadripper PRO 7995WX(96核192线程) 或 Intel Xeon W9-3495X(56核112线程) | 7995WX 在 MSLD 自由能计算、DMol3 大体系 DFT、Discoverant 多变量分析中展现压倒性多核优势;Xeon W9 适合需要 ECC 内存稳定性的企业级合规场景 |
| 散热器 | 双压缩机并联水冷系统(1000W 级制冷功率) | 7995WX 全核满载功耗超 400W,双压缩机确保 AVX-512 指令集在密集矩阵运算中持续满血运行 |
| GPU | NVIDIA RTX Pro 6000(96GB GDDR7) | 双卡 48GB×2 通过 NVLink 实现显存池化,可驾驭 200万+ 原子超大规模生物体系(病毒颗粒、核糖体)MD 模拟;支持 GTD 大模型分布式训练 |
| 内存 | 256GB DDR5-4800(八通道,Threadripper PRO 平台) | 支持超大规模体系全加载、Discoverant 全厂制造数据实时分析、GTD 十亿级分子库内存缓存 |
| 存储系统 | 系统盘:2TB PCIe 5.0 NVMe SSD;数据盘:8TB NVMe SSD(RAID 0);归档盘:16TB 企业级 HDD | MD 轨迹实时写入、GTD 虚拟化合物库(TB 级)、Discoverant 历史批次数据三级存储架构 |
| 网络 | 双万兆以太网(10GbE) | 3DEXPERIENCE 云平台 GTD 数据同步、PDB 数据库镜像、企业级 LIMS/MES 数据聚合 |
| 显示器 | 三屏 32英寸 4K IPS(100% DCI-P3)或 49英寸超宽曲面屏(5120×1440) | 超宽视野实现分子视窗 + 轨迹分析 + 数据仪表板三窗口并行 |
预估性能:200万+原子病毒颗粒 MD 模拟(NAMD/OpenMM 双 GPU)> 20 ns/day;Discoverant 10 年批次数据(>100GB)聚合分析 < 10 分钟;GTD 五轮 V+R 主动学习循环(50,000 分子/轮)< 2 小时。
六、关键硬件选型深度解析
GPU:NVIDIA 专业显卡是 MD 模拟与 AI 训练的"算力心脏"
BIOVIA Discovery Studio 2026 明确支持 NVIDIA GPU 用于 CHARMm、NAMD、MSLD、FEP 及 OpenMM 加速,且 NAMD GPU-resident 模式与 OpenMM 可将模拟速度提升至 CPU 8 核并行计算的 9 倍以上。
显存容量直接决定可模拟的体系规模:20GB 适合 30万原子以下 soluble protein,32GB 可驾驭 100万原子膜蛋白体系,48GB×2 双卡可模拟 200万+ 原子超大复合物。消费级游戏卡(如 RTX 4090)虽算力强悍,但缺乏 ECC 显存与专业驱动稳定性,在长达数周的 MD 生产模拟中存在数据完整性风险。
CPU:高频与多核的"场景化切换"
BIOVIA 平台的硬件需求呈现鲜明的双模态特征:
-
蛋白质建模、药效团编辑、对接结果可视化:依赖高主频单核性能,推荐 Intel Core Ultra 285K(5.7GHz)或 i9-14900K(5.8GHz)
-
DMol3 DFT 计算、NAMD/CHARMm CPU 模式、Discoverant 多变量分析:调用多核并行,推荐 AMD Threadripper 7970X/7995WX
建议采用"高频 Intel 用于交互建模、多核 AMD 用于批量计算与数据分析"的双平台策略,或通过压缩机水冷超频将 Threadripper 单核频率提升至 4.5GHz+ 以兼顾两者。
内存:容量与带宽的双重门槛
官方要求"每核心 4GB RAM",但现代生物计算的实际需求远超此基准。一个 100万原子的显式溶剂膜蛋白体系(含脂质、离子、水)在 NAMD 中可占用 40-60GB 内存;Discoverant 整合全厂 MES/LIMS 数据时,256GB 是流畅运行的安全底线。八通道 DDR5-4800(Threadripper PRO 平台)较双通道 DDR5-6000 在大型矩阵运算(PCA、SPC、MD 轨迹分析)中可带来 15-20% 的性能提升。
存储:IOPS 决定研发流水线效率
BIOVIA 工作流涉及频繁的 PDB 结构下载(mmCIF 格式,单文件可达数 GB)、MD 轨迹写入(100ns 模拟可产生 50-100GB .dcd 文件)、GTD 虚拟化合物库生成(单项目可达 TB 级)。建议采用 PCIe 4.0/5.0 NVMe SSD 作为系统盘与活跃项目盘,顺序读写需达 7000MB/s+。对于 Discoverant 制造分析场景,高速存储与 10GbE 网络同等重要,确保 MES/LIMS 数据实时聚合不成为瓶颈。
散热:超长时间模拟的稳定性基石
MD 生产模拟(Production Run)通常需要让 GPU/CPU 持续满载数天甚至数周。采用 600W-1000W 级压缩机水冷系统(如 XASUN 定制方案)可将 CPU 温度压制在热阈值以下,避免 AVX2/AVX-512 指令集降频导致的模拟时间延长。实测表明,压缩机水冷下的 Threadripper 7970X 在 NAMD 百万原子体系模拟中,ns/day 指标较普通 360 水冷提升 12-18%。
结语
BIOVIA 生物科学解决方案以 Discovery Studio 的分子建模与仿真、Generative Therapeutics Design 的 AI 生成式药物设计、Discoverant 的制造大数据分析为三大支柱,构建了一条从"原子相互作用快照"到"智能制造决策"的完整数字研发链路。CHARMm/NAMD/OpenMM 分子动力学、DMol3 量子力学、MSLD 自由能计算、GTD 主动学习循环、Discoverant 多变量统计建模等前沿技术,让生物制药企业能够在湿实验之前,以最低的风险和成本筛选出最有前景的候选药物。
然而,这套强大的生物计算引擎对硬件平台提出了严苛要求:NVIDIA RTX 专业显卡的 CUDA 加速、高主频与多核并重的 CPU 策略、大容量高带宽的内存配置、以及持续满载下的散热稳定性。选择一套经过 BIOVIA 官方认证、针对分子模拟与 AI 药物设计场景精准调优的高性能科学计算工作站,不仅能让软件功能发挥到极致,更能将研发人员从漫长的模拟等待中解放出来,专注于真正的科学创新。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


