






一句话导读:当三星、SK 海力士开始在数百层 3D NAND 中用钼(Mo)替换钨字线,当默克在韩国为阴城新厂投产 MoO₂Cl₂ 前驱体——互连材料的换代,已经把「材料仿真算力」推上了研发军备竞赛的前台。本文拆解钼互连背后的核心算法、计算特点、应用场景,并给出可直接落地的 UltraLAB 工作站硬件配置选型方案。
- 事件背景:默克投产,钼从候选材料走向量产
- 核心内容应用分析:为什么换钼、难在哪里
- 主要核心算法:从第一性原理到机器学习势函数
- 计算特点:CPU、GPU、内存、I/O 的真实瓶颈
- 典型应用场景
- UltraLAB 硬件配置怎么选
- 软件清单
- 常见问题:硬件配置误区深度分析
一、事件背景:默克投产,钼从候选材料走向量产
2026 年 10 月 22 日,德国默克(Merck)在韩国忠清北道阴城启用新的钼前驱体生产设施,生产二氯二氧化钼(MoO₂Cl₂)。这不是一次普通的产能扩张,而是一个明确的产业信号:钼正在从材料实验室里的「候选者」,正式走进先进芯片的制造流程。
- 三星电子已于 2024 年在 200 层级 3D NAND 中开始采用钼字线;
- SK 海力士在 300 层级 3D NAND 中将部分字线材料替换为钼;
- 默克明确将潜在应用指向 DRAM 与逻辑芯片,与钨、铜正面竞争互连材料地位。
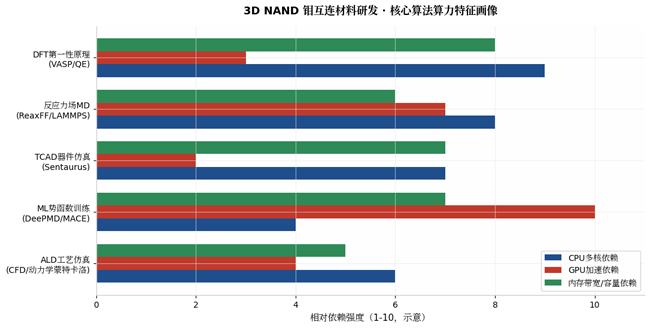
图 1 · 钼互连材料研发核心算法的算力特征画像(示意,来源:UltraLAB 材料计算方案组整理)
二、核心内容应用分析:为什么换钼、难在哪里
2.1 为什么是现在?—— 尺寸效应倒逼材料换代
3D NAND 通过垂直堆叠提升密度,层数持续攀升后,字线(Word Line)必须在更狭窄的空间内制造。钨(W)薄膜在纳米尺度下受尺寸效应影响,电子散射显著,有效电阻随结构缩小而恶化,直接拖累信号传输速度与功耗。钼在微细结构中有望实现比钨更低的有效电阻,这是材料换代的物理驱动力。
2.2 钼的第二个杀器:减少阻挡层占用
传统钨互连通常需要额外的衬层/阻挡层(barrier/liner),它们不导电却占据宝贵的结构横截面积。钼在特定工艺中具有减薄甚至省去阻挡层的潜力,等于为导电金属「让出空间」——这正是先进制程寸土寸金之处。但需要注意:块体电阻率不等于纳米尺度表现,最终效果取决于薄膜厚度、沉积方式与具体工艺条件。
2.3 真正的难点:不在导电性,而在「前驱体 + 输送 + 沉积」全链条
默克生产的并不是金属钼本身,而是用于 CVD / ALD(化学气相沉积 / 原子层沉积) 的 MoO₂Cl₂ 前驱体。两个工程细节决定了产业化门槛:
- 固态升华输送:MoO₂Cl₂ 室温下为固态,必须加热升华后以气态送入沉积设备,温度/压力任何波动都会破坏沉积稳定性;
- 高深宽比覆盖:数百层 NAND 的沟道孔深宽比极高,ALD 依赖交替自限制表面反应实现均匀覆盖,前驱体化学性质、反应条件、薄膜质量都必须重新优化。
默克将前驱体与安山工厂生产的 CHEMKEEPER Vapor 200 供应系统结合,宣称材料利用率超过 99%。这揭示了一个本质规律:先进材料的竞争早已不是单一材料参数的比拼,而是「化学品生产 → 材料输送 → 晶圆沉积 → 工艺验证」全链条的系统工程——而每一环背后,都是仿真与计算的战场。
给研发管理者的一个判断:钼的应用将沿「3D NAND 字线 → DRAM → 逻辑芯片互连」的路径扩展,但每一步都需要工艺开发与客户端验证。谁先建立起「材料计算 + 器件仿真 + 工艺验证」的仿真能力闭环,谁就能在前驱体筛选与结构定型阶段省下真金白银的流片成本。
三、主要核心算法:从第一性原理到机器学习势函数
围绕「钼前驱体化学、ALD/CVD 表面反应、字线电阻、器件电学」这条主线,研发端依赖五大类核心算法:
| 算法/方法 | 代表软件 | 解决什么问题 | 计算特征 |
|---|---|---|---|
| DFT 第一性原理(密度泛函理论) | VASP、Quantum ESPRESSO、ABACUS、Gaussian/ORCA | MoO₂Cl₂ 等前驱体的吸附能、解离路径、表面反应能垒;Mo/W 薄膜电子结构与有效电阻微观机制 | CPU 多核 MPI 并行,计算量随电子数近似 O(N³);内存带宽敏感,单机 32–128 核即可跑通主流体系 |
| 反应力场分子动力学(ReaxFF MD) | LAMMPS(USER-REAXC/CUDA)、GROMACS | ALD/CVD 过程中表面化学反应的动态过程、成核与薄膜连续性、高深宽比结构内的输运 | 时间步长极小(飞秒级),需模拟百万原子×纳秒级;GPU 加速收益巨大,显存容量决定体系规模 |
| 机器学习势函数(MLP) | DeePMD-kit、MACE、NequIP、DP-GEN | 用 DFT 数据训练势函数,以接近经典力场的成本达到接近 DFT 的精度,实现「大体系×长时间」表面反应模拟 | 训练阶段重度 GPU 依赖(多卡并行最佳),推理阶段 GPU 高速;是当前降本增效的关键路线 |
| TCAD 器件仿真 | Synopsys Sentaurus、Silvaco Victory、COMSOL | 字线 RC 延迟、IR 压降、3D 存储单元电学特性、钼/钨方案对比验证 | 大网格 3D 求解偏微分方程,内存容量与带宽敏感;多结构批量参数扫描是典型负载 |
| 工艺/输运仿真 | ANSYS Fluent/CFD、特征线法 Monte Carlo、动力学 Monte Carlo(kMC) | 前驱体气体输送(温度/压力场)、升华-输运稳定性、ALD 循环均匀性 | CFD 为 CPU 多核负载;kMC 适合 GPU 大规模并发 |
四、计算特点:CPU、GPU、内存、I/O 的真实瓶颈
| 维度 | 材料仿真负载的真实表现 | 硬件启示 |
|---|---|---|
| CPU | DFT 并行效率在 32–128 核后明显衰减;ReaxFF-CPU 可扩展到数百核;TCAD 3D 求解吃单核性能与大内存 | 「高主频 + 足够多核」优于盲目堆核;单路高频与双路超多核按软件分层选型 |
| GPU | LAMMPS-CUDA、DeePMD-kit、MACE 训练在多 GPU 上近乎线性扩展;显存决定可模拟体系规模(百万原子级需 24–96GB 显存/卡) | MD/MLP 路线必须预留多卡位与大功率电源,显存 ≥24GB 起步 |
| 内存 | DFT 平面波截断能、TCAD 大网格直接吃内存;高通量筛选要求单机能同时跑数十个任务 | 512GB–1TB DDR5 多通道是研发主力机的甜点区;内存带宽(通道数)比容量更影响 DFT 效率 |
| 存储 I/O | 波函数/轨迹文件动辄数百 GB;高通量任务产生海量小文件 | PCIe 4.0/5.0 NVMe 系统盘 + 大容量 SSD 数据盘;避免机械盘成为 I/O 瓶颈 |
| 稳定性 | 一个 DFT 任务连跑 7 天,一次宕机=重来;超频与高频负载对散热和供电要求苛刻 | 工业级水冷、冗余电源、7×24 稳定性验证比跑分更重要 |
五、典型应用场景
- 存储芯片厂商(IDM):Mo/W 字线有效电阻对比、阻挡层减薄方案验证、ALD 工艺窗口优化、TCAD 器件级验证;
- 前驱体/电子材料厂商:新型钼前驱体分子设计、升华/输运过程 CFD 仿真、与供应系统(如 CHEMKEEPER 类方案)联动的工艺匹配;
- 高校与科研院所:二维/薄膜 Mo 材料的第一性原理研究、ReaxFF 力场开发与验证、ML 势函数数据集构建;
- EDA 与 IP 服务商:先进互连 RC 参数提取、寄生参数建模、设计-工艺协同优化(DTCO);
- 设备厂商(ALD/CVD 设备):高深宽比沉积均匀性仿真、腔体流场与热场设计。
六、UltraLAB 硬件配置怎么选
针对上述负载特征,按团队规模与算法主线,给出四档配置建议(机型对应 UltraLAB 桌面产品线:AX 超频系列 / EA650·EX660 欧拉系列 / GX 图灵超算系列 / Alpha 旗舰系列):
| 档位 | 适用对象与算法主线 | 推荐配置要点 | 对应机型参考 |
|---|---|---|---|
| 入门科研档 | 高校课题组、小体系 DFT(<200 原子)、教学演示 | 高频多核处理器(6.0GHz 级或 24–32 核 EPYC)、128GB DDR5、2TB NVMe + 4TB SSD、RTX 4060/4070 12GB | UltraLAB AX 超频系列 |
| 主力研发档 | 企业材料研发、高通量 DFT 筛选、TCAD 器件仿真 | 双路 AMD EPYC(64–128 核)、512GB–1TB DDR5 十二通道、4TB NVMe + 16TB SSD、RTX A4000/Pro 6000 | UltraLAB EA650 / EX660 欧拉系列 |
| 异构加速档 | ReaxFF MD、DeePMD/MACE 势函数训练与推理、大体系表面反应 | 双路 EPYC 或高频单路 + 2–4 块 RTX 4090 / RTX Pro 6000(48–96GB 显存)、256–512GB DDR5、2000W+ 电源 | UltraLAB GX 图灵超算系列 |
| 旗舰平台档 | 大型 TCAD、百万原子级 MD、多任务并行的高通量计算中心 | 双路 EPYC 256 核级、2TB DDR5、4–7 块 GPU、PCIe 5.0 高速存储阵列、全水冷静音 | UltraLAB Alpha 旗舰系列 |
选型三原则:① DFT/TCAD 优先「高主频 + 内存带宽」,MD/MLP 优先「GPU 显存 + 卡数」;② 内存一步到位比后期加插更经济(多通道性能随满配 DIMM 最优);③ 连续 7×24 满载的稳定性验证(无死机、无蓝屏、无重启)应写进验收标准。
七、软件清单
| 类别 | 软件 | 许可证类型 | 硬件适配要点 |
|---|---|---|---|
| 第一性原理 | VASP、Quantum ESPRESSO、ABACUS、CASTEP、Gaussian / ORCA | 商业 / 开源 | CPU 多核 + 高内存带宽;VASP 6 支持 OpenACC GPU 加速 |
| 分子动力学 | LAMMPS、GROMACS、HOOMD-blue | 开源 | GPU(CUDA)加速;百万原子体系需大显存 |
| 机器学习势函数 | DeePMD-kit、MACE、NequIP、DP-GEN、ASE | 开源 | 多 GPU 训练;建议 2 卡起步 |
| TCAD 器件 | Synopsys Sentaurus、Silvaco Victory、COMSOL Multiphysics | 商业 | 高主频 CPU + 大内存(3D 网格) |
| 工艺/输运仿真 | ANSYS Fluent、CFD-ACE+、kMC 自研代码 | 商业 / 自研 | CPU 多核;kMC 可 GPU 化 |
| 高通量/数据 | Pymatgen、matminer、Airss/CALYPSO 结构搜索、MongoDB | 开源 | 多核并发任务 + 高速 SSD |
| 可视化/前后处理 | VESTA、OVITO、VMD、ParaView | 开源 | 中端 GPU + 高分辨率显示器 |
| 通用环境 | Python(NumPy/SciPy/PyTorch)、MATLAB、Intel oneAPI / AOCL 数学库 | 开源 / 商业 | — |
八、常见问题:硬件配置误区深度分析
Q1:DFT 是不是核心越多越好?上了 256 核为什么反而更慢?不是。VASP/QE 等平面波程序在 32–128 核后并行效率急剧下降(FFT 网格与 k 点分布限制),盲目堆核只会浪费许可证与预算。正确做法:高频 32–64 核节点做主力,配合作业调度做多任务并发;大体系再用 k 点/离子步拆分跨节点并行。UltraLAB 双路 EPYC 机型支持按软件特性做核数与主频的定制化平衡。
Q2:跑 DFT 需要配高端 GPU 吗?常规 VASP 5.x/QE 以 CPU 为主,GPU 收益有限;但 VASP 6(OpenACC)、ABACUS 及所有 MD/MLP 工作流对 GPU 依赖度高。建议按团队算法结构决策:纯 DFT 团队「CPU 强 + 中端 GPU」即可;涉及 ReaxFF/机器学习势函数的团队,GPU 显存与卡数应占总预算 40% 以上。
Q3:内存配多大合适?128GB 和 1TB 差在哪?取决于平面波截断能、体系原子数与 TCAD 网格规模。经验值:100–300 原子 DFT(500eV 级)单任务约 20–60GB;高通量并发 8–16 任务即需 512GB–1TB;3D TCAD 大网格仿真单任务可超 200GB。另外十二通道满配比「容量够但通道空」的内存带宽高出一截,对 DFT 的提速往往在 20% 以上。
Q4:超频工作站 7×24 满载跑 DFT 稳定吗?关键在于工业级水冷散热、供电冗余与出厂压力验证。消费级超频机跑游戏没问题,连续一周满载跑 VASP 则容易过热降频甚至死机。UltraLAB 超频机型采用工业级水冷并通过 SPECworkstation 等级满载验证,支持以「连续满载无重启」作为验收条款——这对动辄跑一周的第一性原理任务至关重要。
Q5:买了 4 张 GPU,训练速度却没翻倍,问题出在哪?三个高频原因:① 数据管线(DataLoader)CPU 预处理跟不上,GPU 空转——需高主频多核 CPU 与 NVMe 高速盘;② 显存不足导致 batch size 上不去,无法发挥多卡并行;③ 框架/驱动未做多卡通信优化(NCCL 环境)。建议按「CPU : GPU 显存 : 存储 ≈ 1 : 2 : 1」的预算比例整体规划。
Q6:材料数据是核心资产,上云好还是本地化工作站好?前驱体配方、力场参数、工艺窗口数据属于企业核心知识产权,且 DFT/MD 任务需长期稳定满载。本地化 UltraLAB 工作站可实现「数据不出门、任务不断电、许可本地管理」,配合远程图形访问方案支持团队共享,综合成本通常显著低于长期租用云算力。
关于 UltraLAB:UltraLAB 是西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,产品涵盖超频(H/AX/GT)、欧拉(EA/EX)、图灵超算(GX)、旗舰(Alpha)等桌面系列与便携、特种系列,面向材料模拟、EDA、量子化学、分子动力学、深度学习等专业领域提供「按软件定制」的硬件配置方案与 7×24 技术支持。
本文部分行业信息综合自公开报道(半导体行业观察,2026-10-23,来源 theelec),硬件参数以官方最新配置为准。文中算法性能数据为工程经验示意,具体项目请以实测为准。


