






后摩尔时代,算力竞争的战场已从"纳米"转移到"纳秒"。
华为在2026 IEEE ISCAS上首次公开的"韬(T)定律",宣告半导体产业进入"时间缩放"新纪元——当晶体管微缩逼近物理极限,芯片性能的提升不再只依赖制程几何,而是取决于信号传播时间、系统协同效率与端到端时延的极致压缩。逻辑折叠、3D堆叠、Chiplet异构集成、多物理场耦合……这些曾经分散的技术节点,正在韬定律的框架下融合为统一的系统级工程。
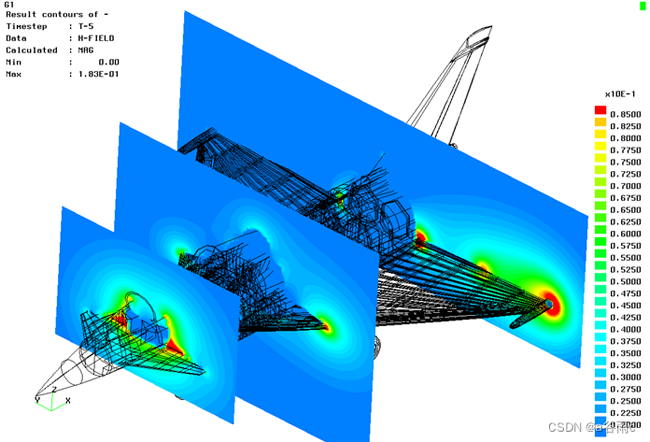
这意味着,下一代EDA与系统仿真对算力底座提出了全新要求:不再是单一维度的"跑得快",而是多物理场、多尺度、多任务并发的"算得准、算得全、算得起"。
作为深耕高性能计算工作站领域的UltraLAB,我们针对韬定律时代的四大核心应用场景,重新设计了算力配置方案。
场景一:3D Chiplet先进封装与多物理场协同设计
应用背景 在韬定律驱动下,芯片设计从二维平面跃迁至三维架构,跨层布线、层间时序收敛、热-电-力多物理场耦合成为常态。传统"各管一摊"的仿真模式已无法胜任。
核心算法与计算特点
表格
| 维度 | 算法/方法 | 计算特点 |
|---|---|---|
| 电磁仿真 | FDTD、FEM、MoM | 大规模稀疏矩阵求解,内存带宽敏感 |
| 热分析 | CFD有限体积法 | 非线性迭代,多尺度网格 |
| 应力/形变 | 有限元分析(FEA) | 结构-热耦合,长时程迭代 |
| 信号完整性 | S参数提取、瞬态仿真 | 宽频带扫描,大量端口激励 |
软件工具 Ansys HFSS / Icepak / Mechanical、Cadence Celsius Thermal Solver、Synopsys 3DIC Compiler、芯和半导体XDS、华大九天Empyrean
UltraLAB硬件推荐
UltraLAB AE450 超频图形工作站
场景二:AI超节点系统级互连与高速SerDes仿真
应用背景 韬定律的本质是系统级时延压缩。在AI服务器与超节点架构中,HBM、Chiplet、高速互连、供电与散热必须协同运行。信号在PCB、封装、连接器、线缆中的传播时延,已成为系统瓶颈。
核心算法与计算特点
表格
| 维度 | 算法/方法 | 计算特点 |
|---|---|---|
| 信号完整性 | 时域有限差分、SPICE瞬态 | 大规模网络拓扑,长比特序列仿真 |
| 电源完整性 | 频域阻抗分析、PDN仿真 | 宽频带扫频,大规模去耦电容矩阵 |
| 高速串行链路 | 眼图分析、均衡算法(CTLE/DFE) | 统计仿真与瞬态仿真结合 |
| 系统互连优化 | 拓扑规划、布线算法 | 组合优化问题,启发式搜索 |
软件工具 Cadence Sigrity / Clarity、Ansys SIwave / Q3D、Keysight ADS、芯和半导体Metis
UltraLAB硬件推荐
UltraLAB GT430P 静音超频AI工作站
场景三:STCO系统技术协同优化平台
应用背景 从DTCO(设计-工艺协同优化)到STCO(系统技术协同优化),是韬定律在EDA方法论上的直接映射。芯片、封装、PCB、整机系统不再割裂设计,而是在统一平台上进行跨层级优化。
核心算法与计算特点
表格
| 维度 | 算法/方法 | 计算特点 |
|---|---|---|
| 多目标优化 | 遗传算法、粒子群、贝叶斯优化 | 高维参数空间,黑箱函数评估 |
| 时序收敛 | 静态时序分析(STA)、路径搜索 | 超大规模图遍历,内存密集 |
| 功耗-热-性能联合优化 | 多物理场降阶模型(ROM) | 多场耦合迭代,计算量指数级增长 |
| 逻辑折叠验证 | 形式验证、等价性检查 | 布尔可满足性问题(SAT),逻辑深度大 |
软件工具 华为自研EDA工具链(预告)、Synopsys Fusion Compiler、Cadence Innovus / Tempus、华大九天Empyrean、芯和半导体
UltraLAB硬件推荐
UltraLAB CA660 全水冷高性能计算工作站
场景四:逻辑折叠与三维架构物理验证
应用背景 逻辑折叠是韬定律实现"时间缩放"的关键技术之一,通过在垂直方向折叠逻辑层级,缩短关键路径时延。但这带来了前所未有的物理验证复杂度:3D DRC、LVS、天线效应、层间对准误差等。
核心算法与计算特点
表格
| 维度 | 算法/方法 | 计算特点 |
|---|---|---|
| 物理验证 | 几何布尔运算、扫描线算法 | 超大规模GDSII数据,I/O密集型 |
| 3D DRC/LVS | 空间索引、分层匹配 | 三维几何复杂度剧增 |
| 光刻仿真 | 成像模型、OPC/SMO | 卷积迭代,GPU加速友好 |
| 寄生参数提取 | 场求解器、随机行走 | 精细结构要求高精度,内存与计算双密集 |
软件工具 Mentor Calibre、Synopsys IC Validator、Cadence Pegasus、华大九天Argus
UltraLAB硬件推荐
UltraLAB GR450P 超频仿真工作站
结语:算力底座,决定韬定律的落地高度
韬定律不是对摩尔定律的否定,而是半导体产业从"微观工艺竞赛"迈向"宏观系统协同"的必然进化。当设计对象从平面晶体管升级为三维系统,仿真维度从单一物理场扩展为电-热-力-流体多场耦合,算力底座也必须从"通用计算机"进化为"系统级工程专用平台"。
UltraLAB深耕超频图形工作站与全水冷高性能计算领域,以CPU极限频率释放、多物理场仿真加速、海量内存扩展、企业级稳定散热为核心竞争力,正成为国产EDA工具链与STCO平台最可靠的算力伙伴。
在韬定律定义的新纪元里,我们提供的不仅是工作站,而是让"时间缩放"真正发生的基础设施。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


