






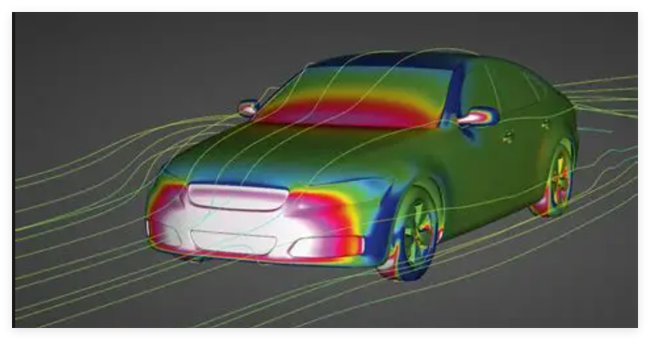
导读:一套整车外流场从CAD导入到风阻系数(Cd)收敛,需要经历几何修复、网格划分、稳态求解、瞬态验证、后处理出图五大环节。在ANSYS Fluent中,前处理网格划分可能只需30分钟,而瞬态DES湍流模拟100毫秒物理时间却可能需要72小时。这200倍的耗时差异,不是软件设置失误,而是流体仿真标准化流程中每个环节的算法本质对算力需求截然不同。当你的团队同时处理几何清理、千万级网格生成、多相流瞬态求解、批量DOE优化时,一台"全环节无短板"的图形工作站,才是让CFD从"单点突破"走向"流程闭环"的工业基础设施。
一、流体仿真标准化五步法:算力需求全景图
工业级流体仿真(CFD)已形成成熟的标准化流程。每个环节不仅依赖特定算法,更对硬件资源提出差异化需求:
plain
CAD导入 → 几何清理/简化 → 网格划分 → 求解计算 → 后处理/报告
   ↓         ↓            ↓          ↓           ↓
 I/O密集   内存+单核    内存+多核   CPU+内存+带宽   GPU显存
二、环节一:几何建模与CAD清理——被低估的内存首峰
核心算法
-
布尔运算(Boolean Operations):合并/相减/相交体素化计算,用于创建流体域(如发动机水套抽取)
-
特征抑制(Defeaturing):自动识别并移除小倒角、小孔、螺纹等无关几何特征
-
中面提取(Midsurface):薄壁结构(换热器翅片)抽取壳体,减少三维网格量
-
流体域抽取(Volume Extraction):从固体装配体中反向生成内流/外流计算域
计算特点
| 特征 | 表现 | 硬件影响 |
|---|---|---|
| 内存突发 | 复杂装配体(如整车底盘)布尔运算峰值可达32~64GB | 内存容量不足直接导致操作崩溃 |
| 单核主导 | 特征识别与体素化算法串行执行,多核加速有限 | 高主频CPU(≥4.5GHz)缩短等待时间 |
| I/O密集 | STEP/IGES/CATPart文件导入导出,大型文件>500MB | NVMe SSD将导入时间从分钟级压缩到秒级 |
硬件配置要点:此环节是"内存第一、主频第二"。建议配置64GB起步、工程级128GB内存,保障SpaceClaim/DesignModeler流畅操作。
三、环节二:网格划分——决定求解精度的算力分水岭
网格质量直接决定CFD结果的可靠性,也是硬件资源消耗最不可控的环节。
核心算法
| 网格类型 | 算法原理 | 适用场景 |
|---|---|---|
| 四面体(Tetrahedral) | Delaunay三角化/Advancing Front,非结构化,适应复杂几何 | 汽车外流场、阀体内部流道 |
| 六面体(Hexahedral) | 映射/扫掠/多区域(MultiZone),结构化,质量高 | 简单管道、边界层主导流动 |
| 多面体(Polyhedral) | 对偶网格转换,面数多但单元数少,收敛快 | Fluent首选,减少30~50%单元数 |
| 膨胀层(Inflation/Prism) | 沿壁面法向拉伸棱柱层,捕捉边界层梯度 | 湍流仿真刚需,Y+控制关键 |
| 滑移/重叠网格(Overset) | 多区域网格嵌套插值,处理运动部件 | 风机旋转、船舶螺旋桨 |
计算特点
| 特征 | 表现 | 硬件影响 |
|---|---|---|
| 内存峰值之王 | 2000万单元多面体网格+膨胀层,内存峰值96~192GB | 内存为绝对瓶颈,虚拟内存交换导致划分时间从小时变天 |
| 多核加速显著 | 并行面/体网格生成支持16~64核 | 多核CPU加速明显,但>64核后网格生成器并行效率递减 |
| 几何尺度矛盾 | 整车级(米)与边界层第一层(微米)相差6个数量级 | 膨胀层局部加密导致网格数指数增长,进一步放大内存需求 |
关键洞察:网格划分环节的内存峰值往往高于求解环节。工程师常按"求解需求"配内存,却在网格阶段就触顶。
四、环节三:求解器数值计算——CPU与内存的持久战
核心算法体系
1. 离散方法
-
有限体积法(FVM):ANSYS Fluent/CFX、OpenFOAM主流,守恒性好,适合湍流
-
有限元法(FEM):COMSOL、FEniCS,适合多物理场耦合(流-固-热)
-
有限差分法(FDM):学术代码为主,简单边界效率高
2. 压力-速度耦合算法
| 算法 | 特点 | 硬件映射 |
|---|---|---|
| SIMPLE | 半隐式,稳态主流,每步迭代压力修正 | 内存适中,适合多核并行 |
| PISO | 瞬态专用,两步修正,时间步长可更大 | 每步计算量略高于SIMPLE |
| Coupled | 压力-速度联立求解,收敛快但内存高 | 内存密集型,大型模型峰值翻倍 |
| Density-Based | 可压缩/高速流动,显式/隐式格式 | 显式受CFL限制步长小,总步数多 |
3. 湍流模型
-
RANS模型(k-ε, k-ω SST):计算量小,工程主流,百万级网格可接受
-
LES大涡模拟:直接解析大尺度涡,网格量需RANS的10~100倍,时间步长受CFL严格限制
-
DNS直接数值模拟:全尺度解析,网格量千万至亿级,仅用于基础研究
4. 多相流与传质模型
-
VOF(Volume of Fluid):追踪相界面,每步需界面重构,计算量单相的3~5倍
-
DPM(Discrete Phase Model):拉格朗日粒子追踪,粒子数>10万时CPU负载激增
-
Eulerian多相流:多组分流场联立求解,内存随相数线性增长
计算特点总结
| 维度 | 表现 | 硬件瓶颈 |
|---|---|---|
| 单核+多核混合 | 稀疏矩阵组装并行,线性求解器(AMG/GAMG)多核加速 | 高主频加速单步,多核加速整体 |
| 内存带宽敏感 | 每迭代步需全局通量更新,内存带宽决定数据吞吐 | DDR5 8通道比4通道提速20~30% |
| 长时程稳定 | 瞬态仿真常需72小时+连续运行 | ECC内存防翻转,液冷防降频 |
| GPU加速萌芽 | Fluent 202X部分支持GPU AMG求解器,但适用范围有限 | 主流仍以CPU为核心,GPU为辅助 |
五、环节四:后处理与可视化——GPU显存的战场
核心算法
-
体渲染(Volume Rendering):直接对三维标量场(压力/速度/温度)进行光线投射
-
等值面提取(Iso-surface):Marching Cubes算法生成特定值曲面(如Q准则涡识别)
-
流线/迹线追踪(Streamline/Pathline):积分常微分方程,展示流动结构
-
瞬态动画(Transient Animation):数百个时间步结果连续加载与插值
计算特点
| 特征 | 表现 | 硬件影响 |
|---|---|---|
| 显存密集型 | 2000万单元瞬态结果文件(.cas/.dat)单个2~5GB,加载10个时间步即20~50GB | 专业显卡大显存(24GB+)保障流畅操作 |
| OpenGL加速 | 3D旋转、切片、云图实时渲染依赖显卡图形管线 | RTX Pro系列通过ANSYS/西门子官方认证,驱动稳定性优于游戏卡 |
| 多屏分屏 | 同时显示云图、矢量图、XY曲线、监控面板 | 4K多屏输出需要显卡多接口支持 |
六、环节五:优化迭代与批量计算——并发Session的算力池
工程仿真不是"跑一次",而是"跑一百次":
-
参数化扫描:不同流速、不同几何尺寸、不同湍流模型对比
-
DOE实验设计:拉丁超立方采样,自动批量运行
-
设计优化:Adjoint伴随优化、拓扑优化,需数十次求解迭代
计算特点:任务级并行优于核心级并行。一台96核工作站同时运行6个独立Fluent Session(各16核),效率远高于单Session强塞96核。
七、硬件配置推荐:按流体仿真全流程精准匹配
基于五环节算力画像,结合UltraLAB图形工作站产品体系,给出三档配置:
【方案A】教学科研/中小型部件仿真工作站
适用场景:高校CFD课程、管道阀体、简单换热器、翼型绕流(<200万网格)
| 硬件模块 | 配置规格 | 覆盖环节 |
|---|---|---|
| CPU | Intel Core i9-14900K 超频版 (24核32线程, 5.8GHz+) | 几何清理高主频、求解多核并行 |
| 内存 | 64GB DDR5-5600 | 覆盖200万网格全流程峰值 |
| 存储 | 1TB NVMe Gen4 SSD | CAD秒开、网格秒存、结果秒载 |
| 显卡 | RTX Pro 4000 20GB | 后处理200万单元云图流畅旋转 |
| 系统 | Windows 11 Pro / Ubuntu 22.04 | Fluent/OpenFOAM双平台 |
推荐机型:UltraLAB A330 超频图形工作站(静音桌面级)
【方案B】汽车/航空工程级全流程仿真工作站
适用场景:整车外流场、发动机舱热管理、航空发动机叶片、LBM/LES中等规模(500~2000万网格)
| 硬件模块 | 配置规格 | 覆盖环节 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核192线程, 2.5~5.1GHz) 或 Xeon W7-3465X (28核56线程) | 96核支撑网格划分+6 Session并发求解;Xeon W保障ECC长时程稳定 |
| 内存 | 256GB DDR5-4800 ECC RDIMM | 2000万多面体网格+膨胀层峰值可达180GB,256GB为安全线 |
| 存储 | 2TB NVMe Gen4 SSD + 8TB SATA HDD | SSD活跃项目,HDD历史归档 |
| 显卡 | RTX Pro 5000 32GB | 32GB显存加载10个瞬态时间步不爆显存 |
| 散热 | 360mm液冷 | 满载350W+不降频,保障72小时瞬态求解稳定 |
推荐机型:UltraLAB AE450 液冷图形工作站(8通道DDR5,最大2TB扩展)
【方案C】企业级多用户/超大规模瞬态计算平台
适用场景:整车气动噪声(FW-H)、发动机燃烧仿真、多相流VOF长时程、千万级网格LES
| 硬件模块 | 配置规格 | 覆盖环节 |
|---|---|---|
| CPU | 2× AMD EPYC 9654 (96核×2, 192核384线程) | 双路提供384线程,支持8~12个Fluent Session并发,或单Session 128核并行 |
| 内存 | 512GB DDR5-4800 ECC | 千万级网格+多相流+燃烧化学反应器峰值可达400GB+ |
| 存储 | 2× 3.84TB U.2 NVMe SSD(RAID 1)+ 16TB HDD | RAID 1保障长时程仿真数据安全;U.2企业级IOPS应对多用户并发 |
| 显卡 | RTX Pro 5000 32GB ×2 | 双卡支持多用户后处理隔离,或单用户双4K屏瞬态动画 |
| 系统 | Windows Server 2022 + RDS远程桌面 | 5~10人远程并发,各用户独立全流程操作,开机即用 |
推荐机型:UltraLAB GA660 机架式图形工作站(4U双路,企业级可靠性)
八、关键选型建议:流体仿真全流程的"三要三不要"
三要
-
要按"网格峰值"配内存,不要按"求解均值":网格划分内存峰值常是求解阶段的1.5倍,配置容量=预估求解峰值的2倍才安全
-
要高主频+多核+ECC并重:几何清理吃主频,网格划分吃多核,长时程求解吃ECC——缺一不可
-
要企业级NVMe+专业显卡+液冷:SSD保障全流程I/O不卡,专业显卡保障后处理不崩,液冷保障满载不降频
三不要
-
不要忽视前处理环节的算力需求:90%的工程师只给求解器配硬件,结果在SpaceClaim或ICEM阶段就内存溢出
-
不要为纯RANS稳态仿真投资多卡GPU:Fluent GPU求解器目前仅覆盖部分场景,主流仍以CPU为核心,单卡RTX Pro已足够后处理
-
不要省略远程多用户环境:企业级Fluent/CFX License昂贵,5~10人共享算力是常态,RDS预装是"开机即用"的核心价值
结语:让算力贯通流体仿真的每一个标准环节
流体仿真的标准化流程,不是"前处理凑合、求解器堆核、后处理将就"的拼凑,而是从CAD导入的第一秒到报告输出的最后一帧,算力需求在不同环节间无缝接力的系统工程。当几何清理的布尔运算在64GB内存中流畅完成,当2000万单元多面体网格在96核CPU上小时级生成,当瞬态求解在ECC内存中稳定运行72小时,当后处理在32GB显存中实时旋转体渲染——这套流程才算真正"标准化"。
UltraLAB流体仿真全流程图形工作站,基于Core i9/Xeon W/Threadripper/EPYC全平台架构,提供从64GB到2TB内存、从静音桌面到机架远程并发的全栈算力方案,助力汽车、航空、能源、化工领域的CFD工程师,在几何建模、网格划分、数值求解、后处理可视化的每一个环节,都有匹配的算力支撑,让流体仿真从"流程标准化"走向"效率标准化"。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


