






导读:汽车轮毂从实心盘到仿生多孔结构,航空支架从经验设计到算法驱动——结构轻量化早已不是"把材料挖空"那么简单。Ansys Mechanical的拓扑优化(Topology Optimization)能在概念阶段就给出最优材料分布,但背后是50~200次有限元迭代求解+灵敏度分析+密度更新的漫长计算。当你的模型从2D简化为3D实体、从单工况扩展到多载荷步、从纯刚度优化加入制造约束(拔模方向、最小尺寸、对称性),你的工作站CPU和内存,还能跟上这种"每克材料都要论证"的算力消耗吗?
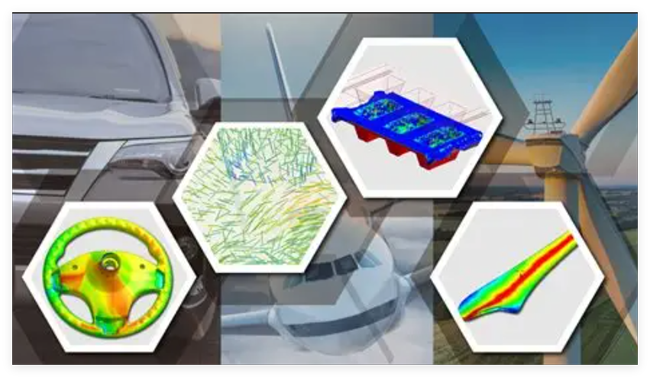
一、结构轻量化设计的五大核心环节
基于Ansys Mechanical拓扑优化解决方案,现代结构轻量化已形成完整技术链条:
1. 概念设计:拓扑优化(Topology Optimization)
在最初的概念阶段,工程师定义设计空间(非设计区域保留,设计区域自由优化)、载荷工况、边界条件和优化目标(如最小柔度/最大刚度、最小质量)。Ansys Mechanical通过SIMP(Solid Isotropic Material with Penalization)方法或水平集法(Level Set),迭代计算最优材料密度分布,生成类似"仿生骨骼"的拓扑构型。
工程价值:在零件尚未定型前,算法已告诉你"哪里该留材料、哪里可以镂空"。轮毂案例从实心盘到多孔辐条的演化,正是拓扑优化的典型输出。
2. 形状优化(Shape Optimization)
在拓扑优化给出的概念构型基础上,进一步优化边界形状。通过移动网格节点或参数化几何,改善应力集中、降低峰值应力、提升疲劳寿命。Ansys支持基于网格变形的自由形状优化和基于参数的几何形状优化。
3. 尺寸优化(Size Optimization)
针对板壳结构(车身覆盖件、航空壁板)或梁框架结构,优化板厚、梁截面尺寸。在保持刚度和强度前提下,将材料用到"刀刃上"。Ansys支持壳厚度和梁截面参数的自动优化。
4. 多目标/多约束综合优化
真实工程问题从来不是单目标。Ansys Mechanical支持同时优化:
-
目标:质量最小化 + 刚度最大化 + 一阶频率最大化
-
约束:应力上限、位移上限、制造约束(拔模方向、最小成员尺寸、对称性、挤出/铸造/3D打印工艺约束)
制造约束的加入显著增加了优化问题的复杂度——算法不仅要找最优解,还要找"能造出来"的最优解。
5. 验证分析与制造准备
拓扑优化结果往往是"锯齿状"的密度场,需要:
-
几何重构:将优化结果转换为可编辑CAD模型(STL→NURBS/实体)
-
详细验证:对重构后的几何进行精细网格的静力/模态/疲劳分析
-
制造适配:3D打印(金属增材制造)、铸造、机加工的可制造性评估
二、核心算法与计算特点深度分析
1. SIMP拓扑优化算法
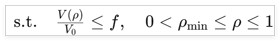
密度法(SIMP)的核心思想是将材料密度ρ作为设计变量(0≤ρ≤1),通过惩罚因子p使中间密度材料不经济:
E(ρ)=ρpE0,p≈3
优化问题表述为:
minρC(ρ)=UTK(ρ)U
计算流程:
-
初始化密度场
-
有限元求解(计算位移场U)
-
灵敏度分析(计算目标函数和约束对密度的导数∂C/∂ρ)
-
密度更新(OC法、MMA法等优化算法)
-
收敛判断 → 未收敛则返回步骤2
计算特点:每轮迭代一次完整有限元求解+一次灵敏度分析。50轮迭代=50次FE求解。3D模型百万自由度时,单次FE求解需数分钟,总耗时可达数小时。
2. 水平集法(Level Set Method)
相比SIMP的"灰度"密度场,水平集法通过隐式函数φ(x)描述材料边界,优化过程中边界演化更清晰,避免了SIMP的棋盘格和网格依赖问题。但每步需重新初始化水平集函数+求解Hamilton-Jacobi方程,计算成本更高。
3. 制造约束的算法代价
拔模方向约束、最小成员尺寸约束、对称性约束等,本质上是将设计变量空间"裁剪"到可制造子空间。这要求优化算法在每次迭代时额外检查约束违反情况,并投影到可行域,迭代收敛速度下降20~40%。
4. 多工况加权与多目标Pareto前沿
实际结构往往承受多种载荷(弯曲+扭转+冲击),拓扑优化需对多工况加权求和或寻找Pareto最优解。多工况意味着每轮迭代需多次FE求解(每个工况一次),计算量线性增长。
5. 网格分辨率与"像素化"效应
拓扑优化结果的分辨率直接受网格密度影响。粗网格(10万单元)优化结果粗糙,需后续大量手工调整;细网格(500万+单元)优化结果可直接用于制造,但单次FE求解时间和内存占用随单元数指数增长。
三、计算特点总结
| 计算环节 | 计算特征 | 硬件瓶颈 |
|---|---|---|
| 拓扑优化迭代求解 | 50~200轮FE求解+灵敏度分析,每轮矩阵分解 | CPU多核并行效率、内存容量 |
| 3D高分辨率网格 | 百万~千万级单元,3D实体网格 | 内存容量(首要瓶颈)、存储I/O |
| 多工况加权优化 | 每轮迭代×工况数,计算量线性倍增 | CPU核心数、内存带宽 |
| 制造约束优化 | 额外约束检查+可行域投影,收敛变慢 | CPU单核主频(迭代效率) |
| 参数化扫描 | 不同体积分数、不同目标权重组合 | CPU核心数、存储I/O |
| 后处理与几何重构 | 密度场云图、STL导出、NURBS重构 | GPU图形性能、显存 |
核心矛盾:拓扑优化是CPU密集型+内存密集型任务,GPU加速效果有限(除非使用AI代理模型替代部分FE求解)。高分辨率3D拓扑优化的内存需求往往超过100GB,是科研团队最容易遇到的"天花板"。
四、软件工具链
核心优化平台
-
Ansys Mechanical 2025/2026:内置拓扑优化模块,支持SIMP、水平集、制造约束、多物理场耦合优化
-
Ansys optiSLang:多学科优化(MDO)、鲁棒性设计、敏感性分析、流程自动化
-
Altair OptiStruct:工业界拓扑优化标杆,支持OSSmooth几何重构
-
Altair Inspire:面向设计师的快速拓扑优化工具,操作门槛低
-
SIMULIA TOSCA:Abaqus体系内的拓扑优化方案,与Abaqus求解器深度集成
几何重构与制造
-
nTopology:基于隐式场的拓扑优化结果几何重构,3D打印准备
-
Materialise Magics:STL修复、支撑生成、金属增材制造路径规划
-
ANSYS SpaceClaim / DesignModeler:拓扑优化结果的几何清理与参数化重建
-
Creo / SolidWorks / CATIA:传统CAD环境下的重构模型二次设计
验证分析
-
ANSYS Mechanical:重构模型的精细网格静力/模态/屈曲/疲劳验证
-
Abaqus / OptiStruct:非线性大变形、接触、复合材料验证
-
nCode DesignLife:轻量化结构的疲劳寿命评估
自动化与AI辅助
-
Python + PyAnsys:Ansys自动化脚本,批量参数化扫描
-
MATLAB:多目标优化算法(NSGA-II、MOPSO)与Ansys联合驱动
-
AI代理模型:用神经网络替代部分FE求解,加速拓扑优化迭代(前沿研究方向)
五、科研级硬件配置推荐
基于结构轻量化设计的四大负载特征——拓扑优化迭代CPU密集、高分辨率网格内存密集、多工况参数扫描并行友好、几何重构图形敏感——推荐以下三档方案:
【方案A】课题组入门型:2D/中小规模3D拓扑优化 + 方法验证
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon 674X(28核56线程,液冷超频4.8GHz) | 拓扑优化每轮迭代多线程FE求解;28核支持中小规模并行;高频加速收敛 |
| 内存 | 128GB DDR5-5600 ECC RDIMM(8×16GB) | 百万级3D单元拓扑优化 + 多工况缓存 + 灵敏度分析临时矩阵 |
| GPU | NVIDIA RTX Pro 5000 32GB | 32GB显存支撑拓扑优化密度场3D渲染;几何重构后处理 |
| 系统盘 | 2TB PCIe 4.0 NVMe SSD | Ansys Mechanical + optiSLang + CAD软件 |
| 数据盘 | 4TB PCIe 4.0 NVMe SSD | 拓扑优化迭代历史(每轮密度场、灵敏度场、收敛曲线) |
| 网络 | 双万兆以太网 | 多用户远程桌面,课题组共享 |
| 散热 | 360mm一体式水冷 | 保障Xeon W长时间满载不降频 |
| 系统 | Windows 11 / Ubuntu 22.04 LTS 双系统 | Ansys原生Windows优化;Python自动化Linux环境 |
适用场景:高校机械/车辆/航空工程系课题组,2D平面应力/3D中小规模拓扑优化,模型规模<100万单元,主要用于教学和方法验证。
【方案B】企业研发主力型:整车/整机级3D拓扑优化 + 多工况制造约束
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX(96核192线程,液冷超频) | 大规模参数化扫描(体积分数×工况权重×制造约束组合)可充分利用192线程;高频保障单轮迭代速度 |
| 内存 | 256GB DDR5-4800 ECC RDIMM(8×32GB) | 300~500万单元3D实体拓扑优化 + 多工况(5~10个载荷步)+ 制造约束灵敏度分析 |
| GPU | NVIDIA RTX Pro 5000 72GB ×2(NVLink桥接) | 72GB显存支撑超大规模拓扑优化密度场实时渲染;双卡加速几何重构后处理 |
| 系统盘 | 2TB PCIe 5.0 NVMe SSD | 极速加载Ansys大型装配体 |
| 数据盘 | 8TB PCIe 4.0 NVMe SSD ×2(RAID 0) | 拓扑优化每轮迭代产生大量密度场文件,RAID 0消除I/O瓶颈 |
| 阵列存储 | 32TB SATA企业级HDD ×4(RAID 5) | 历史优化案例库、材料数据库、制造约束模板库 |
| 网络 | 双万兆以太网 | 多用户并发远程桌面,设计-仿真-制造团队协作 |
| 散热 | 分体式液冷系统(CPU+双GPU全覆盖) | 双卡满载+CPU超频,总功耗超1500W |
| 系统 | Ubuntu 22.04 LTS(主)+ Windows 11(辅) | 大规模批处理以Linux稳定优先;Ansys/CAE前后处理可切Windows |
适用场景:汽车主机厂车身/底盘轻量化、航空结构件减重、高端装备支架优化,需处理整车级装配体拓扑优化(含制造约束),多工况(弯曲+扭转+碰撞+模态)综合优化。
【方案C】旗舰级轻量化设计中心:超大规模拓扑优化 + 多用户增材制造融合
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× Intel Xeon 铂金8592+(64核128线程,液冷) | 双路平台支持超大规模整车/整机结构拓扑优化;可同时调度多个优化作业 |
| 内存 | 512GB DDR5-5600 ECC RDIMM(16×32GB) | 千万级单元3D实体拓扑优化 + 多物理场耦合(热-结构)+ 多目标Pareto前沿计算 |
| GPU | NVIDIA RTX Pro 6000 96GB ×4 | 96GB显存可加载整车级拓扑优化密度场;四卡并行支持多用户同时几何重构与3D打印路径可视化 |
| 系统盘 | 4TB PCIe 5.0 NVMe SSD(企业级) | 高可靠性,保障长时间拓扑优化计算不中断 |
| 高速数据层 | 16TB PCIe 5.0 NVMe SSD ×2(RAID 0) | 支撑高分辨率拓扑优化密度场高频写入,消除存储瓶颈 |
| 冷数据层 | 64TB SATA企业级HDD ×6(RAID 6) | 海量拓扑优化案例库、增材制造工艺库、全生命周期轻量化档案 |
| 网络 | 双25Gb以太网 + InfiniBand HDR(可选) | 未来扩展多节点集群,构建轻量化设计私有云;与3D打印设备数据互联 |
| 散热 | 定制压缩机散热系统(2000W级) | 四卡96GB旗舰卡满载功耗极高,压缩机散热保障持续峰值性能 |
| 系统 | Ubuntu 22.04 LTS + Kubernetes容器调度 | 多用户容器化隔离,支持Ansys/OptiStruct/nTopology与Python自动化环境并存 |
适用场景:国家级轻量化设计实验室、大型航空/汽车研发中心,支撑超大规模拓扑优化+多物理场耦合优化+增材制造全流程融合。
六、关键配置细节提醒
1. 内存是拓扑优化的"天花板"
拓扑优化的灵敏度分析需要在内存中存储刚度矩阵对设计变量的导数。3D高分辨率模型(500万单元)+ 多工况 + 制造约束,内存占用轻松超过200GB。128GB只能跑中小规模2D/3D模型,256GB是3D主力标配,512GB才能驾驭整车级超大规模优化。
2. CPU核心数决定参数化扫描的"吞吐量"
拓扑优化本身每轮迭代内部可多线程化,但不同体积分数、不同目标权重的组合完全可以并行。96核/112核平台可同时跑6~10组参数,将原本数天的探索性优化压缩到数小时。这是高核心数CPU在轻量化研究中的核心价值。
3. 存储I/O决定迭代历史的"回溯能力"
Ansys Mechanical拓扑优化默认保存每轮迭代的密度场、灵敏度场、收敛曲线。100轮迭代×500万单元×3D密度场,总计可达数百GB。若使用机械硬盘,打开历史结果回溯会卡顿数分钟。PCIe 4.0/5.0 NVMe SSD是保障流畅回溯的刚需。
4. GPU对拓扑优化求解帮助有限,但对后处理至关重要
拓扑优化的FE求解和灵敏度分析目前仍以CPU为主,GPU加速效果有限。但在密度场3D渲染、STL几何重构、增材制造路径可视化阶段,大显存专业卡的价值不可替代。32GB是入门底线,72GB/96GB才能支撑超大规模模型的实时交互。
5. 制造约束优化对主频的隐性需求
加入拔模方向、最小尺寸等制造约束后,优化算法的可行域投影步骤增加,单轮迭代时间延长。高主频(≥4.5GHz)可减少投影计算时间,液冷超频的性价比在此凸显。
七、结语:硬件是结构轻量化的"隐形材料"
Ansys Mechanical的拓扑优化解决方案揭示了一个清晰趋势:结构设计正在从"经验驱动"走向"算法驱动"。SIMP密度法、水平集法、制造约束、多目标Pareto前沿——这些算法让工程师在概念阶段就能找到"每一克都算数"的最优解。但在这"智能化"背后,藏着更残酷的现实:高分辨率3D拓扑优化是内存和CPU的双重吞噬者,50~200轮迭代、多工况加权、制造约束投影,每一步都在考验硬件的极限。
对于高校机械工程教授、汽车/航空企业研发工程师、国家实验室技术骨干而言,选择一台能够支撑Ansys Mechanical大规模拓扑优化的图形工作站,已不是"配置够用就行"的保守策略,而是缩短轻量化设计周期、提升拓扑优化分辨率、抢占先进制造技术制高点的核心投资。
UltraLAB面向结构轻量化设计与拓扑优化场景,提供从液冷超频单卡工作站到四卡旗舰融合平台的完整方案,深度优化Ansys Mechanical、optiSLang、OptiStruct及Python自动化批处理环境的硬件协同,助力您的团队从"挖空材料"走向"算法造物"。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


