






计算流体力学(CFD)是现代工程设计的"数字风洞"。从航空发动机的涡轮叶片、新能源汽车的空气动力学外形,到城市建筑群的风环境评估、核反应堆的主泵热工水力分析,CFD 仿真正在变得越来越不可或缺。
但传统 CFD 的痛点同样尖锐:网格划分耗时、湍流模型精度受限、高保真大涡模拟(LES)算力需求爆炸、多工况参数扫描周期漫长。一个整车外流场的高保真 LES 仿真,在超算上跑数周并不罕见。
人工智能的介入,正在从底层重构这一范式。物理信息神经网络(PINN)实现了无网格求解,傅里叶神经算子(FNO)将三维可压缩湍流的计算速度提升数个数量级,深度强化学习(DRL)让流场主动控制从"离线设计"走向"实时闭环",而大语言模型(DeepSeek/通义千问)甚至可以用自然语言直接驱动 OpenFOAM 和 ANSYS Fluent 完成全流程仿真。
当 AI 成为 CFD 的"新引擎",GPU 不再只是后处理的"看图卡",而是训练神经算子、推理代理模型、驱动实时耦合的核心算力单元。 本文将系统拆解 AI 在流体力学中的五大加速环节,分析各环节对 GPU 的差异化需求,并给出专业图形工作站的配置方案。
一、AI 在流体力学的五大加速环节
环节一:前处理自动化——从"手工画网格"到"一句话生成仿真"
传统 CFD 的前处理是典型的时间黑洞:几何清理、网格划分、边界条件设置、求解器参数调优,一个复杂案例动辄数小时甚至数天。
AI 加速方式:
-
大语言模型(LLM Agent):利用 DeepSeek、通义千问等模型,将自然语言描述(如"模拟 NACA0012 在 Ma=0.3、Re=6×10⁶ 下的跨声速流动")自动转化为 OpenFOAM 的
controlDict/fvSchemes配置文件或 ANSYS Fluent 的 TUI 脚本,实现"Text-to-CFD"。 -
几何与网格生成:基于扩散模型和图神经网络,直接从几何描述生成适配的 CFD 网格,减少人工干预。
算力特征:LLM 推理对 GPU 显存容量敏感,7B-70B 参数模型的本地部署需要 24GB-96GB 显存。
环节二:无网格求解——PINN 绕过传统 FVM/FEM 的网格依赖
物理信息神经网络(PINN)将 Navier-Stokes 方程、能量方程等控制方程的残差作为软约束嵌入神经网络损失函数,使网络在无标注数据的情况下仍能学习满足物理定律的流场解。
AI 加速方式:
-
无网格求解:无需划分计算网格,直接在时空坐标点上训练网络,避免了复杂几何的网格生成难题。
-
逆问题求解:从稀疏实验测量(如 PIV 速度场)反演全场压力分布、未知材料参数,这是传统 CFD 难以直接完成的任务。
-
多尺度 PINN:通过傅里叶特征嵌入,克服标准 PINN 的"频谱偏置",捕捉湍流中的小尺度高频结构。
算力特征:PINN 训练属于高维优化问题,需在大量配点(collocation points)上计算高阶自动微分,对 GPU 显存容量和双精度浮点性能 要求极高。一个三维非稳态 N-S 方程的 PINN 训练,显存占用轻松突破 48GB。
环节三:湍流模型增强——从 RANS 到神经算子,精度与效率兼得
湍流是 CFD 的核心挑战。传统 RANS 模型(如 k-ω SST)在分离流、激波-边界层干扰等工况下精度不足,而直接数值模拟(DNS)和高保真 LES 的计算成本又令人望而却步。
AI 加速方式:
-
神经 RANS:利用 CNN/全连接网络从平均速度场学习雷诺应力各向异性张量,替代线性涡粘假设,显著提升分离流预测精度。
-
LES 亚格子应力(SGS)建模:使用 CNN 从滤波 DNS 数据中学习亚格子应力映射,在 2-4 倍粗化网格上实现接近 DNS 的统计精度。
-
傅里叶神经算子(FNO):直接在函数空间学习偏微分方程的映射,三维可压缩湍流的计算速度比传统 CFD 提升 100-1000 倍。
算力特征:FNO 需要在频域进行高维张量运算,3D 湍流代理模型的训练对 GPU 算力(TFLOPS)和显存带宽 提出极高要求。神经 RANS/SGS 的训练则需要大量 CFD 仿真数据作为标签,数据生成阶段的批量 CFD 求解 同样需要强劲的多核 CPU 支持。
环节四:代理模型与实时推理——毫秒级流场预测
对于需要反复评估的工况(如翼型优化、风场预测),训练一个"轻量级"神经网络代理模型,用推理替代重复求解,是 AI 赋能 CFD 最直接的路径。
AI 加速方式:
-
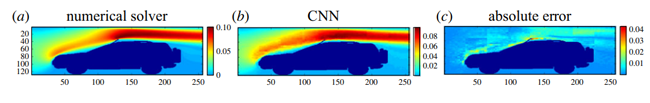
端到端 CNN/U-Net:学习从几何/边界条件到稳态流场的直接映射,毫秒级输出速度/压力场。
-
图神经网络(GNN):原生处理非结构化 CFD 网格,避免插值到规则网格带来的精度损失,实现翼型气动系数(Cl/Cd/Cm)的快速预测。
-
神经算子(DeepONet/FNO):学习无限维 PDE 映射,对新几何和新边界条件具有泛化能力。
-
扩散模型:从高分辨率湍流数据中学习概率分布,实现流场超分辨率重建和缺失数据补全。
算力特征:代理模型训练阶段需要 大规模并行 GPU 集群或高端工作站;推理阶段对单卡算力和显存容量要求相对较低,但 实时交互式可视化(如数字孪生系统中的近实时流场追踪)仍需 大显存专业显卡 支撑。
环节五:流场智能控制——DRL + CFD 实时闭环
主动流动控制(如圆柱减阻、翼型增升、涡轮叶片冷却优化)传统上依赖离线设计和经验调参。深度强化学习(DRL)将流控问题形式化为马尔可夫决策过程(MDP),让智能体在仿真环境中"试错学习"最优策略。
AI 加速方式:
-
DRL + OpenFOAM/Fluent 实时耦合:通过 MPI 通信实现神经网络与 CFD 求解器的双向闭环——流场状态驱动网络推理输出控制信号,控制信号更新边界条件后反馈新流场状态。
-
多目标优化:结合 NSGA-II 等遗传算法,在减阻、增升、抑振等冲突目标间寻找 Pareto 最优前沿。
算力特征:DRL 训练需要高频次的 CFD 仿真迭代(每一步动作都需一次流场推进),对 CPU 多核并行能力 和 GPU 低延迟推理 要求极高。同时,多智能体或多工况并行训练时,多 GPU 配置 可显著缩短训练周期。
二、AI-CFD 各环节对 GPU 的差异化需求
AI 在流体力学中的应用并非"一招鲜",不同环节对 GPU 的算力、显存、精度要求差异显著:
表格
| 应用场景 | 核心 GPU 需求 | 显存容量 | 精度要求 | 关键瓶颈 |
|---|---|---|---|---|
| LLM 驱动 CFD 自动化 | 大显存推理 | 24GB-96GB | FP16/FP8 | 显存容量 |
| PINN 无网格训练 | 大显存 + 高双精度算力 | 48GB-96GB | FP64 | 显存容量、自动微分开销 |
| FNO/神经算子训练 | 高算力 + 高显存带宽 | 48GB-96GB | FP32/TF32 | 算力(TFLOPS)、带宽 |
| GNN 流场预测 | 高显存带宽 + 大显存 | 32GB-48GB | FP32 | 图结构内存访问模式 |
| CNN/U-Net 代理模型 | 高算力 + 中等显存 | 24GB-48GB | FP16/FP32 | 算力、数据吞吐量 |
| DRL + CFD 实时耦合 | 低延迟推理 + 多卡并行 | 24GB-48GB ×2+ | FP32 | 推理延迟、多卡扩展 |
| CFD 传统求解(LES/DNS) | 大显存用于后处理可视化 | 48GB-96GB | FP32/FP64 | 显存容量(大模型后处理) |
核心结论:
-
显存容量是第一硬指标:3D 湍流 PINN 训练、FNO 高分辨率频域运算、LLM 本地部署,均要求 48GB 以上显存,24GB 在中等规模即会触顶。
-
双精度(FP64)对 PINN 至关重要:物理方程残差的精确计算依赖高精度,消费级显卡的 FP64 性能仅为 FP32 的 1/32-1/64,专业卡(RTX Pro 系列)的 FP64 性能是消费卡的数倍。
-
显存带宽决定训练效率:神经算子和 GNN 的训练属于内存密集型任务,高带宽显存(HBM/GDDR6X)直接影响迭代速度。
三、专业图形工作站硬件配置推荐
基于上述 AI-CFD 全链路的算力需求,我们设计了三档 UltraLAB 专业图形工作站配置方案。
方案A:PINN研究与中小规模AI-CFD开发工作站
适用场景:PINN入门与二维/简单三维流场求解、U-Net/GNN代理模型训练、LLM辅助CFD配置生成
适用软件:PyTorch + DeepXDE/SciANN、OpenFOAM、ANSYS Fluent
适用软件:PyTorch + DeepXDE/SciANN、OpenFOAM、ANSYS Fluent
表格
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon W7-2495X(24核48线程,液冷超频至4.8GHz+)或 AMD Ryzen 9 9950X | 高频多核兼顾传统CFD求解与AI训练数据预处理 |
| 内存 | 128GB DDR5-5600 RDIMM(4×32GB) | PINN训练需在大量配点上计算自动微分,内存峰值高;ECC纠错保障长时间训练稳定性 |
| 显卡 | NVIDIA RTX Pro 5000 48GB | 32GB显存覆盖中等规模PINN和神经算子训练;专业卡FP64性能是消费卡数倍,保障物理残差计算精度 |
| 系统盘 | 2TB NVMe Gen4 SSD | 操作系统、PyTorch/TensorFlow、CFD软件快速启动 |
| 数据盘 | 8TB SATA 企业级 HDD | CFD仿真数据集、训练模型检查点、结果文件存储 |
| 散热 | 360mm 一体式水冷 | 压制超频CPU满载功耗,保障长时间训练不降频 |
| 参考机型 | UltraLAB AX430 或 AR350 |
方案B:大规模3D湍流代理模型与多物理场耦合工作站
适用场景:三维可压缩湍流FNO训练、高保真LES数据驱动的SGS建模、扩散模型流场重建、多物理场耦合代理模型
适用软件:PyTorch + NeuralOperator、OpenFOAM + PyTorch、ANSYS Fluent
适用软件:PyTorch + NeuralOperator、OpenFOAM + PyTorch、ANSYS Fluent
表格
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | AMD Threadripper PRO 7975WX(32核64线程)或 Intel Xeon W7-3465X(28核56线程,液冷超频) | 超多核支撑批量CFD仿真数据生成(训练标签);高频保障单线程网格划分效率 |
| 内存 | 256GB DDR5 RDIMM(8×32GB) | 3D高分辨率流场数据(1024³体素)单张即数GB,批量加载训练需大内存;多物理场耦合数据更占内存 |
| 显卡 | NVIDIA RTX Pro 6000 96GB(Blackwell架构)或 RTX 6000 Ada 48GB ×2(NVLink) | 96GB单卡显存可承载大规模3D FNO/PINN训练;Blackwell原生FP4/FP8支持,加速混合精度训练;NVLink实现双卡显存池化 |
| 系统盘 | 2TB NVMe U.2 企业级 SSD | 高读写寿命、高稳定性,应对AI训练过程中的海量临时文件IO |
| 数据盘 | 8TB NVMe U.2 SSD + 16TB SATA 企业级 HDD | 全闪存阵列保障高分辨率流场数据的批量读取吞吐;HDD用于冷数据归档 |
| 散热 | 双水排+双水泵水冷散热系统或2000W级360mm水冷 | CPU+GPU双满载场景下维持低温,避免训练中断 |
| 参考机型 | UltraLAB GR450P 或 GT430P |
方案C:旗舰级AI-CFD全栈平台(DRL实时耦合 + 大模型 + 多用户共享)
适用场景:DRL+CFD实时闭环控制训练、LLM驱动的端到端CFD自动化、多用户并发AI-CFD研发、数字孪生系统
适用软件:Stable-Baselines3 + OpenFOAM、DeepSeek/通义千问本地部署、多代理CFD框架
适用软件:Stable-Baselines3 + OpenFOAM、DeepSeek/通义千问本地部署、多代理CFD框架
表格
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX(96核192线程)或 Intel Xeon 696X(64核128线程) | 顶级核心数,支撑DRL训练中高频次的CFD环境并行推进;多用户共享时的资源隔离 |
| 内存 | 512GB DDR5 RDIMM | DRL训练需同时维护多个CFD环境状态;LLM本地部署(70B参数)需数百GB内存;多任务并发冗余 |
| 显卡 | NVIDIA RTX Pro 6000 96GB ×2 | 双卡192GB显存池,可同时运行LLM推理(DeepSeek-R1 32B/70B)+ PINN/FNO训练 + CFD后处理可视化 |
| 存储 | 4TB NVMe U.2 SSD(系统+活跃项目)+ 32TB SATA 企业级 RAID5 | 全闪存保障DRL实时耦合的低延迟IO;RAID5保障数字孪生项目数据安全 |
| 网络 | 万兆以太网 | 团队共享平台的数据高速交互,远程提交与结果回传 |
| 散热 | 双塔式+双水排+双水泵水冷散热系统 | 96核CPU + 双路GPU持续满载的终极散热,保障7×24小时不间断训练 |
| 参考机型 | UltraLAB GR450P 或GT450P |
四、选型建议与总结
AI 与流体力学的融合正在加速,但不同技术路线对硬件的需求差异巨大:
表格
| 你的核心方向 | 关键硬件指标 | 推荐方案 |
|---|---|---|
| PINN 无网格求解 | 大显存(48GB+)+ 强FP64 | 方案A(32GB起步)或 方案B(96GB) |
| 神经算子/FNO 代理模型 | 高算力 + 高显存带宽 + 大显存 | 方案B(RTX Pro 6000 96GB) |
| DRL + CFD 实时耦合 | 超多核CPU + 多GPU + 低延迟存储 | 方案C(双路GPU + 96核CPU) |
| LLM 驱动 CFD 自动化 | 大显存(48GB+)+ 大内存(256GB+) | 方案B 或 方案C |
| 传统 CFD(LES/DNS)+ AI 后处理 | 多核CPU + 大显存GPU(可视化) | 方案B |
从 PINN 的物理嵌入到 FNO 的频域加速,从 GNN 的非结构化网格处理到 DRL 的实时流控,AI 正在让流体力学从"算得准但算得慢"走向"又快又准"。而在这条技术路线的每一个节点上,GPU 显存容量和专业级的双精度算力,都是决定你能走多远的天花板。
当你的竞争对手还在用超算排队等 LES 结果时,你已经用神经算子在本地工作站上完成了百倍加速的代理模型训练——这就是 AI-CFD 时代的新竞争力。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


