






导读:做仿真的博士、工程师们,你是否经历过这样的痛苦——同一个模型,改个材料参数就要重新点一遍界面,几十组参数扫描下来,一天就过去了。本文介绍一种"AI写脚本、COMSOL跑仿真"的自动化工作流,彻底告别重复劳动,并给出匹配该工作流的硬件配置方案。
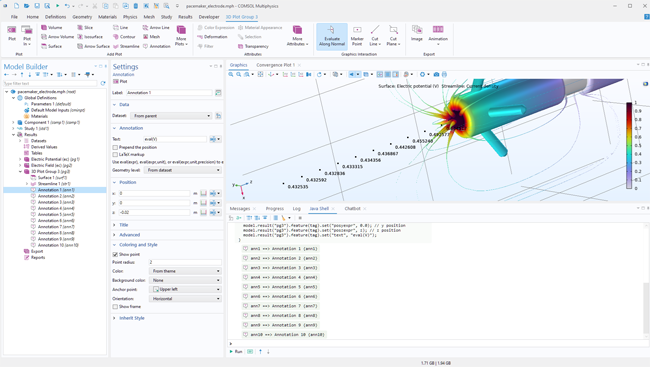
一、传统仿真的痛点:不是算得慢,是"点得慢"
用COMSOL做科研仿真的朋友,对这套流程再熟悉不过:
plain
打开图形界面 → 建几何 → 选物理场 → 设材料 → 画网格 → 跑求解 → 导出结果
一次建模没问题,十次重复要人命。
导师让你对比5种材料、3种温度、4种边界条件组合——60组参数扫描,如果全靠手动在界面里改,意味着什么?
-
每改一个参数,就要重新点进设置项
-
容易漏改、错改,结果不可复现
-
晚上挂着算,第二天发现其中3组参数设错了,全部重来
真正消耗时间的,不是求解器的计算,而是人工重复操作。
二、Codex+COMSOL:让AI写脚本,你只管做物理判断
OpenAI Codex(以及类似的AI编程助手)与COMSOL的结合,核心逻辑不是"AI替你点按钮",而是"AI帮你写自动化脚本,COMSOL负责专业求解"。
2.1 COMSOL的自动化接口:脚本化的基础
COMSOL本身提供了完善的程序化接口:
表格
| 接口类型 | 适用场景 | 脚本语言 |
|---|---|---|
| Java API | 独立脚本运行、批量计算 | Java |
| LiveLink for MATLAB | 与MATLAB数据交互、后处理 | MATLAB |
| Model Methods | 模型内部自动化操作 | Java |
这意味着:你在图形界面里点的每一步,都可以转化为代码。
2.2 推荐工作流:五步实现仿真自动化
第一步:图形界面建基准模型
在COMSOL GUI中完成基础建模——几何、物理场、边界条件、网格设置。这是你的"物理锚点",确保模型本身正确。
第二步:导出脚本
从COMSOL中导出Java脚本或LiveLink for MATLAB脚本。此时你得到的是一段完整的、可执行的代码,记录了刚才所有操作。
第三步:交给Codex解释与整理
将脚本交给AI,让它逐段解释每部分在做什么(
model.geom、model.physics、model.study等结构),确保你理解代码逻辑。
第四步:让Codex改造成批量运行
这是核心价值点。向AI提出需求:
"请把这个脚本改成for循环结构,自动扫描温度从20°C到200°C、扩散系数从1e-9到1e-6,每组结果导出为单独文件。"
AI会帮你加入参数循环、自动命名、结果归档逻辑。
第五步:执行脚本并批量出结果
在COMSOL Batch模式或MATLAB中运行脚本,人去喝咖啡,机器自动跑完所有参数组合。
三、Codex在仿真工作流中的五大实战用途
表格
| 功能 | 典型应用场景 | 效率提升 |
|---|---|---|
| 生成脚本框架 | 从零开始写Java API代码,快速搭建建模-求解-导出全流程 | 省去查文档时间 |
| 解释已有脚本 | 看懂别人(或自己半年前)写的复杂脚本 | 降低代码阅读门槛 |
| 改造批量运行 | 单参数模型 → 多参数自动扫描 | 效率提升5~20倍 |
| 检查报错 | 脚本运行失败时,定位标签错误、路径问题、参数未定义 | 减少Debug时间 |
| 结果整理 | 自动生成MATLAB/Python后处理脚本,批量绘图制表 | 后处理自动化 |
关键原则:AI负责代码和重复劳动,你负责物理假设、边界条件检查和结果解释。
四、计算特点分析:AI辅助仿真对硬件提出了什么新要求?
引入Codex自动化工作流后,计算负载发生了结构性变化——不再是单纯的"COMSOL单机计算",而是"AI脚本生成 + 批量仿真求解 + 大数据后处理"的混合负载。
4.1 COMSOL本身的计算特征
表格
| 计算环节 | 硬件依赖 | 瓶颈特征 |
|---|---|---|
| 几何建模/网格划分 | CPU单核性能 | 主频敏感,部分操作串行 |
| 稀疏矩阵组装 | CPU多核+内存带宽 | 多线程并行,内存带宽敏感 |
| 线性/非线性求解 | CPU多核+大内存 | 大规模稀疏矩阵求解,内存容量敏感 |
| 参数扫描(Parametric Sweep) | CPU多核 | embarrassingly parallel,核心数=并行度 |
| 后处理/可视化 | CPU+GPU | 大数据量渲染,显存和内存双敏感 |
4.2 叠加AI辅助后的新增负载
表格
| 新增负载 | 计算特征 | 硬件影响 |
|---|---|---|
| AI脚本生成(本地LLM) | GPU推理或CPU推理 | 若本地部署7B~70B模型,需大显存GPU |
| 脚本解释/调试 | 低延迟交互 | 内存容量充足保障多任务切换 |
| 批量结果文件I/O | 高频随机读写 | NVMe SSD阵列,拒绝机械盘 |
| 多组结果后处理 | 并行数据处理 | 多核CPU+大内存 |
4.3 核心结论
AI辅助批量仿真的硬件瓶颈,从"单任务求解速度"转向"多任务并发吞吐+系统I/O带宽":
-
CPU:需要高主频(保障单模型网格/组装速度)+ 超多核(保障参数扫描并行度)
-
内存:容量必须大——多物理场模型本身吃内存,批量扫描时多个求解器实例共存更吃内存
-
存储:高速NVMe阵列——批量仿真产生大量中间文件和结果文件,机械盘会成为灾难
-
GPU:视AI部署方式而定。若调用云端API(如OpenAI官方Codex),本地无需GPU;若本地部署开源大模型辅助编程,建议配备中高端GPU
五、硬件配置推荐:UltraLAB定制图形工作站方案
基于上述计算特点,针对"COMSOL + AI辅助自动化仿真"的科研场景,推荐以下三套配置:
方案A:参数扫描专用工作站(CPU密集型)
适用场景:以COMSOL参数扫描、批量仿真为主,AI调用云端API
相关机型 UltraLAB AR350 或 AX430
表格
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 1× AMD 锐龙9 9950X 或 1× Intel Xeon W7-3465X | 高主频(≥4GHz Boost)保障单模型速度;16~28核保障并行扫描 |
| 内存 | 128GB~256GB DDR5-4800 ECC | 多物理场模型动辄几十GB;批量扫描需同时驻留多组数据 |
| 系统盘 | 1× 2TB NVMe M.2 SSD | 系统+软件快速响应 |
| 数据盘 | 4× 4TB NVMe U.2 SSD (RAID 0) | 批量结果文件高速写入,总吞吐≥12GB/s |
| GPU | 可选 RTX Pro 4000 24GB | 本地轻量AI辅助+COMSOL后处理加速 |
| 散热 | 360mm液冷+风道优化 | 保障CPU持续满载不降频 |
预估参数扫描效率:相比传统手动操作,整体科研效率提升8~15倍(含建模+计算+后处理)。
方案B:AI本地部署+COMSOL全能工作站(CPU+GPU均衡型)
适用场景:需要本地部署大语言模型(如DeepSeek、Qwen-Coder)辅助写脚本,同时进行COMSOL重度仿真
相关机型 UltraLAB EA660 或 EX670
表格
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× AMD EPYC 9575F / 2× Intel Xeon 6582P | 双路高主频,兼顾单核性能与全核并行 |
| GPU | 1× RTX Pro 6000 96GB / 2× RTX Pro 5000 48GB | 本地运行32B~70B参数代码大模型;COMSOL GPU加速 |
| 内存 | 256GB~512GB DDR5-4800 RDIMM | 双路平台大内存通道,保障AI推理+COMSOL求解不抢资源 |
| 存储 | 3.84TB NVMe U.2 + 6× 7.68TB NVMe U.2 | 系统高可用+数据高吞吐 |
| 网络 | 双万兆网卡 | 云端模型下载、团队协作共享 |
特色价值:本地AI实时生成脚本 → 本地COMSOL即时验证 → 闭环迭代,无需上传敏感模型数据到云端。
方案C:课题组共享仿真服务器(多用户并发型)
适用场景:课题组5~10人共用,同时运行多个COMSOL模型+AI辅助
相关机型 UltraLAB GA660M 或GT450M
表格
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× AMD EPYC 9684X / Intel Xeon 6980P | 64~128核,支撑多用户多任务并发 |
| GPU | 2× RTX Pro 6000 96GB | 多用户共享AI推理服务;显存大=可同时加载多个模型 |
| 内存 | 512GB~1TB DDR5-4800 RDIMM | 多用户+多实例COMSOL的内存黑洞必须填满 |
| 存储 | 全闪存阵列:8× 7.68TB NVMe U.2 + 1块NVME RAID卡 | 多用户同时读写不卡顿 |
| 远程桌面 | 多用户GPU虚拟化 / 物理分区 | 5用户以上同时远程使用 |
六、使用建议与避坑指南
结合原文经验,给出实操建议:
-
分步验证,不要一次让AI写太复杂的模型
-
先让它生成几何脚本 → 确认正确 → 再加物理场 → 再加求解器
-
每步在COMSOL中验证后再继续
-
-
物理判断必须人工把关
-
AI可以写代码,但不懂你的物理假设
-
边界条件、材料参数、控制方程必须自己检查
-
-
养成备份习惯
-
让Codex修改脚本前,先备份原始
.mph文件和脚本 -
版本管理(Git)对仿真脚本同样适用
-
-
要求AI解释修改内容
-
不要只让它"帮我改",要追问:"你改了哪些地方?为什么这样改?有什么风险?"
-
-
硬件上优先投资内存和存储
-
参数扫描时,内存不足会导致求解器频繁换页,性能断崖式下跌
-
机械硬盘在批量I/O场景下是致命瓶颈,必须全闪存
-
结语
科研仿真的未来,不是"人 vs AI",而是"人+AI+高性能硬件"的三位一体。
Codex负责把重复劳动变成可复用代码,COMSOL负责专业物理求解,而一台算力充沛、内存充足、存储高速的UltraLAB工作站,负责让这套流程跑得又快又稳。
让AI写脚本,让机器跑批量,让工程师回归物理本质——这才是智能时代仿真正确的打开方式。
本文工作流参考自《Codex连接COMSOL:让AI帮你写仿真脚本,而不是手动重复点按钮》,硬件方案由UltraLAB定制图形工作站提供。
如需针对您的COMSOL仿真场景(电磁/流体/结构/传热/多物理场耦合)定制工作站配置,欢迎私信获取详细方案与报价。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


