






自动驾驶的终极安全,不能靠"路测里程"堆出来,而要靠"数字孪生"算出来。当Ansys AVxcelerate Sensors与NVIDIA Omniverse深度握手,一条从真实世界捕获、到虚拟环境重建、再到传感器闭环验证的"仿真高速公路"已然贯通。
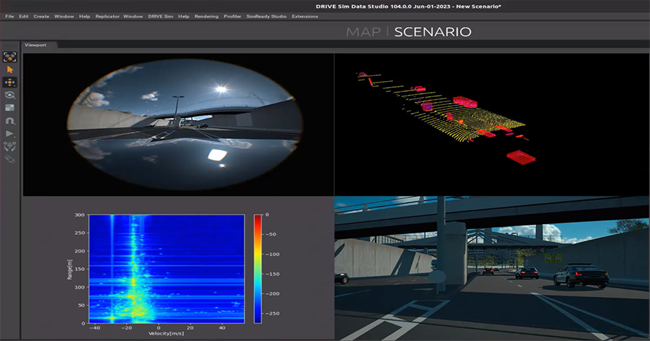
自动驾驶(AV)系统的复杂度正呈指数级攀升。随着运行设计域(ODD)不断扩展,传统的"孤岛式仿真"已无法满足安全验证需求——摄像头、雷达、激光雷达、热成像等多源传感器在雨雾、眩光、夜间等极端场景下的协同表现,必须在虚拟世界中被精确复现、批量测试、快速迭代。
Ansys AVxcelerate Sensors 2026 R1 的发布,正是对这一痛点的系统性回应。通过与 NVIDIA Omniverse 及 NIM 推理微服务 的深度集成,该方案构建了一套基于物理的传感器感知数字孪生体系,让"真实世界—数字世界—芯片算法"形成完整闭环。
一、五大核心技术环节:从"采数据"到"训算法"
1. 真实场景数字化重建
基于Omniverse生态,工程师可将真实道路采集数据(点云、图像、GIS信息)导入虚拟环境,通过USD(Universal Scene Description)格式构建可复用的三维数字资产。支持Cesium地理空间数据与TurboSquid高质量模型库的直接调用,实现"真实世界一键入模"。
2. 多物理场资产优化
重建后的场景并非"视觉花瓶"。AVxcelerate Sensors引入Ansys多物理场材料定义,对场景中的几何结构进行光学、电磁学、热学属性的多光谱标注。路面、金属护栏、玻璃幕墙、雨雾粒子——每一种材质都必须携带真实的物理指纹,才能确保传感器仿真的可信度。
3. 基于物理的合成传感器生成
这是整个工作流的核心引擎:
-
光传播引擎:精确建模光线在复杂介质中的传播、反射、散射与眩光效应,复现摄像头在逆光、雨雾、夜间低照度下的成像挑战;
-
物理级雷达仿真:基于电磁波传播方程,结合材料介电属性、表面粗糙度、入射角度,生成包含多径效应、遮挡衰减的雷达回波数据;
-
激光雷达与热成像:同样遵循物理第一性原理,输出高保真点云与热分布图。
4. 场景泛化与边缘案例生成
通过Omniverse中的Omnigraph节点化编程与Replication随机化工具,工程师可对已重建的场景进行参数化变异:调整光照角度、改变天气条件、随机化交通参与者位置、引入罕见障碍物。无需重新采集,即可批量生成数十万级边缘案例,大幅压缩路测成本。
5. 传感器感知闭环验证
最终,合成传感器数据直接注入自动驾驶感知算法(目标检测、语义分割、传感器融合),在虚拟环境中完成"感知—决策—规划"的全链路验证。验证结果又可反馈至场景库优化,形成"采集→重建→仿真→验证→迭代"的飞轮。
二、计算特点:为什么这是一套"GPU原生"的负载
AVxcelerate Sensors-Omniverse集成方案的底层计算特征,决定了它对硬件的诉求与传统CAE仿真截然不同:
表格
| 计算维度 | 特征描述 | 硬件影响 |
|---|---|---|
| GPU原生渲染 | 光线传播、电磁仿真、USD场景实时渲染均基于CUDA/OptiX,几乎完全依赖GPU加速 | 高端专业GPU是刚需,CPU仅承担调度与预处理 |
| 多光谱物理计算 | 光学(可见光/红外)、电磁(毫米波雷达)、热学(红外热成像)多物理场耦合 | 显存容量决定单场景复杂度,带宽决定实时性 |
| 大规模USD场景 | 城市级地理空间数据、高精细度模型、多图层语义标注 | 内存+显存双重敏感,需大容量、高带宽存储支撑 |
| 实时交互与随机化 | Omnigraph节点实时响应、Replication参数化批量生成 | 要求低延迟IO与GPU并行能力,避免交互卡顿 |
| 合成数据集生成 | 批量渲染百万张带标注图像/点云,用于AI模型训练 | 长时间满载渲染,对散热稳定性与7×24可靠性要求极高 |
| NIM推理微服务 | 集成NVIDIA NIM进行物理AI推理加速 | 需支持TensorRT与AI推理管线,GPU需具备AI加速单元 |
一句话总结:这不是传统的"CPU求解器+小内存"型仿真,而是"GPU算力+大显存+大内存+高速IO"的图形与物理混合计算负载。
三、软件工具链全景
表格
| 层级 | 软件/工具 | 作用 |
|---|---|---|
| 核心仿真平台 | Ansys AVxcelerate Sensors 2026 R1 | 传感器物理仿真、合成数据生成、感知闭环验证 |
| 数字孪生底座 | NVIDIA Omniverse | USD场景管理、实时渲染、多工具协同、数字资产库 |
| AI推理加速 | NVIDIA NIM 推理微服务 | 物理AI模型推理加速、生成式AI辅助场景构建 |
| 场景数据源 | Cesium / TurboSquid | 地理空间数据、高质量预构建USD资产 |
| 场景编排 | Omniverse Omnigraph / Replication | 节点化场景逻辑、参数化随机化、数据集批量生成 |
| 算法验证 | AVxcelerate Autonomy + medini | 自动驾驶功能安全(SOTIF)分析、预期功能安全验证 |
四、硬件配置推荐:分场景精准匹配
基于上述计算特征,我们为不同规模的自动驾驶仿真团队提供三套配置方案:
方案A:单工程师研发工作站(入门级)
适合算法工程师个人开发、小规模场景验证、传感器参数调优。
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | Intel Core Ultra 9 285K / AMD Ryzen 9 9950X | 16核32线程,主频高,负责USD预处理与数据IO |
| GPU | NVIDIA RTX 6000 Ada Generation 48GB ×1 | Omniverse官方推荐专业卡,48GB显存可承载中等规模城市场景 |
| 内存 | 128GB DDR5-5600 ECC | USD场景、多光谱材质、缓存数据极其吃内存 |
| 系统盘 | 2TB NVMe Gen4 SSD | 系统+软件+缓存 |
| 数据盘 | 4TB NVMe Gen4 SSD + 8TB SATA HDD | NVMe存放活跃项目,HDD归档历史数据集 |
| 网络 | 10GbE | 拉取Cesium地理数据、团队共享资产库 |
| 显示器 | 32英寸 4K 专业色彩显示器 | 传感器图像质量主观评估 |
| 机箱/散热 | 全塔机箱 + 360mm水冷 | 单卡满载渲染功耗高,静音散热保障长时间运行 |
相关机型 Ultra LAB A350 或AR350
方案B:团队协同仿真服务器(专业级)
适合5-10人仿真团队、城市级场景重建、多传感器并行验证、合成数据集批量生成。
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | Intel Xeon W9-3495X / AMD Threadripper PRO 7995WX | 64核128线程,应对多用户并发、大规模USD编译 |
| GPU | NVIDIA RTX 6000 Ada 48GB ×2 或 RTX A6000 ×4 | NVLink互联,多卡分担城市场景渲染与雷达电磁计算 |
| 内存 | 512GB DDR5-4800 ECC RDIMM | 多用户+大场景,内存是瓶颈而非CPU |
| 系统盘 | 2× 1.92TB NVMe Gen4 SSD (RAID 1) | 系统冗余,避免单点故障 |
| 数据盘 | 4× 7.68TB NVMe Gen4 SSD (RAID 10) | 高速阵列,支撑并发读写与海量合成数据流 |
| 网络 | 双口 25GbE + 10GbE | 25GbE连接存储/渲染农场,10GbE连接办公网 |
| 远程管理 | IPMI + NVIDIA Omniverse Enterprise | 远程排队渲染、资源调度、团队协同 |
| 电源 | 2000W 钛金冗余电源 | 4卡满载功耗可达1500W+,冗余保障安全 |
相关机型:UltraLAB GT430P 或GR450P
方案C:数据中心级仿真集群(企业级)
适合整车厂、Tier 1供应商、大规模SOTIF验证、ENCAP 2026等法规测试、百万级边缘案例生成。
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| 节点形态 | 2U/4U GPU服务器 | 数据中心标准机架,支持8卡全高全长GPU |
| CPU | 2× Intel Xeon 6700 / AMD EPYC 9005 | 高核心数+高内存带宽,支撑数据预处理与任务调度 |
| GPU | NVIDIA H100 80GB ×8 或 L40S 48GB ×8 | H100用于大规模并行推理与训练,L40S性价比渲染方案 |
| 内存 | 2TB DDR5-4800 | 超大规模USD场景、多任务并发 |
| 存储 | 全闪存NVMe-oF阵列 100TB+ | 分布式高速存储,支撑多节点并发访问PB级场景库 |
| 网络 | NVIDIA InfiniBand NDR 400Gb/s 或 200GbE RDMA | GPU Direct RDMA,消除节点间数据搬运瓶颈 |
| 软件栈 | NVIDIA Omniverse Enterprise + Ansys AVxcelerate Enterprise + NIM | 企业级授权,支持多用户协同、版本管理、云端部署 |
| 基础设施 | 液冷散热 + 智能PDU | 8×H100功耗超3000W,风冷已无法满足 |
相关机型:GX668或GA668,集群规模视项目而定
五、选型建议与避坑指南
-
显存是第一瓶颈:城市场景+多光谱材质极易吃满显存。若预算受限,优先保显存容量(48GB),而非GPU数量。
-
内存不可妥协:Omniverse的USD场景编译是内存密集型操作。128GB是起步线,团队级建议512GB起步。
-
SSD比HDD更重要:频繁读写USD资产、缓存光传播计算结果,NVMe SSD的随机IO性能直接决定交互流畅度。
-
专业卡优于游戏卡:Omniverse对RTX专业卡的驱动优化、显存纠错、长时间稳定性支持远优于消费级显卡。
-
网络决定协同效率:团队级部署务必配备25GbE以上网络,否则大场景文件的共享传输将成为效率黑洞。
结语:仿真即安全
当Ansys AVxcelerate Sensors与NVIDIA Omniverse握手,自动驾驶开发进入了一个新范式:真实世界被"无损压缩"进数字孪生,传感器在虚拟空间中经受数百万次"暴风雨"洗礼,算法在边缘案例中被反复锤炼。
这不仅是工具的升级,更是安全哲学的升级——从"路测撞了再改"到"仿真穷尽再上路"。而支撑这一哲学落地的,正是一套以GPU为核心、以物理精确为灵魂、以海量数据为燃料的算力底座。
对于正在规划仿真平台的自动驾驶团队而言,硬件配置不是成本,而是安全投资的杠杆。 选对配置,才能让"从道路到芯片"的闭环,真正跑起来。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


