






——PowerFLOW气动声学、XFlow高保真瞬态、Fluid Dynamics Engineer多物理场,如何匹配硬件释放极致性能?
一、引言:CFD仿真的"速度-精度"困局如何破局?
计算流体力学(CFD)是现代工程设计的核心工具,但传统CFD面临一个根本矛盾:模型精度越高,网格越精细,计算量呈指数级增长。一个整车外流场仿真可能需要数亿网格单元,一个瞬态气动声学分析可能需要数百万时间步。没有与之匹配的算力平台,再先进的物理模型也只能停留在"理论上可行"。
达索系统SIMULIA 计算流体动力学产品组合,以 PowerFLOW 和 XFlow 为核心引擎,基于 格子玻尔兹曼方法(LBM) 提供高保真瞬态仿真能力,辅以 Fluid Dynamics Engineer 在 3DEXPERIENCE平台 上实现多尺度多物理场协同,为工程师提供了从概念设计到详细验证的完整CFD仿真能力。
但这份"全栈"能力的释放,离不开与之匹配的硬件平台——LBM的GPU加速、Navier-Stokes的稀疏矩阵迭代、气动声学的频域分析、多物理场的耦合迭代,每一项都在"压榨"算力。本文将从模块组成、计算特点、应用场景到硬件配置,为您全面拆解。
二、SIMULIA CFD 核心软件模块详解
模块一:PowerFLOW — 高保真气动声学仿真
主要功能:
-
基于LBM的瞬态CFD仿真
-
自动笛卡尔网格生成(无需手动划分)
-
真实几何处理(无需简化/清理CAD)
-
气动声学预测(风噪、社区噪声)
-
多孔介质、热交换、化学反应
-
与PowerACOUSTICS联动进行噪声分析
-
与PowerTHERM联动进行热分析
-
与PowerCOOLING联动进行电子散热
计算特点:
表格
| 特性 | 说明 | 硬件依赖 |
|---|---|---|
| LBM瞬态推进 | 格子玻尔兹曼方程显式时间推进 | GPU CUDA核心 + 显存 |
| 自动网格 | 笛卡尔网格自动适应几何,无需人工干预 | GPU显存容量 |
| 真实几何 | 直接导入原始CAD,无需简化 | 网格规模增加 |
| 瞬态统计 | 需长时间平均获得稳态统计量 | GPU持续高负载 |
| 气动声学 | 瞬态压力脉动 → FFT → 声压级 | 瞬态数据量巨大 |
| 多物理场 | 流-热-声-结构耦合 | CPU+GPU协同 |
关键洞察: PowerFLOW的LBM求解器是GPU密集型——LBM的局部碰撞- streaming 操作天然适合GPU并行,NVIDIA GPU加速可将求解速度提升 5-20倍。但LBM的笛卡尔网格在复杂几何附近需要精细加密,网格规模可达数千万至数亿,GPU显存是硬瓶颈。PowerFLOW的瞬态特性意味着需要长时间运行(物理时间数秒至数十秒)以获得统计稳态结果,GPU持续高负载是常态。
应用场景:
-
汽车整车/部件空气动力学(Cd、Cl优化)
-
汽车风噪(A柱、后视镜、轮胎)
-
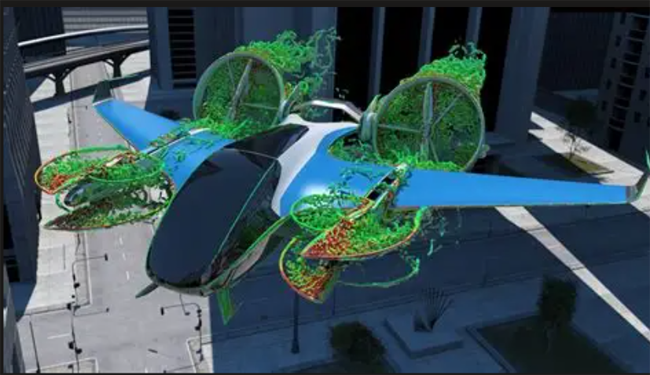
eVTOL飞行性能与社区噪声
-
赛车空气动力学优化
-
建筑风环境(行人风舒适性)
-
电子散热(数据中心、功率模块)
模块二:XFlow — 高保真瞬态CFD
主要功能:
-
基于LBM的瞬态CFD仿真
-
无网格粒子法(SPH-like)选项
-
自由表面流(溢流、晃动、喷射)
-
多相流(气液、液固)
-
流固耦合(FSI)
-
颗粒流(与DEM耦合)
-
化学反应与燃烧
计算特点:
表格
| 特性 | 说明 | 硬件依赖 |
|---|---|---|
| LBM瞬态推进 | 与PowerFLOW类似,显式时间推进 | GPU CUDA核心 + 显存 |
| 自由表面 | 界面追踪 + 表面张力 | GPU显存增加 |
| 多相流 | 多组分LBM + 界面重构 | 计算量增加 |
| FSI | 流体场 → 结构变形 → 流体场迭代 | CPU+GPU协同 |
| 颗粒流 | LBM + DEM耦合 | GPU+CPU协同 |
关键洞察: XFlow与PowerFLOW共享LBM核心技术,但XFlow更侧重于自由表面、多相流、FSI等复杂流动场景。这些场景的界面追踪和多物理场耦合增加了计算复杂度,对GPU显存和CPU内存的需求更高。
应用场景:
-
船舶水动力学(阻力、耐波性)
-
油箱晃动(汽车、航空)
-
喷涂/涂覆工艺
-
水力机械(泵、涡轮)
-
环境流(溢油、污染物扩散)
模块三:Fluid Dynamics Engineer — 3DEXPERIENCE平台CFD
主要功能:
-
基于3DEXPERIENCE平台的CFD仿真
-
嵌入设计流程的MODSIM(建模即仿真)
-
多尺度多物理场分析
-
与CATIA/SOLIDWORKS几何无缝集成
-
设计探索与优化(DoE)
-
仿真数据管理(SPDM)
-
业务智能与报告生成
计算特点:
-
MODSIM工作流:CAD几何直接用于CFD,减少数据转换
-
DoE参数扫描:大量设计点批量计算
-
多物理场:流-固-热-声耦合
-
云端HPC:弹性扩展计算资源
关键洞察: Fluid Dynamics Engineer的核心价值在于流程整合——将CFD嵌入设计流程,实现"设计即仿真"。其底层求解器与PowerFLOW/XFlow共享,计算特点相同,但增加了设计探索的批量计算需求。
应用场景:
-
概念设计阶段快速评估
-
设计空间探索(参数化扫描)
-
跨团队协作与数据管理
-
仿真驱动的优化设计
模块四:Plastics Injection Molding — 注塑成型仿真
主要功能:
-
塑料件注塑成型工艺仿真
-
模具填充、保压、冷却分析
-
翘曲变形预测
-
纤维取向分析
-
与结构仿真耦合(残余应力 → 力学性能)
计算特点:
-
Hele-Shaw近似:薄壁件专用简化模型
-
非牛顿流体:剪切变稀粘度模型
-
耦合求解:流动 + 热传导 + 凝固
-
纤维取向:悬浮纤维动力学
应用场景:
-
汽车内饰件注塑
-
消费电子外壳
-
医疗器械塑料件
-
包装容器
三、SIMULIA CFD 计算特点总览
表格
| 模块 | 核心算法 | 计算密集度 | 硬件瓶颈 |
|---|---|---|---|
| PowerFLOW(LBM) | 格子玻尔兹曼显式推进 | ★★★★★ | GPU显存 + CUDA核心 |
| XFlow(LBM) | 格子玻尔兹曼 + 自由表面 | ★★★★★ | GPU显存 + CUDA核心 |
| XFlow(FSI) | LBM + 结构耦合迭代 | ★★★★★ | CPU+GPU协同 |
| Fluid Dynamics Engineer | LBM/NS + DoE | ★★★★☆ | GPU + CPU多核 |
| Plastics Injection | Hele-Shaw + 非牛顿流 | ★★★☆☆ | CPU多核 |
关键洞察: SIMULIA CFD的"算力密码"是GPU为核心——LBM算法天然适合GPU并行,PowerFLOW和XFlow的求解速度直接取决于GPU的CUDA核心数和显存容量。CPU主要负责前后处理、多物理场耦合和参数扫描。一套理想的SIMULIA CFD工作站,必须GPU优先、显存充足、CPU辅助。
四、应用场景:SIMULIA CFD 的"全栈覆盖"
场景一:汽车空气动力学与风噪(★★★★★)
典型任务: 整车Cd/Cl优化、A柱风噪、后视镜噪声、轮胎泵气
工作流程:
-
PowerFLOW直接导入整车CAD(无需简化)
-
自动笛卡尔网格生成
-
GPU加速瞬态LBM求解
-
瞬态压力脉动 → PowerACOUSTICS分析声压级
-
DoE参数扫描优化外形
硬件需求: GPU(LBM核心)+ 大显存(整车网格)+ 多核CPU(DoE)
场景二:eVTOL飞行与社区噪声(★★★★★)
典型任务: 旋翼气动性能、社区噪声评估、飞行包线验证
工作流程:
-
PowerFLOW仿真旋翼非定常流场
-
瞬态压力脉动 → 噪声频谱分析
-
多旋翼干扰分析
-
社区噪声地图生成
硬件需求: GPU(瞬态LBM)+ 大显存(旋翼精细网格)
场景三:赛车空气动力学(★★★★)
典型任务: 下压力/阻力优化、DRS效应、轮胎热管理
工作流程:
-
PowerFLOW仿真整车外流场
-
DoE优化前翼、尾翼、底板参数
-
与PowerTHERM耦合分析轮胎热管理
硬件需求: GPU(LBM)+ 多核CPU(DoE批量)
场景四:船舶与海洋工程(★★★★)
典型任务: 阻力预测、耐波性、螺旋桨空化、甲板溅湿
工作流程:
-
XFlow仿真自由表面流(船舶阻力)
-
波浪中运动响应(耐波性)
-
螺旋桨空化噪声
-
FSI分析结构载荷
硬件需求: GPU(LBM自由表面)+ 大显存(精细界面网格)
场景五:建筑风环境与行人舒适性(★★★)
典型任务: 风压分布、行人风舒适性、污染物扩散
工作流程:
-
PowerFLOW导入建筑CAD
-
瞬态风场仿真
-
行人高度风速统计
-
风舒适性指数评估
硬件需求: GPU(LBM)+ 大显存(城市尺度网格)
五、硬件配置推荐:SIMULIA CFD 工作站的"黄金配比"
基于SIMULIA CFD以GPU为核心的计算特性,我们推荐以下配置方案:
方案A:PowerFLOW 气动声学工作站(推荐配置)
适用场景: 汽车空气动力学、风噪、eVTOL、建筑风环境
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | Intel Core i9-14900K / AMD Ryzen 9 7950X | 高主频 + 16核,前后处理与DoE |
| GPU | NVIDIA RTX 6000 Ada 48GB | PowerFLOW LBM核心,48GB显存支持整车模型 |
| 内存 | 128GB DDR5-5600 | 瞬态数据缓冲 + 多物理场 |
| 存储 | 2TB NVMe SSD + 8TB NVMe SSD | 瞬态结果文件巨大 |
| 散热 | CPU双360水冷 + GPU定制水冷 | 持续高负载不降频 |
| 操作系统 | Windows 11 Pro / Linux | PowerFLOW双平台支持 |
预估性能: 整车外流场(5000万网格)瞬态仿真约 2-4小时(物理时间10秒);风噪分析约 4-8小时。
方案B:XFlow 多相流/FSI工作站(高性能配置)
适用场景: 自由表面、船舶水动力、喷涂、流固耦合
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核) | 八通道内存,FSI结构耦合 |
| GPU | NVIDIA RTX 6000 Ada 48GB | XFlow LBM核心 |
| 内存 | 512GB DDR5-4800 ECC | FSI结构场 + 自由表面数据 |
| 存储 | 2TB NVMe SSD + 16TB NVMe SSD | 瞬态结果 + 界面追踪数据 |
| 散热 | 定制分体式水冷(800W+级) | 96核+GPU持续高负载 |
| 操作系统 | Linux CentOS 7.9 / Rocky Linux 8.6 | XFlow大规模并行Linux更稳定 |
预估性能: 船舶阻力(自由表面,3000万网格)约 4-8小时;FSI柔性结构约 8-16小时。
方案C:Fluid Dynamics Engineer 设计探索工作站(DoE专用)
适用场景: 概念设计、参数扫描、优化设计
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9654 (96核×2 = 192核) | 海量核心支持DoE批量并行 |
| GPU | NVIDIA RTX 6000 Ada 48GB × 2 | 双GPU:DoE设计点并行 |
| 内存 | 1TB DDR5-4800 ECC | 多设计点同时驻留 |
| 存储 | 全闪存阵列(NVMe SSD RAID) | 高并发I/O |
| 网络 | 双端口100GbE | 云端HPC扩展 |
| 操作系统 | Linux / Windows Server 2022 | 大内存稳定性 |
预估性能: 100个设计点DoE overnight 完成;支持5-10名工程师同时在线。
方案D:SIMULIA CFD 全栈企业级工作站(旗舰配置)
适用场景: PowerFLOW+XFlow+Fluid Dynamics Engineer全引擎并发
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9654 (96核×2 = 192核) | 全引擎并行 |
| GPU | NVIDIA RTX 6000 Ada 48GB × 4 | 四GPU:多用户/多模型并行 |
| 内存 | 2TB DDR5-4800 ECC | 全栈仿真内存需求叠加 |
| 存储 | 全闪存阵列 + NAS | 高并发I/O |
| 网络 | InfiniBand NDR 400Gb/s | 分布式GPU并行 |
| 操作系统 | Linux / Windows Server 2022 | 大内存稳定性 |
预估性能: 支持10-20名CFD工程师同时工作,全链路仿真 overnight 完成。
六、配置选型核心建议
1. GPU:LBM的"心脏"
表格
| 指标 | 建议 | 原因 |
|---|---|---|
| 显存容量 | ≥32GB(推荐48GB) | LBM网格数据常驻显存 |
| CUDA核心数 | 越多越好 | LBM并行度与核心数正相关 |
| 显存带宽 | 越高越好 | LBM streaming 操作带宽敏感 |
| 专业卡 vs 游戏卡 | 强烈推荐RTX A/Ada系列 | 驱动稳定性、ECC纠错、达索官方认证 |
| 多GPU | 强烈推荐 | PowerFLOW/XFlow支持多GPU,性能近似线性 |
2. CPU:前后处理与DoE的"后盾"
表格
| 场景 | CPU优先级 | 原因 |
|---|---|---|
| PowerFLOW常规 | 高主频 > 核心数 | GPU承担求解,CPU负责前后处理 |
| XFlow FSI | 核心数 > 高主频 | 结构耦合计算 |
| DoE参数扫描 | 核心数 > 高主频 | 设计点完美并行 |
| 多用户并发 | 核心数 > 高主频 | 多会话并行 |
3. 内存:容量是"硬门槛"
表格
| 仿真类型 | 网格/规模 | 内存需求 |
|---|---|---|
| PowerFLOW整车气动 | 5000万网格 | 128-256GB |
| PowerFLOW风噪 | 5000万网格 + 声学 | 256-512GB |
| XFlow自由表面 | 3000万网格 | 128-256GB |
| XFlow FSI | 流体 + 结构 | 256-512GB |
| DoE(100设计点) | 多模型驻留 | 512GB-1TB |
4. 存储:NVMe 是"刚需"
CFD项目文件包含:
-
复杂CAD几何
-
瞬态结果(每个时间步数GB级)
-
气动声学数据(FFT频谱)
-
DoE多设计点结果
大型瞬态项目可达 数TB,NVMe SSD(>3GB/s)是保障效率的基础。
5. 散热:水冷是"标配"
CFD工作站通常需要GPU长时间满载:
-
RTX 6000 Ada × 4 满载约 1200W
-
双路EPYC 9654×2 满载约 600W
-
整机满载超 1800W
定制水冷系统是保障持续性能、避免降频的必要投资。
七、LBM vs 传统NS:为什么SIMULIA CFD选择GPU?
表格
| 对比维度 | LBM(PowerFLOW/XFlow) | 传统NS(Fluent/CFX) |
|---|---|---|
| 网格生成 | 自动笛卡尔,无需简化 | 需手动/半自动生成 |
| 瞬态特性 | 天然瞬态,物理真实 | 稳态为主,瞬态需额外设置 |
| GPU加速 | 天然适合GPU,加速比5-20x | 部分支持GPU,加速有限 |
| 气动声学 | 瞬态压力脉动直接提取 | 需额外声学模型 |
| 真实几何 | 直接导入原始CAD | 通常需简化/清理 |
| 计算规模 | 数千万至数亿网格 | 类似规模,但网格生成耗时 |
关键结论: SIMULIA CFD的LBM技术以GPU为核心,在瞬态气动声学、真实几何处理、自动化工作流方面具有独特优势。对于以汽车风噪、eVTOL噪声、建筑风环境为主要应用场景的用户,GPU配置是首要考虑。
八、结语:CFD仿真的"LBM-GPU时代"已来
SIMULIA 计算流体动力学通过 PowerFLOW + XFlow + Fluid Dynamics Engineer 的整合,基于LBM技术实现了从汽车空气动力学到船舶水动力学、从气动声学到多相流的完整覆盖。LBM的GPU原生加速、自动笛卡尔网格、真实几何处理能力,将CFD仿真效率推向了新的高度。
但这份"全栈"能力的释放,离不开与之匹配的硬件平台:
-
PowerFLOW/XFlow 需要GPU的CUDA核心和显存
-
气动声学 需要GPU持续高负载 + 大存储
-
FSI/多物理场 需要CPU+GPU协同
-
DoE参数扫描 需要多GPU + 多核CPU
对于从事汽车、eVTOL、赛车、船舶、建筑等领域的企业和科研团队而言,投资一套与SIMULIA CFD能力匹配的GPU工作站,不是成本,而是缩短研发周期、降低风洞试验成本、提升产品气动性能的战略必需。
关于UltraLAB
UltraLAB(www.xasun.com)专注于为计算流体力学、气动声学、多相流、流固耦合等场景提供高性能定制工作站。针对SIMULIA PowerFLOW、XFlow、Fluid Dynamics Engineer等达索CFD软件,我们提供从GPU选型、CPU配置、内存容量到散热方案的全流程优化服务,确保每一台设备都能"跑满"LBM求解器性能。
如需获取针对SIMULIA CFD的定制化硬件配置方案,欢迎访问UltraLAB官网或致电咨询。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


