






当 HyperMesh 脚本遇上 AI Agent:本文基于 HyperWorks 2026 Python API 与 MCP(Model Context Protocol)+ Skill 三层架构,解析仿真前处理从"会写脚本"走向"能执行、能追踪、能验证"的核心算法与计算特点,并给出完整软件清单、UltraLAB 图形工作站四级选型方法、应用场景配置与常见问题硬件分析。
目录
- 核心内容:从脚本到服务
- 涉及核心算法
- 计算特点:前处理负载的硬件画像
- 软件清单
- UltraLAB 硬件配置怎么选
- 应用场景与配置推荐
- 常见问题:硬件配置深度分析
- 结语与参考
一、核心内容:HyperMesh 前处理从"脚本"到"服务"
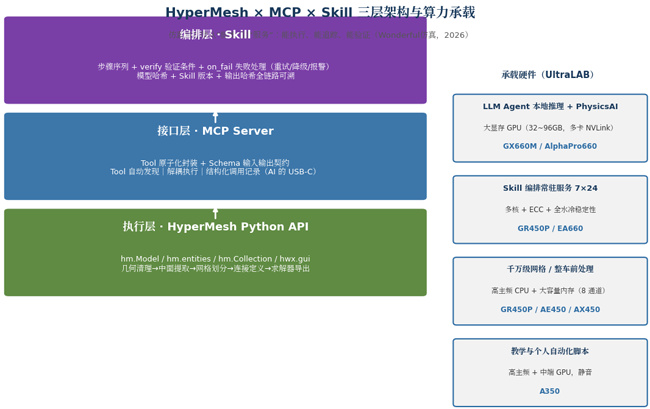
做 CAE 前处理自动化的人几乎都写过 HyperMesh 脚本:TCL 时代几百上千行的 .tcl 文件,到 HyperWorks 2026 把 Python API 做成主力(hm.Model、hm.entities、hm.Collection 等对象化接口)。但脚本与"真正的自动化"之间隔着三座山:能跑但不能被发现、能跑但不能追踪、能跑但不能验证。根源在于:脚本只是"动作",不是"服务"——这正是 MCP(Model Context Protocol)+ Skill 架构要解决的问题。
1.1 三层架构
| 层次 | 职责 | 技术载体 |
|---|---|---|
| 执行层 | 几何清理、网格划分、连接定义、求解器导出等具体操作 | HyperMesh Python API(hm.Model / hm.entities / hwx.gui) |
| 接口层 | 封装为结构化 Tool,定义输入输出 Schema,让 LLM 能发现和理解 | MCP Server(AI 应用的"USB-C 接口") |
| 编排层 | 多 Tool 组合为可复用工作流,带状态追踪、错误处理、质量验证 | Skill 定义(描述 + 工作流 + 验证规则) |
MCP 的价值在于 Tool 自动发现、Schema 契约、解耦执行与可追溯;Skill 层则把工作流变成"步骤序列 + 验证条件 + 失败处理"的闭环——网格质量不达标时自动缩小目标尺寸重试(最多 2 次),而不是把不合格模型扔给求解器。这种闭环反馈是传统脚本做不到的。
图 1:HyperMesh × MCP × Skill 三层架构与 UltraLAB 算力承载映射1.2 CAE + MCP 生态全景(截至 2026 年 9 月)
| 路线 | 代表项目 | 特点 | 成熟度 |
|---|---|---|---|
| 学术开源 | CFD-copilot(arXiv 2512.07917) | LLM + MCP 驱动 OpenFOAM 100+ 后处理工具,BSD-3 许可 | 学术验证,NACA 翼型通过 |
| 建筑能耗 | EPlusOut-MCP(SimBuild 2026) | EnergyPlus 结果 → MCP → 自然语言查询 | 原型,QA/QC 可用 |
| CAD→CAE 全链路 | CAD/CAE Copilot(armpro24-blip) | build123d/OpenCASCADE 几何 + CalculiX FEA,MCP 全流程,MIT 许可 | 可运行,STEP/STL + 线性静力学 |
| 厂商平台 | Ansys SimAI / HyperWorks PhysicsAI | AI 代理模型 + 云端推理,私有 API 非 MCP 标准 | 产品级,生态封闭 |
| 社区封装 | 自建 HyperMesh MCP Server | 基于 HyperWorks 2026 Python API 自行构建 | 需自研,API 基础完备 |
1.3 传统脚本 vs MCP + Skill
| 维度 | 传统脚本 | MCP + Skill |
|---|---|---|
| 发现性 | 藏在本地目录,靠人记住 | Tool 列表自动暴露,Agent 自动发现 |
| 执行追踪 | print 日志,无结构 | 输入/输出/时间戳全结构化记录,可审计回放 |
| 质量验证 | 手动检查或无检查 | Skill 内嵌 verify,自动判通过/失败/重试 |
| 错误处理 | try-except 后退出 | on_fail 策略:重试、降级、报警、人工介入 |
| 版本管理 | 靠人维护版本号 | 模型哈希 + Skill 版本 + 输出哈希全链路可溯 |
| 协作共享 | 邮件发 .tcl 文件 | MCP Server 统一部署,多人/多 Agent 共享 |
二、涉及核心算法
| 核心算法 / 机制 | 技术要点 | 硬件敏感点 |
|---|---|---|
| 对象化 Python API | hm.Model / hm.entities / hm.Collection 对象接口,建模逻辑结构化 | API 调用为进程内串行为主 → 单核高频 |
| Tool 原子化封装 | 一个 Tool 一件事(加载/清理/划分/检查/连接/导出),返回结构化 JSON | 返回摘要+前 N 样本防 LLM 上下文溢出 → 内存与网络 |
| MCP Schema 契约 | 输入输出 Schema 让 LLM 自动填参;docstring 是 LLM 理解工具的关键 | 契约解析开销小,瓶颈在执行层 |
| Skill 闭环编排 | verify 质量门槛(Jacobian>0、翘曲角<阈值、通过率>95%)+ on_fail 重试/降级 + 模型快照 | 重试放大负载 → 算力冗余需求 |
| AI 形状识别 | 自动发现/分组/编辑相似几何 | GPU 加速推理 |
| PhysicsAI 嵌入 | 1000× 加速的实时预测代理模型 | 大显存 GPU(推理)+ 训练需多卡 |
三、计算特点:前处理负载的硬件画像
HyperMesh 自动化工作流的负载由"交互串行 + 批量并行 + AI 推理 + 常驻服务"四类叠加,硬件敏感点各不相同:
图 2:HyperMesh 前处理负载特点 → 硬件需求 → UltraLAB 机型映射| 负载类型 | 典型场景 | 首要瓶颈 | 次要瓶颈 |
|---|---|---|---|
| 交互串行 | 几何清理、中面提取、连接修补 | CPU 单核频率 | 内存容量、SSD 随机读写 |
| 网格划分 | 千万级单元、整车/整机包络 | 内存容量(256~512GB) | 内存通道带宽、L3 缓存 |
| AI 推理 | PhysicsAI 预测、AI 形状识别、本地 LLM Agent | GPU 显存(32GB+) | 多卡 NVLink、推理框架优化 |
| 常驻服务 | MCP Server 内嵌 HyperMesh 7×24 | 满载稳定性(水冷/ECC) | 并发调度、网络共享 |
四、软件清单
| 类别 | 软件 / 组件 | 许可 | 角色 | 硬件侧重 |
|---|---|---|---|---|
| 前处理平台 | Altair HyperWorks 2026 / HyperMesh | 商业 | 执行层:几何/网格/连接/deck 导出 | 高主频 CPU + 大内存 |
| 接口层 | MCP Server(自建 hypermesh-mcp) | 开源标准 | Tool 封装 + Schema 契约 | 常驻进程稳定性 |
| 编排层 | Skill 定义(YAML 式工作流) | 自研 | verify / on_fail / 版本追踪 | 重试放大算力冗余 |
| AI 客户端 | Claude / Cursor / VS Code Copilot | 商业 | LLM 推理与工具调用编排 | 云端或本地大显存 GPU |
| 求解器 | OptiStruct / LS-DYNA / Radioss | 商业 | deck 导出目标(Profile 锁定) | 依求解类型另配 |
| 开源求解器 | CalculiX FEA(经 CAD/CAE Copilot) | GPL | 线性静力学验证链路 | 中小模型即可 |
| AI 能力 | HyperWorks PhysicsAI / AI 形状识别 | 商业 | 1000× 加速代理预测、相似几何分组 | GPU 显存 ≥16GB |
| 生态参考 | CFD-copilot(OpenFOAM)/ EPlusOut-MCP(EnergyPlus) | BSD-3 | MCP 驱动仿真工具范式验证 | — |
| 运行时 | Python 3.x + mcp SDK | 开源 | API 与 Server 载体 | — |
五、UltraLAB 硬件配置怎么选
5.1 产品矩阵与负载匹配
| 系列 | 核心特征 | 匹配负载 | 价格区间 |
|---|---|---|---|
| A350 超频图形工作站 | Intel Ultra 高主频、静音紧凑 | 个人脚本自动化、教学、轻量前处理 | ¥25,500 ~ 52,000 |
| GR450P 极致超频 | AMD TR 32 核 5.0GHz、全水冷 | 几何清理 + 网格划分主力、MCP Server 常驻 | ¥92,000 ~ 198,000 |
| AE450 / AX450 水冷 | 霄龙 512MB L3 / Xeon 128 核 | 千万级网格、大模型批量前处理 | ¥59,990 ~ 275,000 |
| EA660 双路全水冷 | 双路霄龙 256 核、512GB~768GB | 团队共享算力池、Skill 批量并发 | ¥89,990 ~ 420,000 |
| GX660M / AlphaPro660 | 4×A100 / 4×RTX Pro 6000 NVLink | 本地 LLM Agent、PhysicsAI 训练推理 | ¥142,000 ~ 1,150,000 / ¥330,000 ~ 999,900 |
5.2 四级配置推荐
| 等级 | CPU | GPU | 内存 / 存储 | 参考机型与报价 |
|---|---|---|---|---|
| 入门版 | Intel Ultra 9-285K(8P 核 5.6GHz) | RTX 5060 8GB | 64~96GB DDR5 / 4TB NVMe | A35015064-MBX(约 ¥36,000) |
| 标准版 | AMD TR-7970X(32 核 5.0GHz) | RTX 5080 16GB | 128GB DDR5 / 4TB NVMe,全水冷 | GR450P150128-MCX(约 ¥128,000) |
| 专业版 | 霄龙 9755(128 核 4.1GHz,512MB L3) | RTX 5090D 32GB | 256GB ECC / 4TB NVMe Gen5 | AE450141256-MCX(约 ¥165,000) |
| 旗舰版 | 2×霄龙 9755(256 核) | 4×A100 80GB / 4×RTX Pro 6000 96GB | 512GB~1TB ECC / 8TB NVMe + 20TB SATA | EA660235512-MCX(约 ¥252,000)/ GX660M235640-MD4A(约 ¥620,000) |
5.3 组件选型原则
| 组件 | 选型原则 | 推荐基准 |
|---|---|---|
| CPU | 交互与 API 调用吃单核频率;批量 Skill 与多 Agent 吃核心数 | 主频 ≥5.0GHz;并发高选 32 核起步 |
| GPU | PhysicsAI/形状识别/本地 LLM 共享一卡,显存是第一瓶颈 | ≥16GB 起步;LLM 私有化 32GB+,训练多卡 NVLink |
| 内存 | 容量 ≈ 模型规模的 3~5 倍;必须 ECC(自动化无人值守) | 个人 128GB / 团队 256~512GB |
| 存储 | 模型与结果文件大、版本快照频繁,NVMe 必备 | NVMe Gen4/Gen5 ≥2TB + SATA 归档 |
| 散热/电源 | MCP Server 常驻满载,降频=自动化排队雪崩 | 全水冷 + 冗余电源(UltraLAB 全系) |
六、应用场景与配置推荐
场景一:个人工程师 / 高校:脚本自动化起步
| 项目 | 推荐 | 理由 |
|---|---|---|
| 机型 | A35015064-MBX(约 ¥36,000) | 高主频保证交互流畅,静音适合办公室/实验室 |
| CPU / GPU / 内存 | Ultra 9-285K / RTX 5060 / 64GB | 覆盖第一个 MCP Tool 开发与轻量 Skill |
场景二:汽车/装备企业:整车碰撞模型前处理自动化
| 项目 | 推荐 | 理由 |
|---|---|---|
| 机型 | GR450P150128-MCX(约 ¥128,000) | 32 核 5.0GHz 平衡交互与划分,全水冷 7×24 |
| CPU / GPU / 内存 | TR-7970X / RTX 5080 16GB / 128GB | 千万级网格内存余量,PhysicsAI 可跑 |
| 升级路径 | 内存 256GB;GPU 升 RTX 5090D 32GB | 支撑更大包络与本地 LLM Agent |
场景三:航空航天/船舶:大模型 + AI 代理预测
| 项目 | 推荐 | 理由 |
|---|---|---|
| 机型 | AE450141256-MCX(约 ¥165,000) | 128 核 + 512MB L3 加速网格与连接搜索 |
| CPU / GPU / 内存 | 霄龙 9755 / RTX 5090D 32GB / 256GB ECC | 大模型 + AI 形状识别并发 |
场景四:集团仿真中心:MCP Server 共享 + 本地 LLM 私有化
| 项目 | 推荐 | 理由 |
|---|---|---|
| 机型 | GX660M235640-MD4A(约 ¥620,000) | 4×A100 80GB NVLink,多 Agent 并发推理 |
| 备选 | EA660235512-MCX(约 ¥252,000)+ AlphaPro660 | 纯前处理算力池 + 可视化/推理分离 |
| 网络/调度 | 40G 以太网 + 作业调度 + 模型库快照 | 多人共享 MCP Server、全链路版本追踪 |
七、常见问题:硬件配置深度分析
Q1:几何清理与中面提取卡顿,该升级什么?交互串行负载,首升 CPU 主频(≥5.0GHz,如 TR-7970X / Ultra 9-285K),内存 ≥128GB 保整车模型驻留,工作目录迁 NVMe Gen4/Gen5。高主频平台交互提速可达 30%~50%。
Q2:千万级网格划分内存溢出怎么办?内存需求与单元数正相关:千万级单元建议 256~512GB ECC,优先 8 通道(TR PRO/EPYC)补带宽;超大规模切分组件分块划分,或用 HyperWorks 批量化网格管理错峰。
Q3:本地 LLM Agent 驱动 MCP Server,GPU 怎么选?私有化推理显存第一:单机 RTX 5090D 32GB 起步(70B 级建议量化或双卡);团队多 Agent 并发选 GX660M(4×A100 80GB / 4×RTX Pro 6000 96GB,NVLink);过渡方案 RTX 5080 16GB + 4bit 量化。
Q4:MCP Server 需内嵌 HyperMesh 常驻,稳定性怎么保障?MCP Server 必须内嵌启动或经 HM-Client 代理常驻,是 7×24 服务:需 ECC 内存、全水冷、冗余电源、ISV 级驱动。组装机高负载降频蓝屏会让无人值守自动化任务批量失败——代价远高于硬件差价。
Q5:PhysicsAI / AI 形状识别推理慢如何加速?确保 GPU 显存 ≥16GB、Studio/专业驱动;批量几何分组开启 GPU 加速;实时预测场景建议 RTX Pro 5000 48GB 以上专业卡;训练代理模型需多卡平台(GX660M)。
Q6:多人共享 MCP Server、Skill 批量排队久如何破局?单机选多核高主频(GR450P 32 核 / AX450 128 核)+ 作业调度;团队以 EA660(双路 256 核)/ GX660M 建共享算力池,40G 网络共享模型库;配合 Skill 快照与排队机制,避免重试风暴(设最大重试次数 + 每次自动调参)。
Q7:八大工程坑点中哪些与硬件直接相关?| 坑点 | 硬件关联与对策 |
|---|---|
| API 依赖运行时,Server 须内嵌 | 常驻稳定性 → 水冷 + ECC + 冗余电源 |
| 大模型返回过长撑爆 LLM 上下文 | 返回摘要 + 样本截断;网络与内存余量 |
| Skill 重试风暴 | 算力冗余 ≥30%,水冷防满载降频 |
| Profile 切换不生效 | 与硬件无关,锁定 Profile 流程管控 |
八、结语与参考
MCP 给了统一的接口标准,Skill 给了编排与质量保障框架,HyperWorks 2026 的 Python API 给了底层执行能力——三者组合,仿真前处理自动化从"某个工程师的桌面脚本"变成"团队可信赖的基础设施"。而算力是这套基础设施的底座:交互要快、划分要稳、推理要猛、常驻要冷。先分清负载画像,再按四级配置对号入座,是让每一条 Skill 工作流都跑得动、追得回、验得了的前提。
参考信息
- 《Altair HyperMesh + MCP + Skill 实践:仿真前处理从"会写脚本"走向"能执行、能追踪、能验证"》(Wonderful仿真,微信公众号)
- HyperWorks 2026 Release Notes / HyperMesh Python API 文档(hm.Model、hm.entities、hm.Collection、hwx.gui)
- MCP 官方文档;CFD-copilot(arXiv 2512.07917);CAD/CAE Copilot(GitHub: armpro24-blip);EPlusOut-MCP(SimBuild 2026)
- 《UltraLAB 图形工作站基准配置表 2026v3》
免责声明:本文机型与价格基于 UltraLAB 2026v3 基准配置表整理,实际以官方最新手册为准;Altair/开源软件信息以官方文档为准。性能描述为工程经验值,以实测为准。本文不构成任何采购投资建议。


