






——从微米级凸点间距缩放到百瓦级热密度管理,先进封装仿真需要怎样的硬件底座?
当台积电的3nm工艺节点逼近物理极限,当单芯片晶体管数量千亿级却受限于"内存墙"与"功耗墙",半导体产业正在经历一场从"CMOS微缩"到"系统级异构集成"的范式转移。
2025年ISSCC顶会上,欧洲微电子研究中心(IMEC)发布的40页后摩尔时代路线图,不仅勾勒出未来5-10年先进封装的技术全景,更隐含了一个关键命题:支撑2.5D Chiplet与3D-SoC设计的仿真算力,需要怎样的硬件革命?
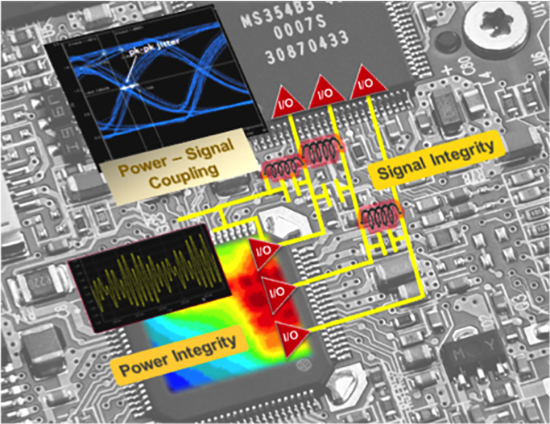
一、功能全景:从水平互连到垂直堆叠的「三维突围」
IMEC将异构集成明确划分为两大技术谱系,每一种都对应着独特的仿真功能需求:
1. 2.5D Chiplet:水平维度的「模块化拼图」
核心功能特征:
-
标准化互连接口:支持UCIe(通用芯粒互连)、AIB、BOW等开放标准,实现"即插即用"的芯粒生态
-
亚微米级互连Pitch:通道间距从当前的4μm向2μm、甚至1μm演进,以实现2Tbps/mm的带宽密度目标
-
多物理介质互连:硅中介层(Si Interposer)、硅桥(Silicon Bridge)、高密度RDL(重布线层)扇出
仿真功能需求:
-
信号完整性(SI)分析:超短距离SerDes(<1mm)的功耗模型,微凸点阵列的寄生参数提取
-
电源完整性(PI)分析:芯间互连的压降与地弹噪声,特别是电源/地信号占用1/3凸点资源的复杂场景
-
热-机械协同仿真:多芯片异构材料的热膨胀系数(CTE)失配导致的翘曲与应力
2. 3D-SoC:垂直维度的「立体重构」
核心功能特征:
-
存储-逻辑3D堆叠:HBM从4层向16层演进,逻辑芯片与L3 Cache的Die-to-Wafer(D2W)键合
-
背面供电网络(BSPDN):通过晶圆背面构建电源网络,解决正面布线拥堵,降低IR Drop达30%+
-
混合键合(Hybrid Bonding):铜-铜直接键合实现<10μm间距的垂直互连,取代传统微凸点
-
纳米TSV(nTSV):直径<5μm的高密度硅通孔,连接上下层有源电路
仿真功能需求:
-
电-热耦合分析:3D堆叠导致热密度达100-500 W/cm²(传统单芯片约50-100 W/cm²),需实时电热协同仿真
-
TSV应力分析:热循环中的TSV挤压(Keep-out Zone)效应对周围晶体管电性能的影响
-
电磁场全波仿真:高频信号(>100GHz)在3D互连中的串扰与损耗
-
多尺度网格剖分:从纳米级键合界面到厘米级封装基板的全局建模
二、计算特点:异构集成仿真的「四大算力挑战」
先进封装将设计维度从2D推向3D,仿真计算的复杂度呈指数级增长:
1. 多物理场强耦合:非线性方程组的「维度灾难」
3D-SoC需同时求解:
-
电磁场(高频信号完整性)
-
温度场(焦耳热+芯片自热,瞬态与稳态)
-
机械应力场(热膨胀失配、TSV挤压应力)
-
流场(微流体散热通道)
这些物理场通过材料属性(如电导率随温度变化)与几何变形强耦合,形成大规模非线性偏微分方程组。典型的3D封装电热耦合仿真,网格节点数可达千万级,矩阵自由度(DOF)达亿级。
2. 多尺度建模:从纳米到厘米的「跨度难题」
-
微观尺度:混合键合的铜盘表面粗糙度(<1nm)、TSV氧化层厚度(几十nm)
-
介观尺度:微凸点阵列(Pitch 40-100μm)、RDL线宽/间距(2-5μm)
-
宏观尺度:封装基板(数厘米)、整机系统(热边界条件)
这种10⁶量级的尺度跨度,要求自适应网格细化(Adaptive Mesh Refinement)与多尺度算法(如异构多尺度方法HMM),对内存容量与CPU缓存提出极高要求。
3. 随机性与良率分析:蒙特卡洛的「算力黑洞」
先进封装的工艺波动(键合对准误差、TSV深度偏差、RDL线宽变化)导致电-热-力性能的统计性分布。为评估良率,需进行数千至上万次的蒙特卡洛仿真,每次仿真都需重新求解大规模稀疏矩阵,算力需求是单一仿真的3-4个数量级。
4. Chiplet互连的「组合爆炸」
当系统包含数十个芯粒(Chiplets),每个芯粒有多种工艺角(PVT),互连拓扑存在海量配置可能。AI驱动的布局优化(如强化学习自动寻优)需在高维参数空间中快速评估PPA(性能-功耗-面积),要求仿真工具具备秒级响应的代理模型(Surrogate Model)能力。
三、硬件配置:支撑「三维堆叠」仿真的算力底座
针对上述计算特征,先进封装EDA仿真需构建分层异构的算力架构:
1. 核心求解层:大规模稀疏矩阵的「重武器」
| 硬件组件 | 推荐配置 | 技术 rationale |
|---|---|---|
| CPU | 双路 AMD EPYC 9755 (128核/256线程) 或 Intel Xeon Platinum 8592+ | 多物理场耦合需高内存带宽;稀疏直接求解器(MUMPS、PARDISO)可扩展至64核+ |
| 内存 | 512GB - 2TB DDR5-5600 ECC (8-16通道) | 千万级网格的3D电热耦合仿真,单精度矩阵占用>200GB,双精度>400GB |
| 存储 | 4TB NVMe SSD (PCIe 4.0/5.0) × 4 (RAID 0) | 蒙特卡洛仿真产生海量中间文件,IOPS需>500k,带宽>10GB/s |
2. 加速计算层:AI代理与多物理场的「涡轮增压」
-
GPU加速卡:NVIDIA H100 80GB × 2-4
-
用途一:AI代理模型训练与推理(替代传统FEM求解,实现72倍加速如芯和半导体所示)
-
用途二:CUDA加速的稀疏矩阵迭代求解器(如AmgX)
-
用途三:3D可视化与结果后处理(千万级网格的实时渲染)
-
-
高速互联:NVLink 4.0 (900 GB/s) + InfiniBand HDR (200 Gbps)
-
多GPU间模型参数同步,分布式多物理场并行求解
-
3. 专用仿真工作站配置方案
方案A:2.5D Chiplet SI/PI仿真工作站
plain
CPU: Intel Xeon 678X (48核, 4.9GHz睿频)
内存: 256GB DDR5-5600 ECC (8通道)
存储: 2TB NVMe SSD (系统) + 8TB NVMe SSD (数据)
显卡: NVIDIA RTX Pro5000 48GB
网络: 25GbE (多机协同)
适用场景:高速SerDes信号完整性、电源完整性分析、互连寄生参数提取
方案B:3D-SoC多物理场仿真服务器
plain
CPU: 双路 AMD EPYC 9655 (96核×2, 4.1GHz)
内存: 1TB DDR5-5600 ECC (16通道, 内存带宽>800GB/s)
存储: 全闪存NVMe阵列 50TB (支持Lustre并行文件系统)
加速: NVIDIA A100 80GB × 4 (NVLink全互联)
网络: InfiniBand NDR (400Gbps)
适用场景:3D堆叠电热耦合、TSV应力分析、BSPDN压降仿真、蒙特卡洛良率分析
4. 关键配置要点
内存带宽优先于核心数:多物理场有限元求解(FEM)是内存带宽密集型(Memory-bound),16通道DDR5-4800提供>800GB/s带宽,比单纯堆CPU核心更能提升求解效率。
混合精度计算:电热耦合可使用单精度(FP32)加速,但机械应力分析需双精度(FP64)。NVIDIA A100的FP64性能(9.7 TFLOPS)是重要指标。
分层存储架构:热数据(当前仿真的网格与矩阵)驻留NVMe,温数据(历史结果)存放SSD阵列,冷数据(归档)使用HDD或对象存储,通过自动化数据分层降低存储成本。
结语:封装即系统,算力即竞争力
IMEC的路线图清晰表明:未来5年,半导体竞争的主战场将从"制程节点"转向"封装集成"。当2μm的互连间距与500W/cm²的热密度成为常态,当3D堆叠让芯片设计从"平面设计"变为"立体建筑",支撑这一切的仿真算力底座必须同步进化。
从水平互连的SI/PI仿真到垂直堆叠的多物理场耦合,从蒙特卡洛良率分析到AI驱动的布局优化,先进封装EDA正以前所未有的强度吞噬算力。在这场"后摩尔时代"的突围战中,拥有适配异构集成仿真需求的算力基础设施,将成为芯片设计企业的核心护城河。
配置咨询:西安坤隆计算机科技有限公司 | UltraLAB 定制图形工作站
技术热线:400-705-6800
微信号:xasun001
本文基于IMEC 2025 ISSCC报告《From monolithic 2D to heterogeneous integration: an advanced packaging technologies landscape》整理


