






Sentaurus TCAD仿真计算及大模型本地部署加速:SiC功率器件UltraLAB硬件配置选型指南
摘要:本文面向 SiC 2D功率器件(单元胞/终端/10元胞并联) 的 Synopsys Sentaurus TCAD 仿真工程师,系统分析计算规模与硬件需求的映射关系,提供 UltraLAB 分级硬件配置推荐(从入门到旗舰),并给出 本地大模型(LLM)部署的完整软件清单 与系统架构建议。涵盖软件模块、功能场景、硬件选型逻辑及常见问题分析,帮助用户构建 "TCAD 高精度物理仿真 + AI 智能体辅助" 的异构计算工作流。
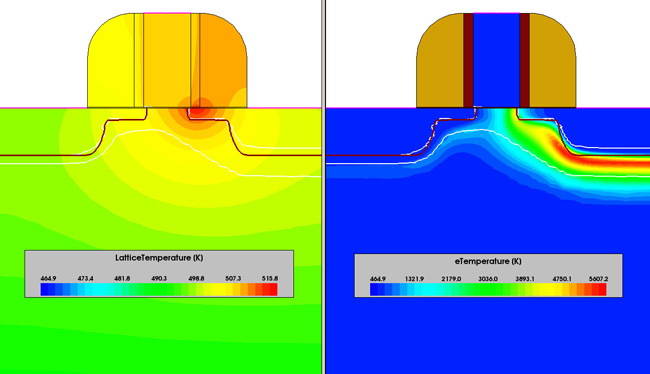
一、软件模块:Sentaurus TCAD 核心求解与大模型加速双栈
1.1 Sentaurus TCAD 核心模块
| 模块名称 | 功能说明 | 计算特征 | 硬件敏感点 |
|---|---|---|---|
| SProcess | 工艺仿真:离子注入、扩散、氧化、刻蚀、外延 | 有限元/有限差分求解,多物理场耦合 | 高主频 CPU + 大内存,多核有加速但主频优先 |
| SDE | 结构编辑器:器件几何建模与掺杂定义 | 参数化脚本驱动,网格预处理 | 单核主频敏感 |
| SNMesh | 网格划分:自适应加密、 Delaunay 剖分 | 单线程为主,网格优化阶段内存峰值高 | CPU 主频极度敏感,核心数收益低 |
| SDevice | 器件电性求解:Poisson/连续性方程/量子输运 | 稀疏矩阵迭代求解,支持多核并行 | 多核并行有效,内存带宽敏感 |
| SVisual | 后处理:3D 可视化、截面分析、数据提取 | 图形渲染 + 大数据加载 | 专业图显 + 大内存 |
| Sentaurus Workbench | 流程自动化:参数化扫描、DOE、优化 | 多作业调度管理 | 多核并行跑批量任务 |
1.2 AI 大模型加速模块
| 模块/工具 | 功能说明 | 与 TCAD 的协同方式 |
|---|---|---|
| 本地 LLM 智能助手 | 部署 Llama/Qwen/DeepSeek 等大模型,辅助 K 文件编写、参数解读、故障排查 | 通过 RAG 接入 Sentaurus Keyword Manual 与材料数据库,自然语言交互 |
| ML Surrogate Model | 基于 TCAD 仿真数据训练代理模型(Random Forest/XGBoost/神经网络),替代部分高成本仿真 | 用少量高保真仿真数据训练,毫秒级预测新工况,加速 10⁴–10⁵ 倍 |
| Sentaurus ML Calibration Accelerator | Synopsys 官方 GPU 加速模块,用于材料参数反演与代理模型训练 | 直接调用 NVIDIA GPU 加速 PyTorch 训练 |
| AI 前处理 | 基于深度学习自动生成高质量网格、参数化结构变异 | 减少人工网格划分时间 50% 以上 |
| AI 后处理 | 大模型自动提取关键指标(击穿电压、导通电阻、电场峰值)、生成分析报告 | 自动化替代人工后处理 |
技术洞察:SiC 功率器件的 TCAD 仿真正从 "纯物理求解" 向 "物理仿真 + AI 代理模型" 融合演进。本地部署大模型可实现数据不出域、知识库私有化,同时通过代理模型将设计迭代周期从数周缩短至数小时。
二、应用场景:SiC 功率器件的三大仿真工况
2.1 场景一:单元胞(Unit Cell)静态特性仿真
仿真目标:提取 SiC MOSFET/SBD 的阈值电压、导通电阻、转移特性、输出特性。
计算规模:
- 网格量:1–3 万(2D 三角形/四边形)
- 物理模型:经典漂移-扩散(DD)+ 高迁移率模型
- 内存峰值:16–32 GB
- 求解时间:单偏置点 5–30 分钟
AI 加速点:
-
用本地 LLM 辅助编写
Physics段落(如Mobility (DopingDep HighFieldSat Enormal)参数设置); - 用代理模型预测不同栅氧厚度/沟道掺杂下的阈值电压漂移。
2.2 场景二:结终端(JTE/场板/场环)耐压仿真
仿真目标:优化终端结构,实现目标击穿电压(如 1200V/1700V/3300V)下的低泄漏电流。
计算规模:
- 网格量:5–10 万(终端区高电场加密,网格密度是单元胞的 3–5 倍)
- 物理模型:DD + 碰撞电离(Okuto-Crowell/Grant)+ 电热耦合
- 内存峰值:48–85 GB
- 求解时间:单偏置点 30 分钟–2 小时
AI 加速点:
- 用代理模型快速扫描场板长度/场环间距/ JTE 剂量等关键参数,筛选最优组合;
-
用 LLM 解读
ImpactIonization模型参数对击穿曲线的影响。
2.3 场景三:10 元胞并联 + 瞬态开关仿真(DPT/短路/雪崩)
仿真目标:评估多胞并联的电流均匀性、开关损耗、短路耐受能力、UIS 雪崩能量。
计算规模:
- 网格量:10–20 万(元胞宽度扩大 10 倍,高电场区同步增加)
- 物理模型:DD + 电热耦合(Thermodynamic/Giga3D)+ 瞬态扫描
- 内存峰值:128–220 GB(瞬态每步累积历史解,内存随时间步线性爬坡)
- 求解时间:双脉冲测试(DPT)可能需要 6–24 小时
AI 加速点:
- 用代理模型预测不同栅极电阻/驱动电压下的开关损耗与 EMI 特性;
- 用 LLM 自动提取 DPT 波形中的关键参数(开通延迟、关断拖尾、反向恢复电荷)。
计算规模换算公式:
- 2D SiC 内存(GB) ≈ 网格量(万) × 0.5–0.8 GB/万网格 × 1.7×(电热耦合) × 1.3–2.0×(瞬态)
- SiC 临界电场 (~3 MV/cm) 要求耗尽区网格加密 0.01–0.05 μm,同样尺寸下网格量是硅器件的 2–3 倍。
三、UltraLAB 硬件配置推荐:分级选型
3.1 选型逻辑:Sentaurus TCAD 的硬件瓶颈分析
| 组件 | 瓶颈原因 | 选型优先级 |
|---|---|---|
| CPU 主频 | SNMesh 网格划分、SProcess 工艺仿真为单线程/少线程,主频决定等待时间 | ⭐⭐⭐⭐⭐ 最高优先级 |
| 内存容量 | SDevice 构建稀疏矩阵、瞬态累积历史解,3D/大网格场景内存消耗指数增长 | ⭐⭐⭐⭐⭐ 最高优先级 |
| CPU 核心数 | SDevice 支持多核并行,但超过 64 核收益递减;多作业并行扫描需要多核 | ⭐⭐⭐⭐☆ |
| 内存带宽 | 稀疏矩阵求解对内存带宽敏感,通道数越多扩展效率越高 | ⭐⭐⭐⭐☆ |
| 存储 I/O | 瞬态仿真产生海量 TDR/DF-ISE 文件,高速 NVMe 缩短 I/O 等待 | ⭐⭐⭐☆☆ |
| GPU | 传统 TCAD 求解器不支持 GPU;仅 AI 大模型/ML Calibration 需要 GPU | ⭐⭐⭐☆☆(无 AI 需求可降级) |
3.2 分级配置推荐
档位 A:入门型 —— 单元胞 + 终端稳态仿真(内存 96–128 GB)
| 推荐型号 | 核心配置 | 报价 | 适配分析 |
|---|---|---|---|
| A350 153128-MCT | Intel Ultra9 265K (20核, 8P核 5.3GHz) / 水冷 / 128GB DDR5 / RTX5090v2 24GB / 4TB NVMe | ¥61,000 | 5.3GHz 超高单核频率,SNMesh 网格划分极快;128GB 覆盖终端仿真;RTX5090 兼顾显示与轻量 AI。 |
| GR450P 150128-MCX | AMD 锐龙 TRpro 7975WX (32核 5.0GHz) / 128GB DDR5 / RTX 5080 / 4TB NVMe | ¥105,000 | 32核 + 5.0GHz,SProcess/SNMesh 单线程与 SDevice 多核并行完美平衡;128GB 内存匹配终端稳态场景。 |
适用用户:以单元胞和终端稳态仿真为主,偶尔做 10 元胞并联但不涉及瞬态,预算有限。
档位 B:专业型 —— 10 元胞并联 + 瞬态 + 本地大模型(内存 192–256 GB)
| 推荐型号 | 核心配置 | 报价 | 适配分析 |
|---|---|---|---|
| GR450P 148192-MCC | AMD 锐龙 TR 7980X (64核 4.8GHz) / 192GB DDR5 / RTX 4000ada / 4TB NVMe / 20TB SATA | ¥165,000 | 64核 SDevice 并行效率高;192GB 内存覆盖 10 元胞并联稳态,瞬态需分时调度;RTX 4000ada 满足显示与轻量 AI。 |
| ★ 推荐:GR450P 148256-MCB | AMD 锐龙 TR 7980X (64核 4.8GHz) / 256GB DDR5 / RTX A2000 / 4TB NVMe / 20TB SATA | 约 ¥175,000–185,000 | 黄金配置。256GB 内存彻底覆盖 10 元胞并联 + 瞬态峰值(220GB 留有 15% 余量);64核 + 4.8GHz 主频在 SNMesh 单线程与 SDevice 多核间完美平衡;可同时运行本地 70B 级大模型(vLLM 主机内存占用 20–40GB)而不爆内存。 |
| GR450P 145384-MDA | AMD 锐龙 TRpro 7995WX (96核 4.5GHz) / 384GB DDR5 / A100 40GB+水冷 / 4TB NVMe / 20TB SATA | ¥355,000 | 旗舰级。96核 + 8通道内存 + 384GB 容量,为 3D 扩展预留空间;A100 40GB 支持本地 70B 大模型 + ML Calibration GPU 加速。 |
适用用户:主力做 10 元胞并联 + 瞬态开关仿真,同时需要本地大模型智能助手辅助工作流。
档位 C:旗舰型 —— 晶圆级 DTCO / 3D 扩展 / 多物理场耦合(内存 512 GB+)
| 推荐型号 | 核心配置 | 报价 | 适配分析 |
|---|---|---|---|
| AlphaPro660 241640-MDD | 2× AMD 霄龙 9655 (192核 4.1GHz) / 640GB DDR5 / RTX Pro 5000 / 8TB NVMe | ¥450,000 | 192核 + 640GB 内存 + 24 通道带宽,应对晶圆级 DTCO、超大规模 3D 有限元求解;双路架构支持多作业并行。 |
| AlphaPro660 241768-MDF | 2× AMD 霄龙 9655 (192核 4.1GHz) / 768GB DDR5 / RTX Pro 6000 / 8TB NVMe | ¥515,000 | 768GB 内存,专为量子约束载流子输运、FinFET/CFET 百万元级网格、蒙特卡洛仿真设计。 |
适用用户:从 2D 向 3D 扩展,或需要同时跑数十个 TCAD 作业 + 多 GPU 大模型推理的团队。
3.3 配置决策树
你的主要工作流
    │
    ├── 90% 单元胞 + 终端,偶尔 10 元胞稳态
    │       └── 预算有限 ──→ A350 153128-MCT (¥61,000) 或 GR450P 150128-MCX (¥105,000)
    │
    ├── 经常做 10 元胞并联 + 瞬态(DPT/短路/雪崩)
    │       │
    │       ├── 不需要本地大模型 ──→ GR450P 148192-MCC (¥165,000)
    │       │
    │       └── 需要本地大模型(LLM助手/代理模型)
    │               ├── 预算敏感 ──→ GR450P 148192-MCC + 分时调度策略
    │               └── 一步到位 ──→ ★ GR450P 148256-MCB (约¥180,000)
    │
    └── 未来做 3D / 晶圆级 / 多物理场耦合
            └── GR450P 145384-MDA (¥355,000) 或 AlphaPro660 系列
四、本地大模型部署:完整软件清单
4.1 操作系统与驱动层
| 软件 | 版本建议 | 用途说明 |
|---|---|---|
| Ubuntu Server LTS | 22.04 / 24.04 | 主操作系统;Sentaurus TCAD 官方仅支持 Linux;对 NVIDIA 驱动与容器生态支持最佳 |
| NVIDIA Driver | ≥ 550.x | GPU 显卡驱动 |
| CUDA Toolkit | 12.4+ | GPU 并行计算框架 |
| cuDNN | 9.x | 深度神经网络加速库 |
| NCCL | 2.20+ | 多 GPU 通信库 |
4.2 Sentaurus TCAD 仿真层
| 软件 | 版本建议 | 用途说明 |
|---|---|---|
| Sentaurus TCAD | 2024.03+ | 核心仿真平台:SProcess / SDE / SNMesh / SDevice / SVisual |
| Sentaurus Workbench | 随 TCAD 套件 | 流程自动化与参数化扫描 |
| Sentaurus ML Calibration Accelerator | 可选模块 | GPU 加速代理模型训练 |
| MATLAB | R2024a+ | 后处理脚本、数据拟合、与 TCAD 数据交互 |
| Python | 3.10 / 3.11 | TCAD 脚本扩展、PyTorch 数据预处理 |
4.3 AI 大模型推理服务层
| 软件 | 版本建议 | 用途说明 |
|---|---|---|
| vLLM | 0.5.0+ | 推荐。PagedAttention 最大化 GPU 吞吐量,支持 OpenAI 兼容 API |
| Ollama | 0.3.0+ | 一键本地部署 Llama/Qwen/DeepSeek,快速验证 |
| llama.cpp | b3000+ | CPU/GPU 混合推理,低显存 fallback |
| Text Generation Inference (TGI) | 2.0+ | HuggingFace 官方推理服务,生产级部署 |
| sglang | 0.2+ | RadixAttention 优化多轮对话 |
4.4 AI 框架与训练层
| 软件 | 版本建议 | 用途说明 |
|---|---|---|
| PyTorch | 2.3+ (CUDA 12) | 代理模型(PINN、GNN)训练 |
| TensorFlow | 2.16+ | 备用框架 |
| JAX / Flax | 0.4+ | 高性能科学计算 |
| Scikit-learn | 1.4+ | Random Forest、XGBoost 代理模型 |
| XGBoost | 2.0+ | 梯度提升,TCAD 参数反演 |
| Optuna | 3.6+ | 超参数优化 |
4.5 RAG 知识库与应用层
| 软件 | 版本建议 | 用途说明 |
|---|---|---|
| LangChain | 0.2+ | LLM 应用编排,构建 TCAD 智能助手工作流 |
| LlamaIndex | 0.10+ | RAG 知识库索引与检索 |
| ChromaDB | 0.5+ | 向量数据库 |
| FAISS | 1.8+ | 高效向量检索 |
| Sentence-Transformers | 2.7+ | 文本 Embedding(BGE-large、E5-mistral) |
| Gradio / Streamlit | 4.x / 1.3+ | Web UI 快速构建 |
4.6 开发与运维层
| 软件 | 版本建议 | 用途说明 |
|---|---|---|
| Docker / Podman | 24.x+ | 容器化部署 |
| NVIDIA Container Toolkit | 最新版 | Docker 内直接调用 GPU |
| JupyterLab | 4.x | 交互式开发 |
| VS Code + SSH Remote | 最新版 | 远程开发 |
| Git / Git LFS | 最新版 | 版本控制 |
| MLflow | 2.x | 模型实验追踪 |
| Prometheus + Grafana | 最新版 | 监控 GPU/CPU/内存资源 |
五、推荐部署的本地大模型(按 GPU 显存分级)
| GPU 显存 | 可部署模型 | 参数量 | 量化 | 显存占用 | 适用场景 |
|---|---|---|---|---|---|
| RTX 4000ada 20GB | Llama 3.1 | 8B | FP16 | ~16 GB | 轻量助手、K 文件语法问答 |
| RTX 4000ada 20GB | Qwen 2.5 | 7B | FP16 | ~14 GB | 中文技术文档问答 |
| A100 40GB | Llama 3.1 | 70B | INT4 (AWQ/GPTQ) | ~40 GB | 主力推荐。复杂推理、长文档分析、代码生成 |
| A100 40GB | Qwen 2.5 | 72B | INT4 | ~40 GB | 中文语境下代码理解和生成能力极强 |
| A100 40GB | DeepSeek-Coder-V2 | 16B | FP16 | ~32 GB | 代码专用模型,K 文件编写辅助 |
| A100 80GB | Llama 3.1 | 70B | FP16 | ~80 GB | 无精度损失推理,适合科研级应用 |
| A100 80GB | Mixtral 8×22B | 176B | INT4 | ~80 GB | MoE 架构,多任务推理 |
部署建议:
- 192GB 内存工作站:同时运行 1 个 70B 级模型(主机内存占用 ~20GB)+ TCAD 单元胞/终端仿真无压力;10 元胞瞬态时需暂停 LLM 服务。
- 256GB 内存工作站:可同时运行 1 个 70B 级模型 + 10 元胞瞬态仿真,留有 15% 安全余量。
- 384GB+ 内存工作站:可同时运行多个模型 + 大规模 TCAD 作业,实现真正的异构并发。
六、系统部署架构示意
┌────────────────────────────────────────────────────────────┐
│              UltraLAB 工作站(TCAD + AI 异构计算平台)                                                                 │
│                                                                                                                        │
│  ┌─────────────────────────┐    ┌───────────────────────────┐  │
│  │      CPU 计算区                                  │    │       GPU 加速区                                     │  │
│  │  AMD TR 7980X 64核                               │    │   NVIDIA A100 40GB / RTX 4000                        │  │
│  │  ─────────────────────      │    │   ┌─────────────────────┐     │  │
│  │  Sentaurus TCAD                                  │    │   │  vLLM / Ollama                           │     │  │
│  │  ├─ SProcess                                   │    │   │  ├─ Llama 3.1-70B                      │     │  │
│  │  ├─ SNMesh (单核5GHz)                          │    │   │  ├─ Qwen 2.5-72B                       │     │  │
│  │  ├─ SDevice (48核并行)  │                     │    │       └─ DeepSeek-Coder                     │     │  │
│  │  └─ SVisual                                    │    │   └─────────────────────┘     │  │
│  │  LS-PrePost / MATLAB                             │    │   PyTorch (代理模型训练)                             │  │
│  └─────────────────────────┘    │   RAG (LangChain+ChromaDB)                           │  │
│              ▲                                            └───────────────────────────┘  │
│              └──────────────────┬───────────────────────────────┘  │
│                                                    ▼                                                                   │
│  ┌────────────────────────────────────────────────────────┐   │
│  │              统一内存层(按场景动态分配)                                                                      │   │
│  │  ────────────────────────────────────────────—──────────│   │
│  │  单元胞/终端仿真:32–85 GB                                                                                    │   │
│  │  10 元胞并联稳态:85–170 GB                                                                                   │   │
│  │  10 元胞并联+瞬态:128–220 GB(峰值场景)                                                                     │   │
│  │  本地LLM服务:20–40 GB(vLLM KV Cache + 权重映射)                                                            │   │
│  │  系统/后处理/缓存:20–30 GB                                                                                   │   │
│  └────────────────────────────────────────────────────────┘   │
│                                                                                                                         │
│  ┌────────────────────────────────────────────────────────┐   │
│  │              存储分层                                                                                          │   │
│  │  4TB NVMe Gen4/Gen5  ──►  /workspace (TCAD工作区+AI模型)                                                    │   │
│  │  20TB SATA           ──►  /archive  (项目归档+材料库+数据集)                                                │   │
│  └────────────────────────────────────────────────────────┘   │
└────────────────────────────────────────────────────────────┘
七、常见问题:硬件配置分析
Q1:Sentaurus TCAD 需要 GPU 加速吗?
传统求解器不需要。SProcess/SDevice/SNMesh 均为 CPU 原生,不支持 GPU 加速。但 Synopsys 2024 年后推出的 ML Calibration Accelerator 支持 GPU 训练代理模型,且本地大模型部署(Llama/Qwen)必须依赖 GPU。如果你确定不需要 AI,GPU 可降级为 RTX A2000/RTX 4000ada;如果需要 "TCAD + AI" 异构工作流,A100 40GB 是黄金选择。
Q2:为什么 SNMesh 网格划分时 CPU 占用不高,但速度很慢?
正常行为。SNMesh 的网格优化算法(Delaunay refinement、自适应加密)是单线程或极少线程的,对 CPU 主频极度敏感。2.7GHz 的服务器跑网格划分可能比 5.0GHz 的桌面平台慢 40–60%。这也是为什么 UltraLAB 推荐高主频 TR 7980X(4.8GHz)而非双路低频 Xeon 的核心原因。
Q3:10 元胞并联仿真需要多少内存?192GB 够吗?
取决于是否做瞬态:
- 10 元胞并联 稳态:峰值 85–170GB,192GB 够用但紧张(余量 20–100GB);
- 10 元胞并联 瞬态(DPT/短路):峰值 128–220GB,192GB 可能不足;
- 若同时运行本地 LLM 服务(+20–40GB),192GB 必然爆内存。
建议:主力做瞬态的用户直接选 256GB,或采用"分时调度"策略(跑 TCAD 前暂停 LLM)。
Q4:双路 Xeon 和单路 TR 7980X 哪个更适合 TCAD?
单路 TR 7980X 更适合 2D TCAD。原因:
- 主频:TR 7980X 全核 4.8GHz,双路 Xeon 通常 2.7–3.0GHz,SNMesh 网格划分速度差距巨大;
- 内存延迟:单路无 NUMA 跨节点访问延迟,SDevice 并行效率更高;
- 性价比:单路 64 核 + 高主频在 2D 场景的综合效率优于双路 128 核 + 低主频。
双路 Xeon/EPYC 的优势仅在 3D 超大规模仿真 或 同时跑 20+ 个 TCAD 作业 时体现。
Q5:本地大模型能替代 TCAD 仿真吗?
不能替代,但能加速设计迭代。本地 LLM 的价值在于:
- 智能辅助:自然语言编写 K 文件、解读 Keyword Manual、排查报错;
- 代理模型:用少量高保真仿真数据训练 ML 模型,毫秒级预测新工况,筛选设计空间;
- 自动化后处理:自动提取击穿电压、导通电阻等关键指标,生成报告。
最终的关键工况验证仍需 TCAD 高保真物理求解,形成 "AI 筛选 → TCAD 验证 → AI 再优化" 的闭环。
Q6:为什么 SiC 器件的 TCAD 仿真比硅器件更吃内存?
三个原因:
- 高击穿电场:SiC 临界电场 (~3 MV/cm) 是硅的 10 倍,耗尽区网格必须加密到 0.01–0.05 μm,同样尺寸的器件网格量是硅的 2–3 倍;
- 宽禁带物理模型:SiC 需要更复杂的能带模型、缺陷模型(如 Z1/2 中心、EH6/7 中心),额外增加变量数;
- 高温特性:SiC 工作结温可达 175–200°C,电热耦合模型必须开启,内存额外 ×1.7。
Q7:如何估算我的具体仿真需要多少内存?
快速估算公式:
内存(GB) ≈ 网格量(万) × 0.6 × 物理模型系数 × 瞬态系数
- 物理模型系数:经典 DD = 1.0;DD + 电热 = 1.7;DD + 电热 + 缺陷 = 2.0
- 瞬态系数:稳态 = 1.0;短瞬态(<100步)= 1.3;长瞬态(>1000步)= 1.8–2.0
示例:10 万网格、DD + 电热、双脉冲测试(500 步)
- 内存 ≈ 10 × 0.6 × 1.7 × 1.5 = 153 GB
- 建议配置:192GB 起步,256GB 保险
八、总结
SiC 功率器件的 Sentaurus TCAD 仿真是一项 "高主频敏感 + 大内存密集" 的计算任务。对于以 2D 单元胞/终端/10 元胞并联 为主力的工程师,UltraLAB 推荐以下选型策略:
| 优先级 | 配置要点 | 理由 |
|---|---|---|
| 1 | CPU 主频 ≥ 4.5GHz | SNMesh 网格划分和 SProcess 工艺仿真对单线程主频极度敏感 |
| 2 | 内存 ≥ 192GB(瞬态用户选 256GB) | 10 元胞并联 + 瞬态峰值可达 220GB,内存不足是仿真崩溃的首要原因 |
| 3 | 单路高主频平台优于双路低频平台 | 2D 仿真中,单核性能的收益远高于核心数量 |
| 4 | GPU 按需配置 | 纯 TCAD 不需要 GPU;需要本地大模型/ML Calibration 时选 A100 40GB |
| 5 | NVMe + SATA 分层存储 | 瞬态仿真产生海量临时文件,高速 NVMe 工作盘 + 大容量 SATA 归档盘是标配 |
UltraLAB 承诺:与"三最"不符(最先进 + 最快 + 最优配置),直接退货。欢迎远程测试,验证 Sentaurus TCAD 在您实际 SiC 器件工况下的求解效率与稳定性。
关于 UltraLAB
UltraLAB 是西安坤隆计算机科技有限公司旗下高端图形工作站品牌,专注为科学计算、工程仿真、AI 训练等场景提供超频硬件配置方案。从单机到集群,从 CPU 到 GPU,UltraLAB 为每一位工程师提供"为任何应用提供最快计算设备"的极致体验。
本文配置基于 UltraLAB 2026 基准报价表,具体方案请联系技术顾问定制。


