适用读者:药物设计与计算化学研究人员、生物医药企业早期发现团队、高校药学与化学生物学课题组。
一、资料背景与核心观点
资料来源
- AutoDock Vina 官方文档(分子对接与虚拟筛选)(https://vina.scripps.edu/)
- RCSB PDB 蛋白质结构数据库(https://www.rcsb.org/)
- EMBL-EBI 生物信息学资源(https://www.ebi.ac.uk/)
核心观点
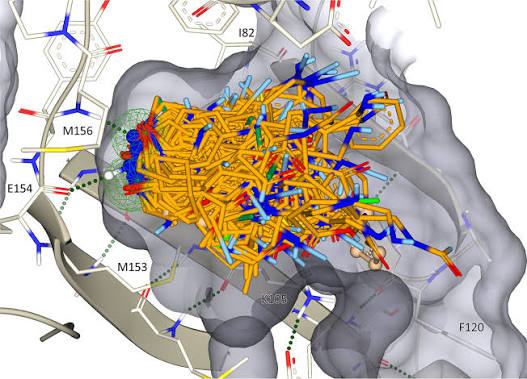
- 分子对接由构象搜索与打分函数两部分组成:搜索采用蒙特卡洛或遗传算法在扭转角空间采样,打分为经验或半经验能量项求和。
- 单次对接通常在数秒到数分钟量级,真正的算力需求来自化合物库规模:百万级分子×多个结合位点会产生海量独立任务。
- 对接任务之间几乎无通信,属于典型的易并行负载,调度效率与单任务耗时共同决定总吞吐,而非单机峰值算力。
- 结合位点预测、蛋白准备与结果聚类同样是流程瓶颈,蛋白预处理与后处理常被低估。
二、核心算法与功能模块
核心算法
- 蒙特卡洛与遗传算法构象搜索。
- 经验打分函数与格点能量预计算。
- 柔性配体扭转树采样。
- 结果聚类与打分重排(如共识打分)。
功能模块
- 蛋白与配体结构准备、加氢与电荷分配。
- 结合位点盒定义与格点计算。
- 批量对接调度与断点续算。
- 打分排序、相互作用分析与结果导出。
三、计算特点与性能瓶颈
计算负载特征
- 计算类型:小规模标量运算加随机搜索,单任务内存极小。
- 并行方式:任务级并行度极高;GPU 批量对接可把多分子映射到同一卡内并行。
- 内存与显存:内存按并发任务数×单任务占用估算;显存仅在使用 GPU 版本时需要。
- I/O 特点:配体文件数量可达百万级,小文件随机读取多,存储元数据性能直接影响调度效率。
关键硬件约束
单任务太小,用高配单机跑单分子是浪费;真正的瓶颈常在任务调度与小文件 I/O。GPU 批量对接需要相应实现的版本支持,打分函数与 CPU 版可能不同,结果须做一致性校验。
四、典型应用场景
- 轻量:数十至数百分子的靶点验证性筛选。
- 中等:万级化合物库×单靶点筛选、多构象重对接。
- 大规模:百万级库×多靶点筛选、共识打分与二次重排。
五、UltraLAB 硬件配置分级方案
表1 UltraLAB 硬件配置分档建议
| 档位 | CPU选型思路 | 内存配置 | GPU选型(核心) | 存储配置 | 散热与扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 轻量档 | 参考 A350 平台,Ultra9 285K 24核 5.5GHz,多任务并行 | 64 至 96GB DDR5,支撑高并发任务队列 | 专业卡用于蛋白-配体相互作用可视化 | 2TB NVMe 系统盘 + 4TB 项目盘 | 塔式风冷 | 百级分子验证性筛选 |
| 主流档 | 参考 AE450/AX450 平台,霄龙 9654 96核或 9755 128核,任务并行密度高 | 128 至 256GB DDR5,支撑万级库并发 | 可选 GPU 用于批量对接加速 | 4TB NVMe + 16TB SATA,小文件目录单独盘位 | 塔式水冷,长时间批量任务稳定 | 万级库筛选、多靶点并行 |
| 大规模档 | 参考 EA660 平台,2×霄龙 9654 192核或 2×9755 256核,配合调度系统 | 512GB 以上 DDR5,支撑百万级任务队列缓存 | 多卡用于 GPU 批量对接 | Gen4 NVMe 阵列 + 万兆网络 + 并行文件系统 | 机架式水冷,机房部署 | 百万级库筛选、共识打分重排 |
选型原则:按任务总数与并发密度定核心与内存,按小文件规模定存储,GPU 作为可选加速并需校验一致性。
六、配套软件清单
表2 配套软件清单
| 软件类别 | 软件名称 | 版本/要求 | 必需/可选 |
|---|---|---|---|
| 分子对接 | AutoDock Vina、AutoDock-GPU、Schrodinger Glide 类工具 | 按许可/稳定版 | 必需 |
| 结构准备 | AutoDockTools、Open Babel、PDBFixer | 稳定版 | 必需 |
| 结构数据 | RCSB PDB、AlphaFold DB | 在线/本地镜像 | 必需 |
| 任务调度 | Slurm、GNU Parallel | 稳定版 | 大规模必需 |
| 结果分析 | PyMOL、LigPlot+、Python 分析脚本 | 稳定版 | 可选 |
| 运行环境 | Ubuntu 22.04 LTS | LTS | 必需 |
七、常见选型问题与硬件分析
Q:虚拟筛选该堆核心还是堆显卡?
A:先看流程形态。CPU 多任务并行的通用性最好;GPU 批量对接适合有成熟实现的场景,但打分与 CPU 版可能不同,需一致性校验。
Q:为什么高配单机跑单分子不划算?
A:单次对接只需数秒到数分钟,用 128 核跑一个分子大部分核心闲置。价值在于并发成百上千个任务,配置应围绕任务密度设计。
Q:小文件太多会拖慢吗?
A:会。百万级配体文件会产生大量元数据操作,机械盘或高延迟网络存储会显著拉长调度。热数据放本地 NVMe 通常比加显卡更有效。
Q:结果可信度靠硬件提升吗?
A:不能。打分函数的近似与蛋白构象质量决定结果可信度,硬件只影响吞吐。建议做重对接与共识打分以提高筛选可靠性。
八、总结与选型建议
- 负载本质是海量独立小任务,吞吐由并发密度与调度效率决定。
- 轻量档做验证性筛选;主流档做万级库多靶点;大规模档做百万级库与共识重排。
- 优先保证 NVMe 与小文件 I/O,再考虑 GPU 批量加速并做结果一致性校验。
补充说明:对接结果属于计算预测,需经实验验证;本文不涉及具体靶点或化合物,仅讨论计算负载与硬件配置。
参考来源
- AutoDock Vina 官方文档(分子对接与虚拟筛选):https://vina.scripps.edu/
- RCSB PDB 蛋白质结构数据库:https://www.rcsb.org/
- EMBL-EBI 生物信息学资源:https://www.ebi.ac.uk/