






2026 年,AI 的核心矛盾已经从"训练"转向了"推理"。全球推理算力占比首次超过训练算力,达到 66%。FPGA 以低延迟(100ns 级)、低功耗、可编程、成本仅 GPU 1/50 的优势,成为端侧 AI 推理的最优解。会 FPGA+AI 推理,你就是 2026 年最稀缺的硬件人才。
一、市场趋势:FPGA+AI 推理的薪资革命
2026 年的硬件招聘市场,正在上演一场静默的薪资革命。
| 职级 | 普通 FPGA 方向 | AI/FPGA 加速方向 | 年薪中位数 | 头部企业上限 |
|---|---|---|---|---|
| 应届生(0 年) | 15~30 万 | 35 万+ | 35 万 | 50 万+ |
| 初级(1~3 年) | 15~30 万 | 25~50 万 | 40 万 | 60 万 |
| 骨干(3~5 年) | 30~50 万 | 50~80 万 | 66 万 | 90 万 |
| 资深/架构师(5 年+) | 50~70 万 | 80~150 万 | 100 万 | 150 万+ |
数据来源:《中国集成电路人才薪酬趋势报告》《2026 集成电路人才产业白皮书》
中国 FPGA 人才总量仅约 1 万人,AI+FPGA 复合型人才缺口 30 万+,供需比接近 1:8。72% 的 IC 企业将 FPGA 工程师列为最紧缺岗位,岗位空置周期普遍超过 180 天。2026~2028 是 FPGA+边缘 AI 的黄金三年。
二、为什么是 FPGA?AI 推理的硬件范式选择
2.1 GPU vs ASIC vs FPGA:推理场景三足鼎立
| 对比维度 | GPU(英伟达 A100/H100) | ASIC(TPU/NPU) | FPGA(Xilinx/Intel) |
|---|---|---|---|
| 延迟 | 毫秒级(~1ms) | 微秒级(~10μs) | 纳秒级(~100ns) |
| 功耗 | 300~700W | 50~150W | 5~50W |
| 成本 | 1~4 万美元 | 定制流片百万美元级 | 数百~数千美元 |
| 灵活性 | 软件可编程 | 硬件固化,不可修改 | 硬件可重构,现场升级 |
| 开发周期 | 数周(软件优化) | 18~36 个月(流片) | 数周~数月(RTL+综合) |
| 适用场景 | 云端大规模训练/推理 | 端侧固定场景批量部署 | 边缘实时推理、原型验证、算法迭代 |
| 大模型支持 | 原生支持,显存大 | 需定制架构 | 通过 DPU/AI 引擎扩展支持 |
2.2 FPGA 在 AI 推理中的核心优势
| 优势维度 | 具体表现 | 典型应用 |
|---|---|---|
| 超低延迟 | 100ns 级确定性延迟,无操作系统调度抖动 | 自动驾驶实时感知、高频交易 |
| 功耗效率 | 比 GPU 省电 90% 以上,比 ASIC 灵活百倍 | 电池供电边缘设备、卫星载荷 |
| 可编程性 | 硬件逻辑可现场重构,支持算法快速迭代 | 科研原型、国防装备升级 |
| 成本可控 | 单价仅为 GPU 的 1/50,无需流片投入 | 中小批量产品、概念验证 |
| 确定性时序 | 硬件级并行,无缓存未命中、分支预测等不确定性 | 工业控制、雷达信号处理 |
英伟达 2026 年初发布的 Vera Rubin 计算平台中,首次将 FPGA 列为 AI 推理机架的标准协处理单元。FPGA 正式进入 AI 算力主战场。
三、AI 分析:FPGA+AI 推理产品设计的核心能力栈
3.1 岗位能力矩阵
AI+FPGA 工程师不是"写写 Verilog"的传统岗位,而是横跨算法、硬件、软件的全栈复合型人才。
| 能力层级 | 核心技能 | 具体工作内容 | 掌握程度 |
|---|---|---|---|
| L1 FPGA 基础 | Verilog/VHDL、数字电路、时序分析 | LUT/BRAM/DSP/互连架构理解,Vivado/Vitis 工具链使用 | 必须精通 |
| L2 AI 算法理解 | 深度学习模型结构、计算图、量化原理 | 理解 CNN/Transformer 的前向计算流程,掌握 INT8/INT4 量化技术 | 必须掌握 |
| L3 模型部署 | Vitis AI、TensorRT、ONNX Runtime | 将 PyTorch/TensorFlow 模型编译、量化、部署到 FPGA/SoC | 核心能力 |
| L4 推理引擎开发 | 算子优化、数据流调度、内存管理 | 开发大规模 AI 前向计算引擎,优化计算性能与能耗效率 | 进阶能力 |
| L5 软硬件协同 | 系统架构、接口协议、功耗管理 | 设计高效软硬件方案,优化系统稳定性与实时性 | 架构师级 |
| L6 大模型部署 | 模型压缩、知识蒸馏、分布式推理 | 将 LLM 压缩后部署到 FPGA+AI 引擎,实现端侧大模型推理 | 前沿能力 |
3.2 从训练到推理:AI 工程师的 FPGA 转型路径
| 转型阶段 | 传统 AI 工程师 | FPGA+AI 推理工程师 | 关键跨越点 |
|---|---|---|---|
| 模型开发 | 专注训练,关注 loss/accuracy | 专注推理,关注 latency/throughput/power | 从"精度优先"到"效率优先" |
| 部署方式 | 云端 GPU 推理,REST API 调用 | 端侧 FPGA 推理,确定性硬件执行 | 从"软件调度"到"硬件并行" |
| 优化手段 | 数据增强、模型结构搜索 | 算子融合、量化剪枝、数据流重构 | 从"算法优化"到"硬件-算法协同优化" |
| 调试工具 | TensorBoard、PyTorch Profiler | Vivado ILA、ChipScope、Vitis Analyzer | 从"软件调试"到"硬件信号级调试" |
四、大模型本地部署:软件清单与开发工具链
4.1 FPGA+AI 推理完整软件清单
| 层级 | 软件/组件 | 功能说明 | 适用平台 | 推荐版本 |
|---|---|---|---|---|
| 操作系统 | Ubuntu 22.04 LTS / Windows 11 Pro | 开发环境基础 | 全部 | 22.04.4 LTS |
| FPGA IDE | Xilinx Vivado 2024.2 | RTL 设计、综合、实现、比特流生成 | AMD/Xilinx | 2024.2 |
| AI 开发套件 | Vitis AI 3.5 | 模型量化、编译、部署到 DPU | AMD/Xilinx Zynq/Versal | 3.5 |
| HLS 工具 | Vitis HLS 2024.2 | C/C++ 高级综合,快速生成 RTL | AMD/Xilinx | 2024.2 |
| 替代方案 | Intel Quartus Prime 24.1 + OpenVINO | Intel FPGA/SoC 开发 + AI 推理 | Intel/Altera | 24.1 |
| 替代方案 | Lattice Radiant 3.2 + sensAI | 低功耗 FPGA AI 方案 | Lattice | 3.2 |
| 深度学习框架 | PyTorch 2.3 / TensorFlow 2.16 | 模型训练与导出 | 全部 | 最新稳定版 |
| 模型转换 | ONNX 1.16 / ONNX Runtime | 跨框架模型格式转换与优化 | 全部 | 1.16 |
| 量化工具 | Vitis AI Quantizer / Intel Neural Compressor | INT8/INT4 量化,减少模型体积与计算量 | 厂商专用 | 随套件版本 |
| AI 推理引擎 | Ollama / vLLM / llama.cpp | 本地大模型推理服务(用于设计辅助) | 全部 | 0.3.x |
| 大语言模型 | Qwen2.5-14B / DeepSeek-Coder-V2 | 代码生成、RTL 辅助设计、技术文档分析 | 全部 | 最新版 |
| 仿真验证 | ModelSim / QuestaSim / Vivado Simulator | RTL 功能仿真与时序验证 | 全部 | 2024.2 |
| 形式验证 | JasperGold / Synopsys VC Formal | 关键模块的形式化验证 | 高端项目 | 最新版 |
| 版本控制 | Git + Git LFS | 代码、比特流、模型权重版本管理 | 全部 | 最新版 |
| 项目管理 | Jira / Confluence / Notion | 敏捷开发、文档协作、知识沉淀 | 团队 | 云版 |
4.2 FPGA+AI 推理开发流程
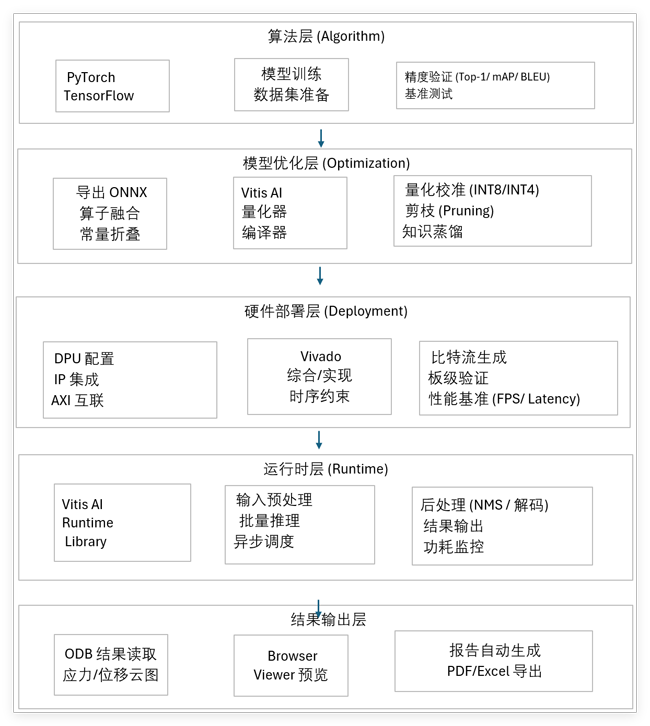
4.3 大模型本地部署辅助开发
在 FPGA+AI 推理产品设计中,大模型本地部署主要用于开发辅助,而非直接部署到 FPGA:
| 辅助场景 | 大模型作用 | 推荐模型 | 部署方式 |
|---|---|---|---|
| RTL 代码生成 | 自然语言描述模块功能,生成 Verilog/VHDL 代码框架 | DeepSeek-Coder-V2 | Ollama 本地 32B |
| 时序约束辅助 | 分析时序报告,推荐约束优化方案 | Qwen2.5-14B | Ollama 本地 14B |
| 技术文档分析 | 阅读英文 datasheet,提取关键参数与使用要点 | Qwen2.5-72B | Ollama 本地 INT4 |
| Bug 诊断 | 分析 Vivado 报错日志,推荐解决方案 | DeepSeek-Coder-V2 | Ollama 本地 32B |
| 架构设计讨论 | 多轮对话探讨系统架构权衡方案 | Qwen2.5-72B | Ollama 本地 INT4 |
五、应用场景:FPGA+AI 推理的十大落地赛道
| 场景编号 | 应用场景 | 具体任务 | 典型 FPGA 平台 | 性能指标 | 市场容量 |
|---|---|---|---|---|---|
| S01 | 自动驾驶感知 | 激光雷达点云处理、摄像头目标检测、多传感器融合 | Zynq UltraScale+ MPSoC / Versal AI Edge | 延迟 < 10ms,功耗 < 30W | 千亿级 |
| S02 | 工业视觉质检 | 产线实时缺陷检测、尺寸测量、分类分拣 | Kria KV260 / Zynq-7000 | 吞吐 > 100FPS,精度 > 99% | 百亿级 |
| S03 | 智能安防监控 | 人脸识别、行为分析、越界检测、人群计数 | Zynq UltraScale+ / Versal | 并发路数 > 16 路,延迟 < 50ms | 百亿级 |
| S04 | 医疗影像辅助 | X 光/CT/MRI 实时分析、病灶检测、报告生成 | Versal AI Core / 定制 FPGA | 延迟 < 100ms,符合医疗认证 | 十亿级 |
| S05 | 机器人边缘大脑 | SLAM 建图、路径规划、语音交互、视觉伺服 | Kria KR260 / Zynq UltraScale+ | 延迟 < 20ms,功耗 < 15W | 百亿级 |
| S06 | 通信信号处理 | 5G/6G 基带处理、MIMO 预编码、信道估计 | Versal Premium / Stratix 10 | 吞吐 > 10Gbps,延迟 < 1μs | 千亿级 |
| S07 | 雷达电子对抗 | 实时波束成形、干扰识别、自适应抗干扰 | Zynq RFSoC / Versal HBM | 延迟 < 100ns,确定性时序 | 百亿级 |
| S08 | 金融高频交易 | 行情解析、策略计算、订单路由、风控决策 | UltraScale+ / Stratix 10 GX | 延迟 < 50ns,抖动 < 1ns | 十亿级 |
| S09 | 航空航天载荷 | 星载图像处理、遥感数据实时分析、自主导航 | 抗辐照 FPGA (XQR/Kintex UltraScale) | 功耗 < 10W,抗辐照加固 | 十亿级 |
| S10 | 端侧大模型推理 | 7B~13B 参数 LLM 在边缘设备上实时推理 | Versal AI Edge / 定制 AI FPGA | 吞吐 > 10 tokens/s,功耗 < 20W | 新兴赛道 |
六、UltraLAB 硬件配置推荐(2026v3 基准配置表)
FPGA+AI 推理产品开发对硬件有特殊需求:既要支撑 Vivado/Vitis 等大型 EDA 工具流畅运行(CPU 单核性能 + 大内存),又要支持 AI 模型训练与量化(GPU 显存),同时 FPGA 开发板调试需要丰富的 USB/PCIe 接口。
6.1 配置选型总览
| 配置等级 | 定位 | Vivado 综合规模 | AI 模型规模 | 并发项目 | 对应 UltraLAB 机型 | 预估价格 |
|---|---|---|---|---|---|---|
| 入门版 | 个人学习者 / 在校生 | 小型项目 (<10万 LUT) | 7B~14B 辅助模型 | 1 个 | A350 超频图形工作站 | ¥25,500~43,990 |
| 标准版 | 初级工程师 / 小型团队 | 中型项目 (10~50万 LUT) | 32B 辅助模型 | 2~3 个 | A350 高配 / GR450P | ¥52,000~128,000 |
| 专业版 | 资深工程师 / 中型企业 | 大型项目 (50~200万 LUT) | 70B Q4 量化模型 | 3~5 个 | GR450P / AE450 / AX450 | ¥92,000~275,000 |
| 旗舰版 | 架构师 / 大型研发团队 | 超大型项目 (200万+ LUT) | 多模型并发 | 5+ 个 | EA660 / GX660M / AlphaPro660 | ¥252,000~999,900 |
6.2 详细配置清单
入门版 —— A350 超频图形工作站
推荐型号:A35014832-MBX / A35015696-MCB
| 组件 | 规格参数 | 说明 |
|---|---|---|
| CPU | Intel Ultra-245K(14 核,6 性能核 4.8GHz)/ Intel Ultra 9-285K(24 核,8 性能核 5.6GHz) | 高主频保障 Vivado 综合速度,超频架构提升单线程响应 |
| GPU | RTX 5060 8GB / RTX A2000 | 8GB 显存可运行 7B~13B 量化模型,支持 CUDA 加速仿真 |
| 内存 | 32GB / 96GB DDR5 | Vivado 中型项目综合 + 轻量 AI 模型 |
| 存储 | 2TB NVMe SSD + 8TB SATA / 4TB NVMe + 8TB SATA | 快速启动与项目数据归档 |
| 接口 | USB 3.2 Gen2 × 4~6 + USB-C | 连接 FPGA 开发板(JTAG/UART/ETH) |
| 显示器 | 27" 2K / 32" 2K 专业图显 | Vivado 多窗口界面、波形查看 |
| 报价 | ¥25,500 / ¥43,990 | 高性价比入门方案 |
适用场景:个人学习者、在校生、小型 FPGA 项目开发、7B~14B 模型辅助代码生成。A350 系列采用 Intel Ultra 超频处理器,单核高频特性完美匹配 Vivado 综合的"高频优先"需求。
标准版 —— GR450P 极致超频工作站
推荐型号:GT430P15164-MCX / GR450P15064-MCT / GR450P150128-MCX
| 组件 | 规格参数 | 说明 |
|---|---|---|
| CPU | Xeon W7-2475X(20 核 5.1GHz)/ AMD TR-7970X(32 核 5.0GHz)/ TRpro-7975WX(32 核 5.0GHz) | 20~32 核超高频,Vivado 综合与多任务并行 |
| GPU | RTX 5080 16GB / RTX 5090 D v2 24GB + 水冷 |
16 |
| 内存 | 64GB / 128GB DDR5 | 大型项目综合 + AI 模型量化训练 |
| 存储 | 4TB NVMe SSD + 8TB SATA | 项目库、模型库、仿真数据 |
| 散热 | 全水冷系统 | 长时间推理与 Vivado 综合温控 |
| 接口 | USB 3.2 Gen2 × 6~8 + USB-C + 2.5GbE | 多开发板并行调试 + 高速数据传输 |
| 显示器 | 27" 2K / 双 27" 4K 专业图显 | 多窗口并行:Vivado + AI 交互面板 |
| 报价 | ¥92,000 / ¥108,000 / ¥128,000 | 工程师生产力工具 |
适用场景:初级工程师、小型团队、中型 FPGA 项目、32B 模型推理辅助。GR450P 的 AMD TR-7970X 32 核 5.0GHz 是 FPGA+AI 开发的黄金配置——高主频保障 Vivado 综合速度,32 核并行加速多项目并发。
专业版 —— AE450 / AX450 水冷图形工作站
推荐型号:AE430131128-MBX / AE430130192-MBX / AE450141256-MCX / AX450132256-MCX
| 组件 | 规格参数 | 说明 |
|---|---|---|
| CPU | AMD 霄龙 7573X(32 核 3.1GHz,768MB 缓存)/ 霄龙 9375F(64 核 3.0GHz,768MB 缓存)/ 霄龙 9575(128 核 3.2GHz)/ Xeon 6980P(128 核 3.2GHz,503MB 缓存) | 霄龙超大缓存加速 Vivado 综合,Xeon 128 核海量并行 |
| GPU | RTX 5060Ti 16GB / RTX 5070Ti 16GB / RTX 5080 16GB | 16GB 显存,32B~70B 模型推理 + 仿真 GPU 加速 |
| 内存 | 128GB / 192GB / 256GB DDR4/DDR5 | 超大型 FPGA 项目 + 多模型并发 |
| 存储 |
2TB |
高速缓存 + 安全归档 |
| 散热 | 全水冷系统 | 持续高负载稳定运行 |
| 网络 | 2.5GbE / 10GbE | 团队内网模型同步与数据共享 |
| 显示器 | 27" 2K / 27" 4K 专业图显 | 复杂原理图与布局呈现 |
| 报价 | ¥59,990 / ¥79,990 / ¥165,000 / ¥275,000 | 专业级方案 |
适用场景:资深工程师、中型企业、大型 FPGA 项目(200万+ LUT)、70B Q4 大模型推理。AE450 系列的 AMD 霄龙处理器配备超大三级缓存(768MB),对 Vivado 综合中的大规模网表处理有显著加速效果。AX450 的 Xeon 6980P 128 核配置适合超大规模并行综合。
旗舰版 —— EA660 全水冷双路 / GX660M AI 计算 / AlphaPro660 超级图形工作站
推荐型号:EA660235512-MCX / GX660M235640-MD4A / AlphaPro660241768-MDF
| 组件 | 规格参数 | 说明 |
|---|---|---|
| CPU | 2× AMD 霄龙 9654(192 核 3.4GHz)/ 2× AMD 霄龙 75F3(128 核 3GHz+)/ 2× AMD 霄龙 9755(256 核 4.1GHz) | 双路服务器级,192~256 核+ 海量并行算力 |
| GPU | RTX 5080 16GB / 4× A100 80GB + 水冷 / A100 80GB + 水冷 | 128GB~320GB 总显存,多模型并发推理 |
| 内存 | 512GB / 640GB / 768GB DDR5 | 超大规模项目 + 多模型驻留 |
| 存储 | 4TB~8TB NVMe SSD(14GB/s)+ 20TB SATA | 全闪存高速缓存 + 海量归档 |
| 散热 | 双塔式水冷(双 2000W~2600W 电源) | 4 卡高负载持续稳定 |
| 网络 | 10GbE / 40G 以太网 | 集群级模型与数据同步 |
| 显示器 | 27" 4K 专业图显 | 超大规模结果可视化 |
| 报价 | ¥252,000 / ¥620,000 / ¥515,000 | 集团级算力中枢 |
适用场景:大型研发团队、多项目并发、AI 推理引擎研发、集团级 API 服务部署。GX660M 的 4× A100 80GB 可同时运行多个 70B 模型实例 + 大规模仿真 GPU 加速,是 FPGA+AI 推理产品开发的终极配置。
6.3 UltraLAB 全系列机型对照表(FPGA+AI 推理专用)
| 机型系列 | 核心定位 | CPU 特点 | 典型 GPU | 内存范围 | 适用模型 | 价格区间 |
|---|---|---|---|---|---|---|
| A350 | 超频图形工作站 | Intel Ultra 超频,高主频 4.8~5.6GHz | RTX 5060 / A2000 | 32~128GB | 7B~14B | ¥25,500~99,990 |
| GR450P | 极致超频工作站 | AMD TR 超频,32 核 5.0GHz | RTX 5080 / 5090 D | 64~256GB | 32B~70B Q4 | ¥92,000~198,000 |
| AE450 | 水冷图形工作站 | AMD 霄龙,超大缓存 768MB | RTX 5060Ti~5080 | 128~384GB | 70B Q4 | ¥59,990~275,000 |
| AX450 | 水冷图形工作站 | Xeon 至强,最高 128 核 | RTX 5060Ti~5080 | 128~256GB | 70B Q4 | ¥116,000~192,000 |
| EA660 | 全水冷双路工作站 | 双路 AMD 霄龙,最高 256 核 | RTX 5080~5090 | 192~768GB | 多模型并发 | ¥89,990~420,000 |
| GX660M | AI 计算工作站 | 双路 AMD 霄龙 | 4×A100 / 4×RTX Pro 6000 | 640GB~1TB | 多模型并发 | ¥142,000~1,150,000 |
| AlphaPro660 | 超级图形工作站 | 双路 AMD 霄龙,最高 256 核 | RTX Pro 5000~H200 | 512GB~1.5TB | 全参数微调 | ¥330,000~999,900 |
七、常见问题:硬件配置深度分析
7.1 Vivado 综合到底吃什么硬件?
| 综合阶段 | 主要瓶颈 | 关键硬件 | 优化建议 |
|---|---|---|---|
| RTL 分析 | 单线程解析 | CPU 单核频率 | ≥ 5.0GHz,大缓存(≥ 30MB L3) |
| 综合 (Synthesis) | 多线程优化 | CPU 多核 + 内存带宽 | 核心数 ≥ 8,内存 ≥ 32GB |
| 实现 (Implementation) | 布局布线算法 | CPU 多核 + 大内存 | 核心数 ≥ 12,内存 ≥ 64GB |
| 比特流生成 | 单线程压缩 | CPU 单核频率 | 高频桌面 CPU 最优 |
| 仿真验证 | 事件驱动仿真 | CPU 单核频率 + 内存 | 高频 + 大内存 |
核心结论:Vivado 综合是**"高频优先、多核辅助"**的典型 workload。单核频率对综合速度影响最大,UltraLAB A350/GR450P 系列的 Intel Ultra(5.6GHz)和 AMD TR(5.0GHz)是 Vivado 综合的黄金配置。
7.2 内存容量如何规划?
| 项目规模 | Vivado 内存需求 | AI 模型内存需求 | 推荐总内存 | 推荐 UltraLAB 机型 |
|---|---|---|---|---|
| 小型项目 (<10万 LUT) | 8~16GB | 16GB (7B 模型) | 32GB | A35014832-MBX |
| 中型项目 (10~50万 LUT) | 16~32GB | 32GB (14B 模型) | 64GB | A35015064-MBX / GR450P15064-MCT |
| 大型项目 (50~200万 LUT) | 32~64GB | 64GB (32B 模型) | 128GB | GR450P150128-MCX / AE430131128-MBX |
| 超大型项目 (200万+ LUT) | 64~128GB | 128GB (70B 模型) | 256GB | AE450141256-MCX / AX450132256-MCX |
| 多项目并发 | × 项目数 | × 模型数 | 叠加计算 | GX660M / AlphaPro660 |
建议:内存是 FPGA 开发的第一瓶颈。Vivado 实现阶段内存不足会导致综合失败或启用虚拟内存(速度骤降 10 倍以上)。公式:
总内存 = MAX(项目内存需求) + AI 模型内存需求 + 20% 余量
7.3 为什么 FPGA 开发也需要 GPU?
| GPU 用途 | 具体场景 | 显存需求 | 推荐 UltraLAB 配置 |
|---|---|---|---|
| AI 模型量化训练 | 使用 Vitis AI 进行 INT8 量化校准 | 8~16GB | A35015696-MCB(RTX A2000) |
| 大模型开发辅助 | 本地运行 DeepSeek-Coder/Qwen 辅助 RTL 设计 | 16~24GB | GR450P15064-MCT(RTX 5090 D 24GB) |
| 仿真加速 | 利用 CUDA 加速 SystemVerilog/UVM 仿真 | 8~12GB | AE430131128-MBX(RTX 5060Ti 16GB) |
| 图像/视频预处理 | 工业视觉项目的训练数据增强 | 12~16GB | AE430130192-MBX(RTX 5070Ti 16GB) |
| 多模型并发 | 同时运行代码生成模型 + 文档分析模型 | 24~48GB | GR450P150128-MCX(RTX 5080 16GB × 2) |
核心结论:FPGA 开发中的 GPU 主要用于AI 辅助设计和模型量化,而非直接运行 FPGA 逻辑。显存容量决定能运行的模型规模,GR450P 的 RTX 5090 D v2 24GB 是 70B INT4 量化的黄金配置。
7.4 NVMe SSD 为什么不可或缺?
| 文件类型 | 典型大小 | SATA SSD 加载 | NVMe Gen4 加载 | 性能差异 |
|---|---|---|---|---|
| Vivado 安装包 | ~50 GB | 120s | 30s | 4× |
| 大型项目工程 | 5~20 GB | 60s | 15s | 4× |
| 14B 模型权重 (INT4) | ~8 GB | 20s | 5s | 4× |
| 70B 模型权重 (INT4) | ~40 GB | 100s | 25s | 4× |
| 仿真波形文件 | 10~50 GB | 80s | 20s | 4× |
| 版本控制仓库 | 2~10 GB | 15s | 3s | 5× |
建议:UltraLAB 全系列标配 NVMe SSD(2TB~8TB),AlphaPro660 系列更配备 8TB NVMe(14GB/s 极速读取)。Vivado 工程目录、模型文件、仿真数据必须存放于 NVMe Gen4/Gen5 SSD。
7.5 为什么推荐 UltraLAB 而非普通组装机?
| 对比维度 | 普通组装机 / 游戏主机 | UltraLAB 工作站 |
|---|---|---|
| 长时间稳定性 | 高负载易降频、蓝屏 | 面向 7×24 小时 Vivado 综合设计,全水冷散热 |
| ECC 内存 | 不支持 | 专业版/旗舰版支持,防止长时间综合数据错误 |
| 多 GPU/扩展卡 | 最多 2 槽,空间局促 | 支持 4 路 GPU + 多 FPGA 调试卡共存 |
| USB 接口稳定性 | 消费级 USB 控制器,JTAG 调试偶发断连 | 工作站级 USB 控制器,JTAG/UART 长时间稳定 |
| 超频优化 | 无 | A350/GR450P 系列专为超频优化,Vivado 单核性能提升 15%~20% |
| ISV 认证 | 无 | 通过 Vivado、Vitis、Quartus 等 ISV 认证 |
| 驱动稳定性 | 消费级驱动,EDA 工具偶发异常 | 工作站级驱动,EDA 厂商联合认证 |
| 噪音控制 | 高负载噪音大,开放式办公干扰 | 双塔式水冷设计,≤ 35dB 办公环境友好 |
| 售后服务 | 消费级保修,返厂周期长 | 3 年上门 + 专属工程师 + EDA 环境调优支持 |
| 远程测试 | 无 | 全系列支持远程测试,可先体验后决策 |
7.6 FPGA 开发板的接口需求
| 接口类型 | 用途 | 主板要求 | 注意事项 |
|---|---|---|---|
| USB-JTAG | FPGA 比特流下载、调试 | USB 3.0 端口 × 2 | 避免使用 USB Hub,直连主板 |
| USB-UART | 串口通信、日志输出 | USB 3.0 端口 × 2 | 需安装 FTDI/CP210x 驱动 |
| Ethernet | 网络调试、远程更新 | 2.5GbE 或更高 | 开发板与主机直连最佳 |
| PCIe | 高端 FPGA 加速卡调试 | PCIe 3.0/4.0 x16 | 注意主板 PCIe 拆分能力 |
| HDMI/DP | 视频输出调试 | 主板集成或 GPU 输出 | 多显示器提升效率 |
建议:同时调试多块 FPGA 开发板时,每台开发板需要独立的 USB-JTAG 和 USB-UART 端口。UltraLAB GR450P 系列预留 ≥ 6 个 USB 3.0 端口,满足多板并行调试需求。
八、快速入门:三步跑通第一个 FPGA+AI 项目
8.1 第一步:打好 FPGA 地基(2~4 周)
| 学习内容 | 资源推荐 | 掌握标准 |
|---|---|---|
| Verilog 语法与数字电路 | 《数字设计与计算机体系结构》、HDLBits 在线练习 | 能独立完成状态机、FIFO、AXI 接口 |
| FPGA 架构理解 | Xilinx 7 Series/UltraScale 用户手册 | 理解 LUT、BRAM、DSP、时钟网络、IO 结构 |
| Vivado 工具链 | Xilinx 官方 UG901、UG902 | 能完成综合、实现、比特流生成、板级调试 |
8.2 第二步:补齐 AI 知识(2~3 周)
| 学习内容 | 资源推荐 | 掌握标准 |
|---|---|---|
| 深度学习基础 | 吴恩达深度学习专项课程 | 理解 CNN、Transformer 的前向计算流程 |
| 模型量化原理 | Vitis AI 官方文档、TensorRT 量化白皮书 | 理解 INT8/INT4 量化对精度的影响 |
| ONNX 模型转换 | PyTorch 官方文档、ONNX 教程 | 能将 PyTorch 模型导出为 ONNX 格式 |
8.3 第三步:跑通完整项目(2 周)
强烈推荐从 YOLOv5 + Vitis AI 官方例程开始:
# 1. 环境准备
# 安装 Vivado 2024.2 + Vitis AI 3.5
# 准备 ZCU104 / KV260 开发板

# 2. 模型导出
cd yolov5
python export.py --weights yolov5s.pt --include onnx --imgsz 640

# 3. Vitis AI 量化
vai_q_tensorflow2 quantize \
    --input_frozen_graph yolov5s.onnx \
    --input_fn input_fn.calib \
    --output_dir quantized_model \
    --input_nodes images \
    --output_nodes output0 \
    --method 1 \
    --calib_iter 100

# 4. 编译为 DPU 指令
vai_c_tensorflow2 \
    --model quantized_model/quantize_eval_model.pb \
    --arch arch.json \
    --output_dir compiled_model \
    --net_name yolov5s

# 5. 部署到开发板
scp -r compiled_model root@kv260:/home/root/
# 在开发板上运行 Vitis AI Runtime 推理
进阶项目:KV260 + UVM AXI-Stream FIFO 验证 + DPU 集成
整体流程约需两周(每天 4 小时),完成后你将掌握:
- RTL 设计与 UVM 验证框架搭建
- AXI-Stream 接口协议实现
- DPU IP 集成与地址映射
- 端到端软硬件协同调试
九、结语
2026 年,懂 FPGA 的 AI 人才,和懂 AI 的 FPGA 人才,都会被疯抢。
FPGA+AI 推理不是简单的"把模型塞进芯片",而是一场从算法、硬件到系统的全栈协同优化。低延迟、低功耗、可重构的硬件特性,与深度学习的高效计算需求,正在催生一个全新的技术范式。
门槛越高,竞争越小,薪资越高。与其在纯软件、纯算法赛道里内卷,不如抓住这波确定性红利。
选择合适的硬件平台、搭建稳定的开发环境、跑通第一个完整项目——这三件事,将决定你在 FPGA+AI 推理浪潮中能走多远。
立即行动:访问 UltraLAB 官网获取 FPGA 开发定制化配置方案,或前往 Xilinx GitHub 下载 Vitis AI 官方例程,开启你的 FPGA+AI 推理之旅。UltraLAB 全系列支持远程测试,可先体验后决策。
本文基于硬件阿杰「硬件全栈笔记」系列文章整理,首发于 2026 年 8 月。
关键词:FPGA, AI 推理, 大模型, 本地部署, Vitis AI, Vivado, UltraLAB, 边缘计算, 硬件加速, 模型量化, 推理引擎, Zynq, Versal, 自动驾驶, 工业视觉, 智能安防, A350, GR450P, AE450, GX660M


