






摘要:Spark 是科研数据分析与工程数据处理的事实标准之一,其性能高度依赖内存划分、Shuffle 与垃圾回收行为。本文基于官方调优文档解析 executor 内存、核数与存储的配置逻辑,给出从单机开发到小型分布式分析平台的 UltraLAB 硬件建议。
适用读者:数据工程师、需要处理 TB 级实验/仿真数据的科研团队、BI 与特征工程平台运维人员。
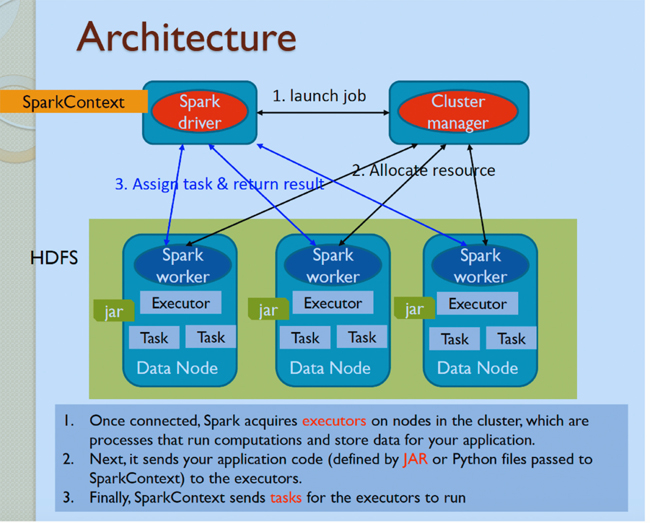
一、资料背景与核心观点
- 资料名称:Apache Spark 官方文档 Tuning Spark 与 Spark Configuration。
- 原文链接:https://spark.apache.org/docs/latest/tuning.html、https://spark.apache.org/docs/latest/configuration.html。
核心观点:Spark 性能问题的根源多在数据序列化、内存管理与 Shuffle三处:官方建议优先使用 Kryo 序列化、通过 spark.memory.fraction 等参数调节执行内存与存储内存的划分、避免大对象导致的 GC 停顿,并以 2—3 个任务/CPU 核的并行度为起点调优。硬件层面,Spark 是典型"内存容量 + 内存带宽 + 磁盘 I/O"三重敏感型负载。
二、主要功能模块与核心算法
- 执行引擎:DAG 调度、Stage 划分、基于 Catalyst 的 SQL 优化与 Tungsten 堆外内存执行。
-
内存模型:统一内存管理——执行内存(Shuffle/Join/聚合)与存储内存(缓存)共享总池,由
spark.memory.fraction(默认 0.6)控制占比。 - Shuffle:宽依赖触发的全量数据重分区,是网络与磁盘 I/O 的最大来源。
-
缓存机制:
cache()/persist()将中间结果驻留内存或溢写磁盘,容量不足时触发重算或溢写。 - 数据格式生态:Parquet/ORC 列式存储 + 向量化读取,显著降低 I/O 与反序列化开销。
三、计算特点与性能瓶颈
3.1 内存容量与 GC
- 每个 executor 需要同时容纳计算堆、缓存与堆外缓冲区;内存不足表现为频繁溢写(spill)与 Full GC,吞吐骤降。
- 官方实践建议单 executor 核数控制在约 5 核以内以保持 GC 可控,靠增加 executor 数量而非单 executor 规模扩展。
3.2 I/O 与网络
-
Shuffle 读写临时文件对磁盘随机 I/O 敏感,NVMe 与多盘分散
spark.local.dir是低成本高收益手段。 - 分布式部署下 Shuffle 走网络,万兆及以上网卡明显改善大 Shuffle 作业。
3.3 CPU 特征
- 解析、压缩解压(Snappy/Zstd)、序列化为 CPU 密集;高核心数 + 高主频均衡配置优于极端单维配置。
- 向量化引擎(如 Gluten/Comet 等加速器插件)可进一步利用 SIMD,但引入版本适配成本。
四、典型应用场景
- 科研数据 ETL:仿真输出、实验日志、遥感产品的清洗与宽表构建,百 GB—TB 级。
- 交互式分析:Spark SQL + Jupyter/Zeppelin 的探索式分析。
- 特征工程与 ML 流水线:Spark MLlib 或对接 XGBoost 等外部训练。
- 流批一体:Structured Streaming 处理实验设备实时数据流。
五、UltraLAB 硬件配置建议
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/项目盘/数据盘 | 散热/电源/扩展 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门级(单机 local 模式) | 16—24 核 | 128 GB | 不需要 | 1 TB NVMe 系统盘 + 2×2 TB NVMe(local.dir 分盘) | 标准风冷,850—1000 W | 百 GB 级数据开发调试、教学 |
| 主流级(单机大内存/小集群节点) | 32—64 核高内存带宽平台 | 256—512 GB | 不需要(可选 GPU 用于 RAPIDS 试验) | 2 TB NVMe + 2×4 TB NVMe(Shuffle 分散)+ HDD 冷数据 | 高规格风冷,1200—1600 W,万兆网卡 | TB 级 ETL 与交互式分析 |
| 高性能级(分布式节点) | 每节点 32—64 核,3 节点起步 | 每节点 256—512 GB | 可选 RAPIDS GPU 加速节点 | 每节点多 NVMe 分散 Shuffle;共享存储或对象存储对接 | 机架/塔式液冷可选,25 GbE 组网 | 多 TB—PB 级分析平台 |
说明:Spark 官方调优指南强调先调参数(序列化、并行度、内存划分)再加硬件;GPU 加速(RAPIDS)仅对特定 SQL/ETL 算子有效,采购前应核实目标 Spark 版本与插件兼容性,本文不构成加速比承诺。
六、软件清单
| 类别 | 软件 | 必需性 |
|---|---|---|
| 核心引擎 | Apache Spark(Spark SQL、Structured Streaming) | 必需 |
| 运行环境 | JDK 11/17、Python(PySpark)、Hadoop 客户端(按需) | 必需 |
| 存储格式 | Parquet/ORC、Delta Lake/Iceberg(湖仓可选) | 必需/可选 |
| 调度 | 内建 Standalone、YARN 或 Kubernetes | 按需 |
| 交互分析 | Jupyter、Zeppelin、Spark UI | 可选 |
| 加速插件 | RAPIDS(GPU)、Gluten(向量化) | 可选 |
七、常见问题(FAQ)
Q1:单机大内存能否替代集群?
对 TB 级以内、以批处理为主的工作负载,一台 256—512 GB 内存、多 NVMe 的工作站在 local 模式下常优于配置不当的小集群,且免运维;超过单机内存多个数量级或要求高可用时再上集群。
Q2:executor 是不是越大越好?
不是。过大 executor 导致 GC 长时间停顿与 HDFS/本地 I/O 竞争;官方与社区实践倾向每 executor 约 5 核以内、多 executor 横向扩展。
Q3:为什么 Shuffle 盘要分多块?
Shuffle 写是突发高并发随机写,单盘容易打满队列;将 spark.local.dir 指向多块 NVMe 可线性分散压力,成本远低于升级 CPU。
Q4:数据倾斜怎么从硬件侧缓解?
硬件只能缓解不能根治:更大内存可容忍更宽的倾斜分区,更快磁盘降低 spill 代价;根治仍需 key 加盐、广播小表等作业级改造。
八、总结与选型建议
Spark 选型主线是"内存容量与 Shuffle I/O 优先,核心数与主频均衡,GPU 非常规必需"。开发调试选 128 GB 内存 + 双 NVMe;TB 级分析选 256—512 GB + 多 NVMe + 万兆;分布式平台按"每节点 32—64 核/256 GB+"线性扩展。务必先完成官方调优清单(Kryo、并行度、内存划分),再评估硬件升级。
边界声明:官方文档参数默认值随 Spark 版本演进可能调整,请以所部署版本文档为准。
参考来源
- Apache Spark. Tuning Spark. https://spark.apache.org/docs/latest/tuning.html
- Apache Spark. Spark Configuration. https://spark.apache.org/docs/latest/configuration.html
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



