






"上报78亿,实际到账不足1亿"——这不是简单的统计误差,而是系统性的数据造假。
当河南省舞阳县的招商引资数据被曝光时,公众震惊的不仅是77亿的巨大差额,更是这种造假在层层监管中畅行无阻的现实。基层"无奈"的辩解背后,暴露的是传统监管手段的力不从心:人工核查跟不上海量数据,事后审计追不上实时造假,而"唯数字论"的考核体系又成了造假的推手。
技术能否成为破解困局的钥匙?答案是肯定的。从金融反欺诈到电商刷单识别,大数据与AI已经在无数领域证明了其识别异常的火眼金睛。将这套"数字探照灯"照向政府统计领域,同样可以实现从"事后追责"到"实时预警"的范式转变。
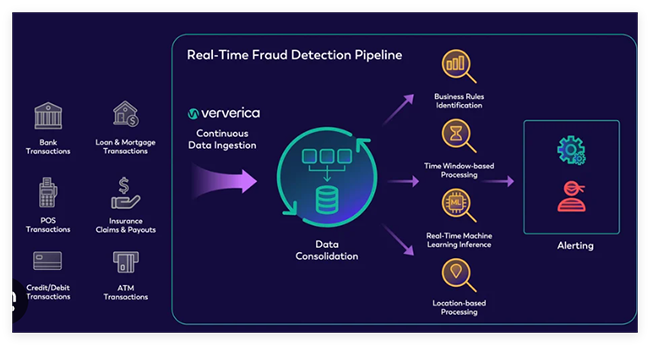
关键数据维度:构建造假识别的"数据指纹"
实时监测系统的第一步是建立多维数据画像,通过交叉验证发现逻辑矛盾:
1. 资金流数据(核心验证)
| 数据类型 | 来源 | 造假识别逻辑 |
|---|---|---|
| 银行到账流水 | 人民银行支付系统 | 真金白银的到账记录 vs 统计上报金额,差异>10%即触发预警 |
| 企业账户异动 | 商业银行API对接 | 识别"当日进当日出"的过桥资金、关联方循环转账 |
| 税务开票数据 | 金税系统 | 投资到位应伴随设备采购/工程款发票,无票则有虚增嫌疑 |
2. 项目关联数据(行为验证)
-
工商注册变更:实收资本变更记录 vs 上报投资额(郑州管城区案例:海南公司注册资本仅1000万,如何投资9.6亿?)
-
土地招拍挂:重大项目投资应有相应的土地购置记录(投资额/亩均投资强度)
-
招投标信息:政府采购网、公共资源交易中心的项目启动记录
-
用工与社保:投资落地应带来用工需求(社保新增人数 vs 项目规模匹配度)
3. 时序特征数据(模式识别)
-
上报节奏异常:月底/季末/年末集中上报(冲刺考核特征)
-
金额取整规律:真实投资多为非整数(如9860万),造假倾向整数(如10亿、5亿)
-
同比增长失真:在基期虚高的情况下仍要求"同比增长",导致数据呈现不合理的线性递增
4. 关联网络数据(团伙识别)
-
投资企业图谱:同一批"投资企业"在多个区县重复出现(空壳公司循环投资)
-
人员关联网络:项目联系人、财务负责人与政府部门人员的关联关系
-
地理分布异常:外地投资企业注册地集中在税收洼地或虚拟地址
核心算法:从统计异常到智能预警
1. 异常检测算法(Anomaly Detection)
孤立森林(Isolation Forest)
-
原理:基于随机分割树,识别与其他数据点"隔离"的异常样本
-
应用:发现上报金额与行业均值、历史趋势严重偏离的案例
-
案例:舞阳县某月上报数据突然从月均5亿跳升至20亿,孤立分数异常
局部异常因子(LOF)
-
原理:比较样本点周围密度与邻居密度,识别局部异常
-
应用:在同类区县中发现"鹤立鸡群"的高额投资数据
2. 关联规则与图谱挖掘
知识图谱嵌入(Knowledge Graph Embedding)
plain
节点类型:区县、企业、项目、人员、银行账户
边关系:投资、控股、任职、交易、关联

造假模式识别:
- 路径:区县A ←投资← 企业X →控股→ 企业Y →投资→ 区县B
  (同一资金在A、B两区县重复计算)
- 环状:企业X →投资→ 企业Y →投资→ 企业Z →投资→ 企业X
  (循环投资,无真实资金流入)
PageRank变体(资金影响力算法)
-
识别"关键少数"的过桥资金账户,这些账户在多个投资项目中充当中转站
3. 时序分析与预测模型
Prophet(Facebook时间序列工具)
-
建立各区县投资额的正常波动区间(考虑季节性、节假日、政策周期)
-
实际值超出预测区间±3σ时触发预警
LSTM长短期记忆网络
-
捕捉投资额与宏观经济指标(PMI、社融规模、行业景气度)的动态关系
-
当地方数据与全国趋势背离时标记异常
4. 自然语言处理(NLP)
项目描述文本分析
-
使用BERT模型分析项目申报材料
-
造假特征词识别:"意向投资""框架协议""分期到位"(模糊表述)vs "设备已进场""厂房已封顶"(实质进展)
-
文档相似度检测:同一项目文本在多个区县重复申报(文本指纹比对)
5. 数字指纹识别
本福特定律(Benford's Law)检测
-
真实数据的首位数字分布应符合对数规律(1出现概率30.1%,9仅4.6%)
-
造假数据常呈现均匀分布或人为偏好(如喜欢以8、9开头)
-
应用:快速筛查报表中金额字段的自然性
硬件配置推荐:实时监测系统的算力底座
发现造假需要处理海量异构数据(银行流水、工商、税务、招投标),硬件架构需支持高并发实时流处理与复杂图算法:
1. 数据采集层(边缘/网关)
| 组件 | 配置 | 功能 |
|---|---|---|
| Kafka集群 | 3节点×16核×64GB内存 | 实时接收各委办局数据流,峰值吞吐量>100万条/秒 |
| Flume/Logstash | 8核×32GB×10G网卡 | 日志收集与初步清洗,识别格式错误 |
2. 实时计算层(流处理)
| 组件 | 配置 | 功能 |
|---|---|---|
| Flink集群 | 10节点×32核×256GB内存 | 实时关联分析(如到账流水与上报数据分钟级比对) |
| Redis | 主从+哨兵,256GB内存 | 热点数据缓存(企业画像、近期交易记录) |
| GPU推理节点 | NVIDIA A100×4 | BERT文本分析、GraphSAGE图神经网络实时推理 |
3. 离线挖掘层(批量分析)
| 组件 | 配置 | 功能 |
|---|---|---|
| Spark集群 | 20节点×64核×512GB内存 | 历史数据回溯、全量图谱构建 |
| 图数据库 | Neo4j集群或TigerGraph | 存储百亿级节点(企业、人员、账户)的关系网络 |
| 时序数据库 | TDengine或InfluxDB | 存储3年以上的投资时序数据,支持降采样查询 |
4. 存储与灾备
-
数据湖:HDFS/S3存储原始凭证影像(PDF、扫描件),容量>10PB
-
合规存储:WORM(一次写入多次读取)介质存储关键证据链,满足审计要求
5. 预警终端(可视化)
-
指挥大屏:LED拼接屏,实时展示全省投资热力图、异常预警分布
-
移动终端:政务APP推送预警给巡查人员,支持现场拍照取证上传
系统架构:从"事后审计"到"实时拦截"
分钟级预警流程
plain
T+0(数据上报瞬间)
    ↓
Kafka接收区县上报数据
    ↓
Flink实时规则引擎校验:
  - 金额是否超过该区县历史均值300%?
  - 企业注册资本是否<上报金额的1%?(郑州管城区9.6亿/1000万=96倍,触发预警)
  - 该企业30天内是否在别的区县有投资记录?(识别循环投资)
    ↓
异常分数>阈值 → 实时短信/钉钉通知监管部门
    ↓
T+1(次日)
Spark离线复核:
  - 关联银行流水(T+1日银行数据到位)
  - 比对税务、工商、土地数据
  - 生成《数据可信度评估报告》
    ↓
T+7(周度)
GraphSAGE深度挖掘:
  - 识别跨区域、跨部门的团伙造假网络
  - 生成线索移交纪委监委
关键技术细节
流批一体架构
-
使用Apache Flink的流批一体特性,同一套SQL代码既支持实时预警又支持离线分析
-
避免Lambda架构的双系统维护成本
隐私计算
-
银行流水属于敏感数据,使用联邦学习或多方安全计算(MPC)
-
各部门数据"可用不可见",仅输出异常评分而非原始明细
区块链存证
-
预警记录、核查过程上链(Hyperledger Fabric)
-
防止"发现预警后人为删除"的二次造假
实施建议:技术之外的关键
1. 数据共享的体制突破
河南事件暴露的最大问题不是技术 inability,而是数据孤岛。银行、税务、工商、商务部门数据分属不同系统,缺乏共享机制。
技术解决方案:建立省级"招商引资数据中台",通过API网关统一接入,使用隐私计算技术解决"不敢共享"的顾虑。
2. 考核指标的重新设计
"上级只看数字增长"是造假的根本动力。技术系统应支持多维考核:
-
不仅看"到位资金",更看"实缴资本变更率""设备进场率""用工增长率"
-
引入"数据健康度"指标,对频繁触发预警的区县降低考核权重
3. 人机协同的核查机制
AI预警≠自动定罪。系统应输出可解释的疑点:
-
"该企业注册资本仅为上报投资额的0.1%,建议核实"
-
"该笔资金在3个关联账户间循环转账,疑似过桥资金"
-
"项目文本与XX县2023年申报项目相似度95%,疑似重复申报"
为现场核查人员提供精准线索,而非淹没在数据海洋中。
结语:让数据在阳光下运行
河南78亿造假案不是技术的失败,而是缺乏技术赋能的监管的必然。当造假者使用Excel手动编造数据时,监管部门也在用Excel手动核对——这是一场不对等的战争。
构建实时监测系统的目的,不是用技术替代人,而是用技术武装人:
-
让每一笔异常资金在到账瞬间就被标记
-
让每一个空壳公司在注册时就进入监控视野
-
让每一次重复申报在提交时就触发拦截
当"数字探照灯"亮起,数据造假将无处遁形。这不仅是对统计造假者的震慑,更是对踏实干事者的保护——毕竟,没有人愿意在"唯数字论"的畸形考核中,被迫成为下一个"无奈的舞阳县"。
(本文技术方案基于RegTech监管科技、金融反欺诈系统最佳实践及政府大数据平台建设经验整理)
UltraLAB图形工作站供货商:
咨询微信号:100369800
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800



