






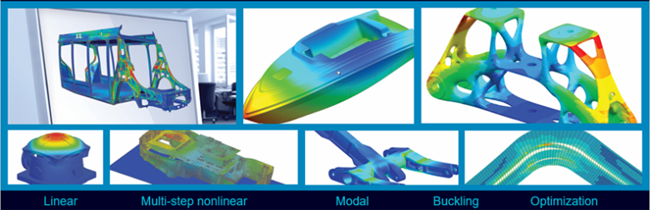
图 1:结构仿真优化的完整工程闭环——从仿真分析到正向优化落地
引言:只会"验算"是仿真员,会"优化"才是仿真工程师
在机械结构动力学仿真领域,绝大多数工程师已经掌握了模态、振动、谐响应、隐式/显式冲击、刚体/刚柔耦合、疲劳、随机振动、试验对标这一套完整的"验算"能力。
但仿真的终极工程价值从来不是验算现有结构,而是——正向优化、改掉缺陷、减重提刚、解决异响、解决开裂、降本增效。
所有结构失效、振动偏大、应力集中、刚度不足,本质只有四类问题:结构形态不合理、壁厚不匹配、圆角筋位缺失、安装约束刚度差。
本文以"仿真分析 → 问题定位 → 结构优化 → 落地量产"完整闭环为主线,系统拆解三大主流优化手段的核心算法原理与计算特点,并给出对应的 UltraLAB 工作站硬件配置选型方案、软件清单、大模型本地部署指南与常见问题硬件分析。
一、三大工业主流结构优化体系:核心算法拆解
图 2:拓扑优化(改形态)、尺寸参数优化(改参数)、形貌优化(改细节)对比1.1 拓扑优化(Topology Optimization)—— 改形态
算法本质:在给定设计域、载荷与约束条件下,通过 SIMP(固体各向同性材料惩罚法) 或 Level-Set(水平集) 方法,将材料密度/几何边界作为设计变量,以柔度最小(刚度最大)或指定固有频率为目标函数,迭代重分配材料,找到最优传力路径。
数学模型(SIMP 法):
min C(x) = FᵀU,s.t. K(x)U = F,V(x) ≤ V₀·f,0 ≤ x_e ≤ 1
其中 x_e 为单元相对密度,惩罚因子 p≈3 使中间密度趋向 0/1。
适用场景:全新设计、毛坯布局、支架形态、腔体结构、底座框架。
核心价值:从零生成最优结构,推翻老旧经验设计。
计算特点:
- 每一轮迭代都需完成一次完整的有限元求解(相当于 30~200 次常规分析)
- 对内存容量与带宽极度敏感,百万自由度以上模型对硬件要求陡增
- 需要长时间高负载稳定运行,对散热与供电冗余要求极高
1.2 尺寸参数优化(Sizing / Parameter Optimization)—— 改参数
算法本质:以壁厚、筋厚、孔径、倒角、梁截面参数为设计变量,采用 DOE(试验设计)+ 响应面法(RSM)/ NSGA-II 多目标遗传算法,在强度、刚度、模态、重量、成本多约束下搜索 Pareto 最优解集。
适用场景:成熟结构迭代、量产优化、减重降本、频率微调。
核心价值:量产项目使用频率最高、落地最快的优化方式。
计算特点:
- DOE 采样产生几十至数百个设计点,天然高度并行
- 每个设计点是一次独立求解,多核 CPU 并行效率极高
- 适合"多进程 × 中大规模模型"的算力模式
1.3 形状/形貌优化(Shape / Topography Optimization)—— 改细节
算法本质:以节点坐标或板筋起筋高度为设计变量,通过 形状灵敏度分析 + 移动渐近线法(MMA)/ 梯度优化,修正局部应力集中、曲面形态与凹凸筋布局。
适用场景:局部开裂、圆角应力超标、薄板共振抖动问题。
计算特点:
- 需反复计算应力/频率灵敏度,伴随方程求解开销大
- 对单核浮点性能与内存延迟敏感,高主频 CPU 收益明显
1.4 工程三大优化目标与约束原则(永远不变)
| 优化目标 | 校核标准 | 失效模式 | 典型手段 |
|---|---|---|---|
| 强度目标 | 最大应力 < 许用应力 | 断裂、开裂 | 加厚过渡、力路径补直、消除尖角 |
| 刚度目标 | 变形位移可控 | 抖动、异响、挠度超标 | 增加支撑跨距、布置纵横筋 |
| 动态目标 | 固有频率避共振、幅值压低 | 共振异响、疲劳断裂 | 缩短悬臂、优化安装点、降交变应力幅 |
经典约束原则:减重必须刚度优先、疲劳优先;提刚必须避免质量堆叠、成本暴涨;调频必须不牺牲强度、不改动装配接口。
二、动力学仿真的计算特点:为什么你的工作站总在"不对劲"
图 3:隐式 vs 显式求解的计算特征对比2.1 隐式求解(Implicit)—— 静强度 / 模态 / 谐响应 / 低速冲击
计算特征:每一载荷步/每一阶模态都需要求解一次大型稀疏线性方程组(K·U = F),采用 稀疏直接求解器(多波前/超节点法) 或 迭代求解器(PCG)。
硬件需求画像:
- 内存容量是第一瓶颈:百万自由度模型建议 128GB 起步,千万自由度 256GB+
- 内存带宽决定直接求解速度:8 通道 DDR5 显著优于 4 通道
- 高主频(≥5GHz 睿频)显著缩短矩阵分解时间
2.2 显式求解(Explicit)—— 高速冲击 / 断裂 / 跌落 / 接触碰撞
计算特征:中心差分时间积分,单步成本极低但时间步长极小(微秒级),总步数可达百万级;无需求解大型方程组,核心运算是单元内力并行集成。
硬件需求画像:
- 吃核大户:32~128 物理核心可线性扩展
- 内存带宽与核数同步扩展,否则核心"挨饿"
- 本地 NVMe 高速存储决定中间结果与重启动文件的写入效率
2.3 疲劳与随机振动(Fatigue / Random Vibration)
计算特征:频域法(PSD)需模态叠加 + 雨流计数 + 损伤累积(Miner 准则),计算量大但模型独立,天然并行;时域法(nCode)海量载荷通道循环处理。
硬件需求画像:大内存 + 多核并行 + 大容量高速 NVMe(载荷谱文件动辄数十 GB)。
2.4 刚柔耦合多体动力学(Rigid-Flexible Coupling)
计算特征:刚体运动(多体)+ 柔性体模态叠加/有限元耦合,单核性能 + 内存延迟敏感;积分步长小,长时间工况仿真耗时长。
2.5 三大优化算法的算力消耗对比总表
| 分析/优化类型 | 求解器特征 | 核心瓶颈 | CPU 需求 | 内存需求 | 存储需求 |
|---|---|---|---|---|---|
| 拓扑优化 | 多次完整 FE 迭代 | 内存容量+带宽 | 32~64 核 | 128~512GB | NVMe 1TB+ |
| 尺寸参数优化(DOE) | 数百设计点并行 | 并行吞吐 | 64~128 核 | 256GB+ | NVMe 2TB+ |
| 形貌优化 | 灵敏度+迭代求解 | 单核主频+延迟 | 高主频 24~32 核 | 128~256GB | NVMe 1TB+ |
| 隐式静力/模态 | 稀疏直接求解 | 内存带宽 | 高主频 32 核 | 256GB+ | NVMe 1TB+ |
| 显式冲击/碰撞 | 海量小步长并行 | 核数+带宽 | 64~128 核 | 128~256GB | NVMe 2TB+(重启动) |
| 疲劳/随机振动 | 频域叠加+循环计数 | 并行+IO | 32~64 核 | 128~256GB | NVMe 大容量 |
三、UltraLAB 硬件配置怎么选:五档工程化方案
图 4:UltraLAB 仿真工作站五档分级配置方案选型三原则
- 先定求解器类型,再定硬件:隐式重主频+内存带宽,显式重核数,GPU 求解与大模型重显存。
- 内存按自由度预算:每 100 万自由度预留 16~32GB 内存,优化类任务直接翻倍。
- 为并行留余量:DOE/多设计点任务优先核数,单模型任务优先主频。
五档配置速查表
| 档位 | 定位 | CPU | 内存 | GPU | 存储 | 适合任务 |
|---|---|---|---|---|---|---|
| ULA-入门版 | 个人工程师 | 16 核 高主频(≥5.0GHz) | 128GB DDR5 8通道 | RTX 5070 12GB | 2TB NVMe | 静强度、模态、小型参数优化 |
| ULA-进阶版 | 资深仿真工程师 | 32 核 高主频(≥4.8GHz) | 256GB DDR5 8通道 | RTX 5080 16GB | 4TB NVMe | 拓扑优化、中型显式、疲劳 |
| ULA-专业版 | 项目组主力 | 64 核(双路/单路高带宽) | 512GB DDR5 8/12通道 | RTX 5090 32GB | 8TB NVMe RAID0 | 大规模拓扑、DOE 批量、刚柔耦合 |
| ULA-旗舰版 | 仿真中心节点 | 96~128 核 | 512GB~1TB | RTX 6000 Ada 48GB ×1~2 | 15TB NVMe RAID | 整车碰撞级显式、千万自由度隐式 |
| ULA-AI 融合版 | 仿真+本地大模型 | 32~64 核 | 512GB | RTX 5090 32GB ×2 或 6000 Ada 48GB ×2 | 8TB NVMe | 仿真计算 + 本地 LLM 工程助手 |
关键组件选型要点
- CPU:优先 AMD Threadripper PRO / EPYC(8~12 通道内存带宽)或 Intel Xeon W;隐式为主选高主频型号,显式为主选高核数型号。
- 内存:DDR5 ECC RDIMM,8 通道起步;拓扑优化与大规模直接求解务必拉满带宽。
- GPU:CUDA 显存 ≥16GB 起步;GPU 加速求解(Abaqus/Standard、ANSYS)与本地大模型推理共用,直接上 32GB+ 显存。
- 存储:系统盘 NVMe 1TB + 数据盘 NVMe 4~8TB(PCIe 4.0/5.0),显式重启动与载荷谱文件 IO 密集,RAID0 可翻倍吞吐。
- 散热与电源:长时间 100% 负载的拓扑/显式仿真,必须 360 水冷 + 1200W+ 冗余电源,否则降频 = 白花钱。
四、软件清单:一套闭环的全栈工具链
4.1 求解器与前后处理
| 环节 | 代表软件 | 计算特点 | 硬件侧重 |
|---|---|---|---|
| 通用隐式/显式 | Abaqus/Standard & Explicit | 直接/迭代求解,混合负载 | 主频+内存带宽 |
| 多物理场 | ANSYS Mechanical / LS-DYNA | 隐式+显式全覆盖 | 均衡型高配置 |
| 结构优化专用 | Altair HyperWorks / OptiStruct | 拓扑/尺寸/形貌三合一 | 大内存+高带宽 |
| 多体动力学 | MSC Adams、RecurDyn | 刚柔耦合、接触 | 高主频 |
| 疲劳分析 | nCode、FE-Safe、Simcenter | 频域/时域循环 | 并行+IO |
| 前后处理 | HyperMesh、ANSA、SpaceClaim | 网格划分交互 | 高主频+大内存 |
| 随机振动/试验对标 | Simcenter 3D、Test.Lab | 频响函数、模态对标 | 均衡配置 |
4.2 自主可控与脚本工具链
- Python(NumPy/SciPy/pandas):结果后处理、DOE 自动化、报告生成
- MATLAB:信号处理、载荷谱分析、控制-结构耦合
- ParaView / PyVista:大规模结果可视化
- Git + 仿真数据管理:版本化模型与结果文件
4.3 大模型本地部署:仿真工程师的"第二大脑"
图 5:本地大模型辅助工程仿真的部署架构本地部署大模型(DeepSeek、Qwen、Code Llama 等)正成为仿真团队的新标配:写 UMAT/VUMAT 子程序、读求解器报错、生成 Python 后处理脚本、沉淀企业仿真知识库——数据不出内网,工程师不泄密。
推荐部署方案(ULA-AI 融合版):
| 组件 | 推荐方案 | 说明 |
|---|---|---|
| 推理框架 | Ollama / vLLM / LM Studio | vLLM 高并发,Ollama 开箱即用 |
| 模型规模 | 32B~70B 参数(Q4 量化) | 单卡 32GB 显存跑 32B;双卡跑 70B |
| 显存预算 | 参数×2 Bytes(FP16)或 ×0.5(INT4) | 70B INT4 约需 40GB 显存 |
| 知识库 | RAG:AnythingLLM / Dify + 本地向量库 | 注入企业历史仿真案例 |
| 与仿真协同 | LLM 生成脚本 → 工作站执行 → 结果回读 | 人机闭环迭代优化 |
五、应用场景:三类典型客户的落地画像
| 客户画像 | 典型任务 | 对应优化体系 | 推荐配置 |
|---|---|---|---|
| 汽车零部件供应商 | 支架拓扑减重、壳体异响调频、疲劳开裂 | 拓扑+尺寸+形貌全栈 | ULA-进阶版 / 专业版 |
| 工程机械主机厂 | 低速冲击(隐式)、工作装置刚柔耦合、焊缝疲劳 | 隐式+刚柔耦合+疲劳 | ULA-专业版(高主频+大内存) |
| 新能源/轨交企业 | 跌落碰撞(显式)、随机振动、试验对标 | 显式+随机振动+对标 | ULA-旗舰版(多核+高速IO) |
统一诉求:仿真不是终点——能算、能改、能量产,才算闭环。
六、常见问题:硬件配置深度分析(FAQ)
Q1:我的拓扑优化跑到 80% 就内存爆掉,是软件问题吗?
不是。拓扑优化 = 几十次完整有限元求解的叠加,百万自由度模型建议内存直接 256GB 起步。若使用 SIMP 法配合过滤半径,内存占用还会上浮 20%~30%。这是典型"该升级硬件而非换软件"的场景。
Q2:显式碰撞仿真 128 核是不是比 64 核快一倍?
接近,但有两个前提:一是内存带宽同步翻倍,否则核多带宽少,核心等数据;二是模型规模足够大(单元数 ≥ 千万级),小模型并行效率会饱和。ULA-旗舰版 12 通道内存就是为满血 128 核设计的。
Q3:GPU 能加速所有结构仿真吗?
不能。只有求解器明确支持 GPU 的功能模块(如 Abaqus/Standard 的直接求解器部分加速、ANSYS 的 GPU 加速、LS-DYNA 部分求解器)才能受益。隐式求解的 GPU 加速目前主要吃显存带宽与容量。买 GPU 之前先查所用版本的官方 GPU 支持清单。
Q4:做尺寸参数优化(DOE),堆核还是堆内存?
堆核优先,内存保底。DOE 是独立设计点并行,64~128 核能把 200 个设计点的周期从两周压到两天;但每个设计点的模型规模决定单任务内存,按"最大模型需求 × 同时并发数"规划总内存。
Q5:本地部署 70B 大模型 + 仿真计算能共用一台机器吗?
完全可以,这正是 ULA-AI 融合版的设计初衷。双 RTX 5090/6000 Ada 方案白天跑 LLM 推理(写脚本、查报错),夜间切换跑仿真批处理;vLLM 的 Continuous Batching 能让 GPU 在仿真 IO 间隙持续服务。注意电源冗余与散热余量。
Q6:NVMe 用 TLC 还是 QLC?要不要 RAID?
求解中间文件、显式重启动、d3plot 类结果文件都是持续大文件写入场景:系统盘用 TLC,数据盘大容量 QLC 亦可;多盘 RAID0 能翻倍写入带宽,但必须配自动备份策略——仿真结果丢一次,一周白算。
Q7:笔记本能做结构优化吗?
能做"建模与轻量验算",做不了量产级优化。拓扑优化的长时间高负载会触发笔记本降频,且内存封顶 64~96GB,遇到百万自由度直接无解。移动场景建议远程桌面连回 ULA 工作站。
结语:真正的仿真能力——懂原理、会建模、能对标、可优化、敢落地
- 不会仿真:凭经验瞎改;
- 普通仿真:验算已有问题;
- 高阶仿真:提前预测、正向优化、解决疑难故障。
三套体系(拓扑改形态、尺寸改参数、形貌改细节)+ 全套动力学验算能力(模态、冲击、刚柔耦合、疲劳)+ 一台算力匹配的 UltraLAB 工作站 + 一个本地 AI 工程助手——这就是仿真工程师从"验算员"进化为"正向设计者"的完整闭环。
更多 UltraLAB 仿真工作站配置方案与实测数据,欢迎联系 UltraLAB 仿真算力实验室获取一对一选型建议。
© 2026 UltraLAB 仿真算力实验室 | 本文基于结构动力学仿真工程实践整理,硬件参数以实际配置为准。


