






一、引言:AI 正在重写科研范式
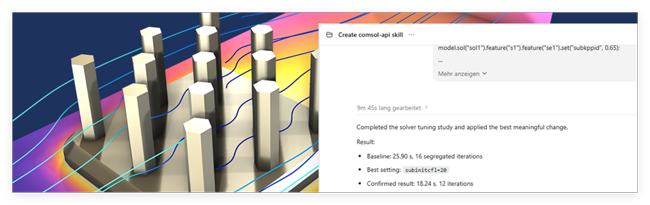
在近期的科研前沿探索中,一个令人瞩目的现象正在发生:有研究人员利用 Codex 等 AI 自动化代理工具,成功将 COMSOL 多物理场仿真改造为一条高效的“SCI 论文生产线”。这不再是科幻小说中的场景,而是正在实验室里真实上演的科研范式革命。传统的多物理场仿真往往伴随着漫长的试错周期。科研人员需要手动构思 idea、搭建几何模型、划分网格、设置边界条件,然后等待数小时甚至数天的计算结果。如果结果不理想,又得从头调整参数。而如今,借助 AI Agent,这一全流程正在被重塑:从文献挖掘与 idea 生成,到模型代码的自动编写与参数迭代计算,再到后处理出图与数据整理,AI 能够自主完成大部分重复性与探索性工作。科研人员只需在关键节点进行审核与决策,即可实现研究效率的指数级跃升。
然而,当我们将 COMSOL 仿真与生成式 AI、强化学习等前沿算法深度融合时,一个核心问题随之浮出水面:这样的 AI+仿真工作流,对底层硬件提出了怎样的要求?传统的单台工作站是否还能支撑这种高并发、大显存、高带宽的混合计算需求?答案显然是否定的。构建一条真正的“论文生产线”,需要一套从算力到存储都经过精密设计的硬件平台,而 UltraLAB 高性能计算平台正是为此而生。
二、核心算法与计算特点
要理解为何需要高性能硬件,首先需要剖析 COMSOL 多物理场仿真与 AI 结合时,底层运行的核心算法及其计算特征。1. 有限元方法(FEM)
这是 COMSOL 的基石。FEM 将连续的物理场空间离散化为海量单元,最终形成大规模稀疏线性方程组。这一过程是典型的计算密集型任务,对 CPU 的单核主频、多核并行能力以及内存带宽提出了极高要求。当网格规模达到千万级时,内存容量和带宽往往成为第一瓶颈。
2. 贝叶斯优化在仿真参数寻优中,贝叶斯优化通过高斯过程回归建立代理模型,并利用采集函数指导下一轮采样。高斯过程回归的计算复杂度随样本量呈立方级增长,且高度依赖矩阵运算。这一算法对
CPU 单核主频极为敏感,同时需要巨大的内存带宽来支撑数据的频繁读写。
3. 生成式 AI(MatterGen/CDVAE/DiffCSP)
在材料科学与分子设计中,扩散模型、变分自编码器(VAE)等生成式 AI 被广泛用于候选结构的生成。这类模型的训练与推理需要庞大的矩阵乘法运算,是绝对的 GPU 密集型任务。模型参数量越大,对显存容量和显存带宽的要求就越苛刻。
4. 代理模型(Surrogate Model)
为了替代耗时的传统数值求解,研究者常使用 MLP、GNN 或 DNN 来拟合物理规律,实现毫秒级的实时预测。代理模型的训练需要大量高质量的仿真数据作为输入,推理阶段则需要
GPU 提供低延迟的张量计算能力。
5. 多模态大模型推理
在自动化工作流中,大语言模型承担着文献解读、代码生成、结果分析乃至自动化报告撰写的任务。本地部署这些模型需要持续占用大量显存,且在处理长上下文(如整篇论文或复杂代码库)时,显存带宽直接决定了响应速度。
核心算法计算特点总结
算法名称
计算瓶颈
显存需求
内存需求
推荐 GPU 类型
有限元方法(FEM)
CPU 多核并行、内存带宽
低(仅后处理)
极高(64GB-512GB+)
无需高端
GPU,核显即可
贝叶斯优化
CPU 单核主频、内存带宽
低
高(32GB-128GB)
无需高端
GPU
生成式 AI
GPU 张量计算、显存容量
极高(24GB-96GB+)
中高(64GB-256GB)
RTX 5090D /RTX Pro 6000
代理模型
GPU 推理延迟、显存带宽
中高(8GB-24GB)
中(32GB-128GB)
RTX 4090 / RTX5080
多模态大模型
显存容量、显存带宽
极高(24GB-192GB+)
高(64GB-256GB)
RTX 4090 /A100 / H100
针对上述复杂的混合计算需求,UltraLAB 提供了从入门到旗舰的全方位硬件配置方案,确保不同阶段的科研团队都能找到匹配的“论文生产线”底座。
1. 入门原型型(预算 8-12 万)
适合个人研究者或课题组初期探索。单卡 RTX 5080 或 RTX 4090 足以应对轻量级 COMSOL 仿真、代理模型训练以及 7B-14B 规模大模型的本地推理。此配置兼顾了性价比与 AI 算力入门门槛。
2. 专业研发型(预算 16-22 万)
适合成熟课题组的多物理场耦合仿真与中等规模 AI 训练。多卡 RTX 4090 或 RTX 4000 Ada 组合,配合高主频 CPU 与大内存,能够流畅运行贝叶斯优化循环,并支持 32B 级别大模型的本地部署。
3. 高端平台型(预算 30-40 万)
适合追求全自主闭环实验的顶尖团队。4 卡 RTX 5090D 提供接近数据中心级别的 AI 算力,配合 NVLink 互联技术,可本地部署 70B+参数的大模型,同时支撑高分辨率 COMSOL 瞬态仿真与生成式 AI 的联合迭代。
4. 旗舰科研型(预算 50-70 万)适合多实验室联盟或国家级重点项目。搭载 RTX Pro 6000 96GB 专业级显卡,拥有 ECC 显存与更高的稳定性,专为千亿参数模型的微调、超大规模多物理场仿真以及 7x24 小时无人值守的自动化实验设计。
UltraLAB 各档位配置方案详情
机型
CPU
GPU
内存
存储
散热
网络
参考价格
适用场景
入门原型型
AMD Ryzen9 9950X
RTX 5080 16G
128GB
2TB NVME+8TB SATA
360mm一体式水冷
2.5GbE
8-12 万
轻量仿真、小模型推理、原型验证
专业研发型
Intel i9-14900
2x RTX 4090 24G
256GB
4TB NVME+16TB SATA
360mm一体式水冷
10GbE
16-22万
多物理场耦合、中等 AI 训练、 32B 模型
高端平台型
AMD撕裂者7970X
4x RTX 5090D 32G
512GB
8TB NVME+32TB SATA
360mm一体式水冷
25GbE/
30-40万
全自主闭环、大模型部署、高分辨率仿真
旗舰科研型
2*AMD 9654
4x RTX Pro 96G
1TB
16TB NVME+64TB SATA
360mm一体式水冷
100GbE/
50-70
多实验室联盟、千亿参数模型、7x24h 运行
构建 AI+COMSOL 自动化工作流,除了硬件,还需要一套完整的软件栈。以下是 UltraLAB 平台推荐的标准软件生态:
软件类别
核心软件
用途说明
仿真软件
COMSOL Multiphysics,ANSYS, ABAQUS
多物理场建模与数值求解
AI 框架
PyTorch, TensorFlow, JAX,HuggingFace,Transformers
深度学习模型训练与推理
自动化/Agent 工具
Codex, LangChain,AutoGen, LangGraph
任务编排、代码生成、多Agent 协作
数据处理
pandas, NumPy, SciPy,HDF5
仿真数据清洗、转换与高效存储
可视化
Matplotlib, ParaView,Plotly, Dash
论文级图表生成、3D
场可视化、交互式仪表盘
大模型
DeepSeek-R1, Qwen 系列,Llama 系列, MatterGen
本地部署的推理与生成引擎
版本管理
Git, DVC, MLflow
代码、数据与实验追踪管理
UltraLAB 硬件平台已在多个前沿科研场景中验证了其价值,以下是五个典型的应用案例:
1. 自驱动材料合成
在材料科学领域,AI 生成候选材料配方后,需要 COMSOL 进行热力学与动力学验证,再由机器人执行合成与表征。这一闭环优化过程要求硬件同时支撑生成式 AI 的推理、COMSOL 的高通量计算以及实时数据采集。UltraLAB 的高端平台型配置能够确保这一循环在数小时内完成一次迭代。
2. 电池多物理场仿真
锂离子电池的电化学-热-力耦合仿真涉及复杂的偏微分方程求解。结合 AI 寿命预测模型,需要在每次充放电循环仿真后实时更新代理模型。这对内存带宽和 GPU 推理延迟提出了双重挑战,UltraLAB 专业研发型配置凭借高主频 CPU 与多卡 GPU,可将单次循环的仿真-预测时间压缩至分钟级。
3. 光子学逆向设计传统光子器件设计依赖人工经验,迭代次数动辄上千次。利用 GAN 或扩散模型结合
COMSOL 光学模块,AI 可直接生成满足目标光谱响应的结构。这一过程需要 GPU 持续提供高吞吐量的张量计算,UltraLAB 高端平台型的 4 卡 RTX 5090D 可将迭代次数减少 70%,将设计周期从数月缩短至数周。
4. 增材制造工艺优化金属
3D 打印过程中的熔池动力学与残余应力预测需要高精度的瞬态仿真。AI 模型用于实时预测打印缺陷并调整工艺参数。这要求硬件具备极低的推理延迟与高可靠性,UltraLAB 旗舰科研型的 RTX Pro 6000 显卡凭借 ECC 显存与专业驱动,确保了 7x24 小时无人值守打印过程中的仿真-控制闭环稳定运行。
5. 反应器数字孪生化工反应器的数字孪生需要多尺度协同仿真(从分子级到设备级)与实时 AI 监控。海量传感器数据与仿真结果的融合对内存容量与 I/O 带宽提出了极致要求。UltraLAB 旗舰科研型配置的 1TB DDR5 ECC 内存与 NVMe U.2 存储阵列,能够支撑千万级网格的实时数据吞吐与模型更新。
六、大模型本地部署
为什么仿真科研需要本地大模型?在科研场景中,数据隐私、延迟敏感与离线可用是三大核心诉求。未发表的研究 idea、实验数据与专有材料配方绝不能上传至公有云 API;自动化工作流中的 Agent 调用需要毫秒级响应,网络延迟会严重拖慢迭代效率;而实验室网络环境复杂,离线可用的本地模型是保障科研连续性的底线。
不同规模模型的硬件需求
• 7B-14B 模型:单卡 RTX 4090(24GB)即可流畅运行,适合代码补全、文献摘要等轻量任务。
• 32B-70B 模型:需要 A100 40GB/80GB 或 4 卡 RTX 4090 并行推理,适合复杂推理、长文档分析与多 Agent 协作。
• 70B+模型:需要多卡 A100/H100 + NVLink 高速互联,或 UltraLAB 旗舰型的多卡 RTX
Pro 6000 方案,适合千亿参数模型的微调与全自主科研 Agent。
量化技术对显存的优化效果
GPTQ、AWQ 与 FP8 等量化技术可在几乎不损失精度的前提下,将模型显存占用降低
50%-75%。例如,70B 模型的 FP16 版本需要约 140GB 显存,而 AWQ 4bit 量化后仅需约
40GB,使得单卡 RTX 4090 也能运行原本需要多卡的模型。UltraLAB 平台预装了 vLLM 与 llama.cpp 等推理引擎,开箱即用。
本地部署推荐大模型
• DeepSeek-R1 32B:推理能力出众,适合复杂逻辑分析与代码生成。
• Qwen2.5-72B:中文理解与多模态能力均衡,适合文献解读与报告撰写。
• Llama-3-70B:英文生态完善,工具调用与 Agent 协作能力强。
• MatterGen:专为材料科学微调,可直接生成晶体结构与分子构型。
七、常见问题硬件配置分析(FAQ)
1. 做 COMSOL 仿真+AI,CPU 选 AMD 还是 Intel?
COMSOL 求解器对 CPU 的 AVX-512 指令集与内存通道数高度敏感。AMD Threadripper 与
EPYC 系列凭借更多的核心数与 8 通道内存,在大规模稀疏矩阵求解中通常领先 10%-20%。 Intel i9/Xeon 则在单核主频上占优,适合贝叶斯优化等串行任务。建议根据主要工作负载选择,若仿真与 AI 并重,AMD 平台综合性价比更高。
2. 显存不够用怎么办?
首选量化技术(AWQ/GPTQ)降低模型显存占用;
其次启用 CPU/GPU Offload,将部分权重卸载至内存;
最后考虑多卡并行或升级至 RTX Pro 6000 96GB/A100 80GB 等大显存显卡。
UltraLAB 配置方案已针对不同模型规模预留了显存余量。3. 内存选多少合适?
COMSOL 多物理场仿真+AI 工作流,128GB 是起步线,强烈推荐 256GB。当网格规模超过500 万或同时运行多个 AI Agent 时,512GB 甚至 1TB 内存才能避免频繁的磁盘交换。UltraLAB 所有配置均支持内存扩展至 1TB 以上。
4. 需要 ECC 内存吗?
对于 7x24 小时无人值守的自动化实验与大规模仿真,ECC 内存是刚需。它能纠正单 bit 内存错误,避免因内存翻转导致的仿真崩溃或 AI 推理结果异常。UltraLAB 旗舰科研型标配 ECC 内存,专业研发型可选配。
5. 网络带宽对多卡训练影响多大?
多卡 GPU 并行训练或推理时,卡间通信带宽直接决定了扩展效率。PCIe 4.0 x16 单卡带宽约 32GB/s,而 NVLink 可提供 600GB/s 以上的互联带宽。对于 4 卡及以上配置,UltraLAB 高端平台型支持 NVLink 桥接,旗舰型支持 InfiniBand,确保多卡扩展效率达到 90% 以上。
6. 散热怎么选?风冷还是水冷?
多卡 GPU 满载功耗可达 1000W 以上,传统风冷难以应对。UltraLAB 入门与专业型采用一体式水冷,确保 GPU 不降频;高端平台型采用定制分体水冷,兼顾静音与散热;旗舰科研型采用服务器级冗余风冷,专为机房环境与长期稳定性设计。
7. 电源怎么选?
多卡 GPU 峰值功耗波动剧烈,电源需预留 30% 以上余量并具备 80Plus 金牌以上认证。
UltraLAB 所有配置均采用钛金级冗余电源,支持热插拔与过压/过流保护,确保科研数据不因断电丢失。8. 消费级 GPU(RTX 4090)和专业级 GPU(A100/H100/RTX Pro 6000)选哪个?
RTX 4090/5090D 性价比极高,适合 90% 的科研场景,但缺乏 ECC 显存与 NVLink,不适合 7x24h 无人值守与超大规模模型。A100/H100/RTX Pro 6000 拥有 ECC 显存、更高带宽与专业驱动,适合国家级项目、多实验室共享与关键任务。UltraLAB 提供从消费级到专业级的完整选择,帮助科研团队按需投资。
八、总结与建议
AI 正在将 COMSOL 多物理场仿真从“手工作坊”推向“自动化生产线”,而硬件是这条生产线能否落地的决定性因素。根据科研阶段的不同,我们给出以下配置建议:
• 起步阶段:选择 UltraLAB 入门原型型,以最低成本验证 AI+仿真工作流的可行性。
• 成长阶段:升级至专业研发型,支撑多物理场耦合与中等规模 AI 训练,加速论文产出。
• 成熟阶段:部署高端平台型,实现全自主闭环实验与大模型本地化,建立技术壁垒。
• 引领阶段:采用旗舰科研型,支撑千亿参数模型与多实验室协同,定义下一代科研范式。
UltraLAB 高性能计算平台不仅提供硬件,更提供从软件栈预装、大模型部署到工作流优化的端到端解决方案。我们深知,科研工作者最宝贵的资源是时间。选择 UltraLAB,就是选择将时间投入到真正的创新中,而非与硬件配置和软件环境搏斗。让 AI 成为你的科研伙伴,让UltraLAB 成为你的算力基石,共同开启 SCI 论文生产线的新时代。


