






摘要:当光学元件的表面精度进入亚纳米时代,传统光线追迹与单一结构仿真正在失效。有限元分析(FEA)正从"细分工具"进化为光学设计的"基础设施"——从光-热-力多物理场耦合,到超表面的三维拓扑优化,再到 AI 与大模型驱动的智能仿真,一场静默革命正在进行。本文深度解析这场变革背后的核心算法与计算特点,并给出与之精准匹配的 UltraLAB 高性能工作站/服务器选型指南。
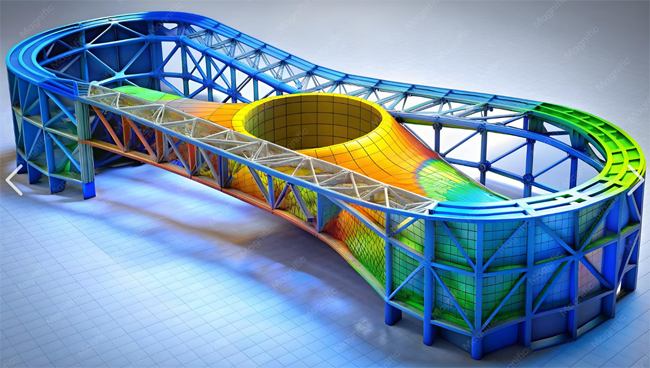
图 1:纳米级光学镜体的有限元应力与形变分析——机械变形在光学系统中即为致命的波前误差
本文目录
- 一、核心内容应用分析:FEA 为何正在"吃掉"光学仿真
- 二、主要核心算法及其计算特点
- 三、从计算负载到硬件需求的映射逻辑
- 四、UltraLAB 硬件配置怎么选:选型法则与四级方案
- 五、软件清单:光学仿真 + 多物理场 + AI 全栈工具链
- 六、应用场景:谁在解决"算不准就完蛋"的真问题
- 七、大模型本地部署:光学仿真的 AI 新范式
- 八、常见问题硬件配置分析(FAQ)
- 九、总结与选型结论
一、核心内容应用分析:FEA 为何正在"吃掉"光学仿真
1.1 一个纳米级难题:机械软件"算不准",光学系统"输不起"
航天遥感、高端医疗成像中的光学元件,表面精度要求已达亚纳米级。镜片在重力下变形几个纳米,机械工程师可以忽略,但在光学系统中,这就是致命的波前误差。更棘手的是多物理场耦合:温度变化让镜片热胀冷缩,装配应力让表面产生形变,而这些机械变形会直接改变光的传播路径。光学与结构,长期是"两张皮",FEA 正在把它们缝合成一件衣服。
1.2 市场信号:单一物理场仿真已经不够用了
| 市场指标 | 数据 | 来源口径 |
|---|---|---|
| 2025 全球光学设计与仿真软件市场规模 | 约 2.45 亿美元 | GlobalInfoResearch |
| 2032 年预测规模 | 接近 4.03 亿美元(CAGR 7.4%) | GlobalInfoResearch |
| 2032 光学仿真软件整体市场(宽口径) | 约 7.5 亿美元(CAGR 9.2%) | QYResearch |
| 增长核心驱动力 | 从单一物理场 → 多物理场耦合、从设计验证 → 全链路优化 | 综合 |
核心判断:当超表面设计需要拓扑优化、光机装调需要纳米级预测、多物理场耦合成为标配时,有限元不再是"可选项",而是一种思维方式。
1.3 三个正在发生的范式转移
- 范式一:支撑结构即光学元件。 研究发现支撑点数量并非越多越好(超过阈值后改善饱和),多点柔性支撑结构已实现 0.33 纳米的面形复现性(《光学学报》2026)——FEA 从"验证工具"变为"设计流程的起点"。
- 范式二:超表面从"设计-试错"走向"拓扑优化"。 JOSA A 2026 年展示的基于 FEM 的 3D 拓扑优化框架,采用密度插值 + 伴随法,处理数万个自由度,自由形态结构实现 62% 平均衍射效率,且与电子束光刻、反应离子刻蚀工艺兼容。
- 范式三:软件巨头的"全链路"战争。 Ansys(Lumerical FDTD/FEM + Zemax + Speos)、COMSOL(多物理场耦合)、JCMsuite(高端 FEM 电磁)、RSoft(拓扑优化器)正在打通"从纳米到系统级"的完整工具链。
二、主要核心算法及其计算特点
2.1 核心算法全景表
| 算法 | 英文全称 | 求解对象 | 典型软件 | 核心计算特点 |
|---|---|---|---|---|
| 有限元法 | FEM (Finite Element Method) | 频域麦克斯韦方程 / 结构力学方程 | Ansys Mechanical、COMSOL、JCMsuite、Lumerical MODE | 网格需细化至波长 1/10 以下;三维问题自由度轻松破百万;稀疏矩阵求解,直接法吃内存、迭代法吃算力 |
| 时域有限差分 | FDTD (Finite-Difference Time-Domain) | 时域麦克斯韦方程 | Ansys Lumerical FDTD、RSoft FullWAVE | 天然并行、GPU 加速收益最大;内存占用与网格数成正比;长时仿真步数巨大 |
| 边界元法 | BEM (Boundary Element Method) | 边界积分方程 | COMSOL、JCMsuite | 网格只在边界,降维优势;矩阵稠密,内存与计算量随边界单元数平方增长 |
| 拓扑优化 | Topology Optimization (SIMP + 伴随法) | 材料密度分布 | RSoft 2026、COMSOL、自研框架 | 数百代迭代 × 每次一次全波/结构求解;伴随法将梯度成本降至 1 次正问题量级;自由度数万级起步 |
| 混合方法 | Hybrid (光线追迹 + FEM + 标量衍射) | 跨尺度光学系统 | Zemax + Mechanical 耦合工作流 | 几何光学处理波前像差、FEM 求解边缘麦克斯韦方程、标量衍射处理自由传播;多软件数据联动 |
| 光线追迹 | Ray Tracing | 几何光学 | Zemax OpticStudio、Code V、LightTools | 计算量小、秒级出结果;对亚波长结构完全失效 |
| AI 代理模型 | PINN / Neural Surrogate | 场分布快速预测 | PyTorch + NVIDIA Modulus | FEM 生成训练数据、神经网络秒级推理;训练吃 GPU、推理吃显存带宽 |
2.2 计算特点深度剖析
(1)精度与成本的永恒博弈
纳米光学器件的全波 FEM 仿真,网格尺寸需到波长的 1/10 以下,三维问题的自由度轻松突破百万级;拓扑优化迭代数百代,即使有伴随法,计算量依然惊人。这是典型的**"内存容量 + 浮点算力 + 存储 I/O"三重密集**负载。
(2)求解器类型决定硬件偏好
-
直接求解器(Direct Solver,如 MUMPS、PARDISO):内存需求 ≈ 自由度 × (20
40) 字节,百万 DOF 对应 2040GB 起步,千万 DOF 即需 512GB 级内存;对内存带宽极其敏感。 - 迭代求解器(Iterative Solver):内存占用低,但依赖高主频 CPU 与 AVX-512 指令集持续高频运行,散热降频会直接拖慢收敛。
- GPU 加速求解:FDTD 与时域算法天然并行,单 GPU 可带来 10~50 倍加速;FEM 频域求解的 GPU 化也在加速(Ansys 2026 R1 已强化 Lumerical FDTD GPU 加速)。
(3)多物理场耦合的"链式放大"
光-热-力耦合不是一次求解,而是"结构形变 → 光学波前 → 热场再分布"的迭代闭环。Ansys Zemax 与 Mechanical 的耦合工作流可模拟基底形变如何改变菲涅尔透镜焦距与波前形状——每一次耦合迭代都是一轮完整 FE 求解,算力需求成倍放大。
(4)对称性与降阶是软件优化方向,硬件仍是底座
利用结构对称性(含非简并情况)可大幅缩减 FEM 计算规模;AI 混合驱动(FEM 出数据、神经网络做推理)可将全波仿真从数小时压缩到可交互时间尺度。但训练数据仍需 FEM 真值,硬件底座决定了 AI 加速的上限。
图 3:FDTD 的典型纳米光子学应用场景——从衍射光栅到超透镜,全部依赖全波电磁求解三、从计算负载到硬件需求的映射逻辑
| 计算负载特征 | 对应硬件诉求 | 推荐规格方向 |
|---|---|---|
| 百万级自由度稀疏矩阵 | 大容量 ECC 内存 + 高内存带宽 |
8 |
| 直接求解器密集访存 | 内存带宽优先于核心数 | 满配内存通道,双路平台优先 |
| 迭代求解器收敛迭代 | 高主频 CPU + 稳定散热 | 4.0GHz+ 全核频率,工业级水冷防降频 |
| FDTD / GPU-FEM | 大显存 + 高带宽 GPU | 24GB~96GB 显存,CUDA 生态 |
| 拓扑优化数百代迭代 | CPU+GPU 异构 + 高速存储 | NVMe Gen5,checkpoint 秒级写入 |
| 多物理场耦合链式求解 | 多核并行 + 大内存池 | 32~96 核,1TB 级内存 |
| AI 代理模型训练/推理 | 显存容量决定模型规模 | 48GB~96GB,多卡 NVLink |
| 网格文件数十~数百 GB | 存储 I/O 不能成为瓶颈 | NVMe Gen5(14GB/s)+ 企业级 HDD 归档 |
四、UltraLAB 硬件配置怎么选:选型法则与四级方案
4.1 选型黄金法则(算法 → 硬件的专业匹配)
UltraLAB 深耕工程仿真多年,针对不同仿真算法提供精细化硬件匹配,而不是简单按"显卡越贵越好"堆料:
- 显存与内存是双底座:全波 FEM 的百万自由度矩阵住内存,FDTD 与 AI 模型住显存——两者都"装不下就直接报错",扩容优先级最高。
- 频率决定单步速度,核心决定并行规模:迭代求解器与网格划分吃主频(4.0GHz+),多物理场参数扫描与 DOE 吃核心数(32~96 核)。
- 内存通道必须满配:直接求解器的性能与内存带宽近似线性相关,8~12 通道 DDR5 满配可带来数倍于同容量低配通道的提升。
- NVMe Gen5 是迭代型仿真的刚需:拓扑优化数百代、checkpoint 频繁读写,Gen5 的 14GB/s 带宽可消除 I/O 瓶颈。
- 散热决定持续性能:7×24 小时满载与游戏瞬时负载完全不同,工业级水冷保障 AVX-512 持续高频不降频。
4.2 UltraLAB 四级配置方案(2026 版)
方案 A:光学设计与轻量仿真工作站(预算 3~6 万)
适合:Zemax/Code V 光学设计、中小规模结构 FEA、科研院所入门、教学科研。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB A350 / AX400 | 超频便携/台式工作站 |
| CPU | Intel Ultra7 265K(20核,全核 5.1GHz)或 18核 4.5GHz 极限超频 | 高主频保障光线追迹与网格划分流畅度 |
| GPU | RTX 5060Ti 16GB / RTX A4000 20GB | 中小规模 FDTD、LightTools 渲染、7B~14B 模型推理 |
| 内存 | 64~128GB DDR5 | 覆盖百万级自由度静力分析 |
| 存储 | 4TB NVMe Gen4 + 8TB HDD | 高速缓存 + 项目归档 |
| 散热 | 360mm 一体式水冷 | 保障长时间求解稳定性 |
方案 B:多物理场耦合专业工作站(预算 8~18 万)
适合:光-热-力耦合仿真、COMSOL 多物理场、超表面单元设计、衍射光学混合仿真。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB GR450P / EA 系列 | 撕裂者超频 / 单路霄龙平台 |
| CPU | AMD 撕裂者 7980X(64核 5.0GHz)或 EPYC 9005 系列 64~96 核 | 多核并行 + 高主频双优 |
| GPU | RTX Pro 5000 48GB / RTX 5090 32GB | 48GB 显存支持 FDTD 大网格与 32B 级模型 |
| 内存 | 192~256GB DDR5 ECC | 光-热-力耦合矩阵常驻内存,避免 Swap 崩溃 |
| 存储 | 4TB NVMe Gen5(14GB/s)+ 16TB HDD | Gen5 消除大规模网格读写瓶颈 |
| 网络 | 万兆以太网 | 团队协作与 license 服务器互联 |
方案 C:全波仿真 + 拓扑优化旗舰工作站(预算 15~30 万)
适合:超表面 3D 拓扑优化、千万级自由度全波 FEM、AI 代理模型训练、70B 级大模型本地部署。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB AE450 / CX390 | 旗舰科研级算力平台 |
| CPU | AMD EPYC 9275F(24核 4.5GHz)或 32核 4.0GHz Xeon 676X | 高主频驱动伴随法敏感度分析 |
| GPU | RTX Pro 6000 96GB(或 96GB 级双卡) | 96GB 单卡显存支撑 FDTD 超大网格、70B 模型 FP16 推理 |
| 内存 | 512GB~768GB DDR5 ECC RDIMM | 拓扑优化 数百代迭代的矩阵 + 训练数据同池管理 |
| 存储 | 8TB NVMe Gen5 + 32TB NVMe 数据盘 | 20GB/s 级读取,checkpoint 秒存 |
| 特色 | NVIDIA Omniverse 实时可视化 | 结构变形与光场分布的实时交互式后处理 |
方案 D:AI+仿真一体化服务器 / 集群(预算 30 万~200 万)
适合:课题组共享、大模型全参数训练、数字孪生实时推演、国家级课题。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB EX660 / GA660M / CT400 集群 | 双路服务器 + 多机集群 |
| CPU | 2× AMD EPYC 9655/9755(192~256 核) | 千万级网格 CFD/FEM 并行求解 |
| GPU | 2~8× RTX Pro 6000 96GB(NVLink 互联)或 8× H100 80GB | 640GB 级显存池,GPT-3 级训练、多用户推理 |
| 内存 | 1~2TB DDR5-4800(24 通道满配) | 仿真网格与 AI 张量统一寻址 |
| 存储 | 30TB NVMe 全闪存阵列 / 100TB Lustre 并行文件系统 | 50GB/s 聚合带宽,多节点共享 scratch |
| 网络 | 100~200Gb InfiniBand(GPUDirect RDMA) | 无损网络,张量并行效率 >95% |
| 散热 | 分体式水冷 + 精密空调 | 满载 8kW 级功耗,温升 <10℃ |
五、软件清单:光学仿真 + 多物理场 + AI 全栈工具链
5.1 光学设计与仿真软件
| 软件 | 厂商 | 核心能力 | 求解特点 | 硬件需求要点 |
|---|---|---|---|---|
| Zemax OpticStudio | Ansys | 宏观光学设计、系统级建模、超透镜仿真 | 光线追迹为主 + 物理光学传播 | 高主频 CPU,单核优化 |
| Lumerical FDTD | Ansys | 纳米光子学全波仿真 | FDTD,GPU 加速最强 | 大显存 GPU + 大内存 |
| Lumerical MODE / CHARGE / HEAT | Ansys | 波导模式、载流子、热仿真 | FEM/有限体积 | 多核 CPU + 内存带宽 |
| Speos | Ansys | 系统级光学验证、杂散光 | 蒙特卡洛光线追迹 | 多核并行 + 专业显卡 |
| COMSOL Multiphysics | COMSOL | 光-热-力-电磁多物理场耦合 | FEM + 边界元 | 大内存 + 高频多核并重 |
| JCMsuite | JCMwave | 高端 FEM 电磁仿真、光刻、光子晶体 | 高精度 FEM + 自适应网格 | 内存容量敏感 |
| RSoft | Synopsys | 光子器件、2026 新增拓扑优化器 | BPM/FDTD/FEM | GPU 加速 + 大内存 |
| Code V / LightTools | Synopsys / 西门子 | 成像设计、照明仿真 | 光线追迹 | 高主频 CPU |
| 自研拓扑优化框架 | 学术界 | 3D 拓扑优化超表面(JOSA A 2026) | SIMP + 伴随法 | CPU+GPU 异构 + 高速存储 |
5.2 结构/多物理场与前后处理
| 软件 | 用途 | 硬件需求要点 |
|---|---|---|
| Ansys Mechanical | 结构静力/模态/热分析(STOP 分析核心) | 大内存直接求解器 |
| Abaqus | 非线性结构分析 | 高主频 + 大内存 |
| HyperMesh / ICEM CFD / Femap | 网格划分与前后处理 | 高主频 CPU + 大内存 + NVMe |
| MATLAB | 算法原型、精度-成本函数建模 | 高频多核 |
5.3 AI 与大模型本地部署工具链
| 工具/框架 | 类型 | 核心用途 | 硬件要求 |
|---|---|---|---|
| Ollama | 推理引擎 | 一键运行 GGUF 模型、本地 AI 助手 | GPU 显存 ≥16GB |
| vLLM | 推理加速 | 高吞吐 LLM 服务、PagedAttention | NVIDIA GPU,显存 ≥24GB |
| PyTorch + Hugging Face | AI 框架 | 模型微调、PINN/代理模型训练 | 显存 ≥24GB,推荐 48~96GB |
| NVIDIA Modulus | 物理 ML 框架 | FNO 流场/场重建、物理约束神经网络 | 大显存 GPU |
| DeepSpeed / FSDP | 训练优化 | 大模型分布式训练、ZeRO 显存优化 | 多 GPU + NVLink |
| TensorRT + ONNX Runtime | 推理加速 | FP8/INT8 量化部署 | NVIDIA GPU |
| LlamaIndex / LangChain | RAG 框架 | 企业知识库、Agent 编排 | 高频多核 CPU + 大内存 |
| Open WebUI | Web 界面 | 类 ChatGPT 多用户管理 | Docker 部署 |
六、应用场景:谁在解决"算不准就完蛋"的真问题
| 应用场景 | 技术方案 | 关键指标/结论 | 硬件压力点 |
|---|---|---|---|
| 纳米级镜面支撑与装调 | FEM 建立"精度-成本函数",多点柔性支撑优化 | 0.33nm 面形复现性(《光学学报》2026) | 结构 FEA 大规模参数扫描 |
| 空间光机 STOP 分析 | Ansys Zemax + Mechanical 自动化耦合工作流 | 模拟基底形变对菲涅尔透镜焦距/波前的改变 | 光-热-力链式迭代求解 |
| 超表面拓扑优化 | FEM + 密度插值 + 伴随法 3D 拓扑优化 | 62% 平均衍射效率,兼容 EBL/RIE 工艺 | 数百代 × 全波求解,CPU+GPU 双重密集 |
| 衍射光学元件边缘散射 | 混合法:几何光学 + FEM 边缘求解 + 标量衍射 | 最佳圆角半径 ≈ 台阶高度的 7% | 跨软件数据联动、多尺度网格 |
| 精密模压成型工艺 | FEM 工艺参数空间搜索低残余应力组合 | 升温速率/模压温度/加压载荷优化 | DOE 多工况并行 |
| 轻量化镜体设计 | 蜂窝结构变形与模态分析 | 三角形蜂窝变形最小,样条形蜂窝减重最优 | 模态分析内存密集 |
| AI 加速仿真 | FEM 数据训练神经网络代理模型 | 全波仿真从数小时 → 可交互秒级 | GPU 训练 + 显存带宽推理 |
| 对称性高效建模 | 利用结构对称性缩减 FEM 规模 | 计算量大幅下降 | 高主频 CPU 收益明显 |
七、大模型本地部署:光学仿真的 AI 新范式
7.1 为什么"AI + FEM"是下一个战场
原文揭示了一个明确信号:物理-数据混合驱动的神经网络已开始用于光学纳米结构的辐射方向图分析——FEM 提供训练数据,神经网络加速推理;Ansys 已在 Zemax 中集成 AI 辅助 Engineering Copilot。对涉密光学项目(航天遥感、医疗成像)而言,本地部署是唯一选择。
7.2 显存是第一生产力:模型权重占用估算
| 模型规模 | FP16/BF16 权重 | INT8 权重 | INT4 权重 | 推荐显存平台 |
|---|---|---|---|---|
| 7B | ≈14 GB | ≈7 GB | ≈4 GB | 16~32 GB |
| 14B | ≈28 GB | ≈14 GB | ≈7 GB | 32 GB |
| 32B | ≈64 GB | ≈32 GB | ≈16 GB | 48~96 GB |
| 70B | ≈140 GB | ≈70 GB | ≈35 GB | 80~96 GB 或多卡 |
| 100B+ | ≈200 GB+ | ≈100 GB+ | ≈50 GB+ | 多 GPU 服务器 |
关键提示:量化后"装得下"不等于"跑得快"。长上下文、高并发与多用户场景会显著增加 KV Cache。建议 48GB 为当前甜点配置,96GB 为未来 3~5 年储备。
7.3 光学仿真团队的典型本地部署场景
| 场景 | 模型规模 | UltraLAB 推荐 |
|---|---|---|
| AI 编程助手 / 文献分析 | 7B~14B | 方案 A(RTX 5060Ti 16GB~RTX 5090 32GB) |
| 仿真知识库 RAG / Engineering Copilot | 14B~32B | 方案 B(48GB 显存) |
| 光学设计 Agent / 多模态审查 | 32B~70B | 方案 C(RTX Pro 6000 96GB) |
| PINN/代理模型训练 + LLM 微调 | 全参数/QLoRA | 方案 D(2~8 卡 NVLink) |
八、常见问题硬件配置分析(FAQ)
Q1:光学有限元仿真需要多大内存?
内存 ≈ 自由度 × 每自由度字节数(直接求解器 20~40 字节/DOF)。 百万 DOF 的三维全波模型,矩阵本身即需 20~40GB,加上多物理场耦合的中间场量,256GB 是专业起点,千万 DOF 或多物理场链式求解建议 512GB~1TB ECC。内存不足触发 Swap 时,求解速度会暴跌两个数量级。
Q2:光学仿真更吃 CPU 还是 GPU?
分算法而论:网格划分、直接求解器、多物理场强耦合迭代以高主频多核 CPU 为主(内存带宽优先);FDTD 与 FEM 频域 GPU 化后,单卡可提速 10~50 倍;大模型训练与 AI 代理模型依赖大显存 GPU。结论:高频 CPU + 大显存 GPU 的异构架构,缺一不可。
Q3:拓扑优化为什么要"高频 CPU + 大显存 GPU + 高速存储"三件套?
拓扑优化是数百代迭代 × 每代一次完整正问题求解。伴随法虽将梯度成本压到 1 次正问题量级,但每代求解仍是全量 FEM/FDTD:灵敏度分析吃主频、大网格正问题吃显存与内存、每代 checkpoint 写入吃存储 I/O——三者任一处短板都会让迭代周期从分钟级恶化为小时级。
Q4:48GB 和 32GB 显存怎么选?
预算允许优先 48GB。32GB 适合 7B~14B 模型与中小规模 FDTD;48GB 可覆盖 32B FP16 或 70B INT4,并为 KV Cache 和长上下文留足余量。对"FEA + AI"混合工作流(仿真间隙跑代理模型训练),48GB 是甜点,96GB 是长期储备。
Q5:NVMe Gen5 SSD 真的有必要吗?
绝对有。 全波仿真的网格文件动辄数十 GB,多物理场耦合的 checkpoint 与 AI 训练的数据集读取同样庞大。SATA SSD(500MB/s)加载一个 50GB 模型需 100 秒以上,NVMe Gen5(14GB/s)仅需 4 秒。对拓扑优化、DOE 扫描、多任务队列场景,Gen5 不是升级项,是刚需项。
Q6:大模型本地部署,CPU 重要吗?
重要,但优先级低于 GPU 显存。 CPU 负责 Tokenizer、文档解析、RAG 检索、Embedding 与数据加载。RAG 知识库场景建议高频 16 核起步 + 128GB 内存;企业级多用户平台建议 32 核 + 256~512GB。CPU 不足不会导致模型无法运行,但会成为检索与解析的隐性瓶颈。
Q7:买一张 96GB 还是两张 48GB?
- 单模型推理/超大 FDTD 网格:96GB 单卡更简单,无多卡通信开销;
- 多用户/多模型并行:双 48GB 实现任务隔离(一人跑 70B LLM、一人跑多模态模型、一人跑 FDTD);
- 训练场景:多卡 + DeepSpeed ZeRO / FSDP / 张量并行是扩展显存的刚需。
Q8:工作站和服务器的散热为什么要特别强调?
仿真求解是 7×24 小时持续 AVX-512 满载,与游戏/渲染的瞬时负载完全不同。风冷在持续满载下会触发降频,求解时间可能延长 20~40%。UltraLAB 全系列采用工业级水冷/分体水冷,正是为了让标称频率成为可持续频率。
九、总结与选型结论
245 亿美元(宽口径)的光学仿真市场,FEM 正在从"细分工具"走向"基础设施"。光学工程师的竞争力,正在从"会用 Zemax 跑光线"转向"能定义多物理场耦合问题并用 FEM 求解"。而这场静默革命的算力底座,决定了你的迭代速度——
UltraLAB 选型速查
| 你的需求 | 推荐方案 | 关键配置 |
|---|---|---|
| 光学设计 + 轻量 FEA | 方案 A(3~6 万) | 高频 20 核 + 16~32GB 显存 + 128GB 内存 |
| 光-热-力多物理场耦合 | 方案 B(8~18 万) | 64 核 5.0GHz + 48GB 显存 + 256GB ECC |
| 超表面拓扑优化 / 70B 本地部署 | 方案 C(15~30 万) | 高频霄龙 + RTX Pro 6000 96GB + 512GB ECC + NVMe Gen5 |
| AI+仿真一体化 / 大模型训练 | 方案 D(30 万+) | 双路 EPYC + 2~8 卡 NVLink + 1TB 内存 + 全闪阵列 + IB 网络 |
一步到位的建议:与其在两三年后因内存/显存不足整机报废,不如按"自由度规模 × 模型规模 × 并发数"一次选对。UltraLAB 可根据您的实际模型规模、求解器类型、量化方式与预算,对 CPU、GPU、内存、NVMe、网络、电源及散热进行定制化设计,并提供远程测试验证。
参考文献
- Manufacturable blazed metasurface gratings designed by a 3D topology optimization model, JOSA A, Vol.43, Issue 9, 2026
- Design of Multi-Point Flexible Support for Nanometer-Level Optical Elements, Acta Optica Sinica, 2026
- Automating structural-thermal-optical performance analysis, SPIE Proceedings, 2025
- Combined finite-element and scalar diffraction simulation of light scattering, Applied Optics, 2023
- Ansys 2026 R1 Optics & Photonics Release Notes, CADFEM
- Global Optical Design Software Market Report 2026-2032, GlobalInfoResearch
- 光学仿真软件市场研究报告,QYResearch
- 基于磷酸盐玻璃模压成型工艺的有限元仿真分析,《机械研究与应用》
- A Study on Honeycomb Structures of a Spherical Mirror using Finite Element Analysis, KCI
关于 UltraLAB:UltraLAB(西安坤隆计算机科技有限公司)是国内知名高端定制图形工作站厂家,面向结构力学、流体力学、电磁仿真、光学设计与仿真、人工智能等领域提供"算法→硬件"精准匹配的专业计算平台。
本文基于公开技术资料与行业研究整理,硬件配置参数以 UltraLAB 官方最新方案为准。技术咨询:400-705-6800。


