






导读:2026年3月公开、4月更新至 v3 的论文 Tackling multiphysics problems via finite element-guided physics-informed operator learning(Yamazaki 等,JAX 平台 Folax 实现)给出了一个标志性进展:不依赖预生成标签数据,直接把有限元离散残差作为物理信息损失,训练多物理场神经算子,并在三维工业导向铸造案例中完成验证。论文横向对比了 FNO、DeepONet、iFOL 三类算子,给出了训练策略与四层验证方法论,以及"旁路代理→耦合→子模型替换"的工程落地路线。
这篇论文对铸造、热处理、增材制造企业意味着一件事:AI 仿真代理已经从概念走进工程流程。而要把论文方法变成产线上的生产力,算力底座是绕不开的第一问。本文按真实 CAE 工程流程拆解其计算特点,给出 UltraLAB 硬件选型方法论。
一、技术路线拆解:AI 铸造仿真在算什么
1.1 核心物理问题:热-力耦合多物理场
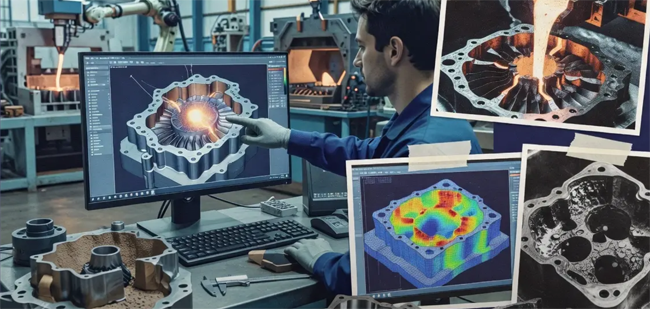
论文求解稳态热-力耦合:热传导方程 ∇·q=0(q=-k(X,T)∇T)与机械平衡 ∇·σ=0 通过热应变 εt=α(T-T₀)I 耦合,且热导率 k 与杨氏模量 E 均随温度变化——温度既是结果又是力学输入,这正是铸造缺陷、热裂纹预测的物理核心。
1.2 与传统路线相比,计算结构发生了什么变化
| 环节 | 传统铸造CAE(ProCAST/FLOW-3D等) | AI神经算子路线(本文方法) |
|---|---|---|
| 物理建模 | 凝固潜热、相变、流动、应力全耦合求解 | 弱形式有限元残差嵌入损失函数,无需标签数据 |
| 单次计算成本 | 数小时~数天(高保真) | 训练:数天~数周;推理:秒级 |
| 几何适配 | 非结构网格天然支持 | iFOL条件神经场支持复杂不规则几何 |
| 工程角色 | 最终签核依据 | 工艺筛选代理 + 高保真复核回退 |
二、每个应用的核心算法与计算特点
2.1 三类神经算子:FNO / DeepONet / iFOL 怎么选
论文在二维规则区域、三维代表体元(RVE)与三维铸造案例上横向对比了三类算子:
| 算子 | 核心机制 | 适用场景 | 计算特点 |
|---|---|---|---|
| FNO(傅里叶神经算子) | 傅里叶域频谱卷积学习全局关联 | 规则矩形区域、规则 RVE | 频域 FFT 密集,GPU 张量运算友好,规则网格才可发挥 |
| DeepONet(深度算子网络) | branch-trunk 双网络:输入函数编码 + 任意查询位置解码 | 输入输出形式多变、需任意空间点查询 | 双网络结构,查询灵活,训练开销中等 |
| iFOL(隐式神经场算子学习) | 条件神经场(Conditional Neural Field)参数化 | 不规则几何、非结构网格、连续场表示 | 几何自适应最强,训练成本与调参难度也最高 |
选型原则(论文验证结论):规则区域先 FNO;查询形式多变用 DeepONet;几何不规则、非结构网格上 iFOL 有参数化学习优势。不要一上来就用最大模型——模型越复杂,训练成本、数据需求、调试难度越高。
2.2 有限元残差物理信息损失:本路线最重的计算
损失函数 L = Lₜ + Lᵤ 由热场与位移场的单元残差构成,每个单元的残差涉及积分点遍历、形函数求值、材料矩阵组装与载荷项累加。其计算特点:
| 特征 | 说明 | 硬件影响 |
|---|---|---|
| 无标签依赖 | 不需要预生成仿真标签数据,省去大规模离线数据生产 | 降低存储压力,但不降低总算力 |
| 残差计算密集 | 每次迭代都要执行类有限元组装流程 | CPU 多核 + AVX-512 指令集敏感 |
| 批大小受限 | 物理约束使大 batch 收益递减 | 显存需求低于纯数据驱动大模型,48GB 单卡足够大多数场景 |
| JAX 即时编译 | Folax 基于 JAX,XLA 编译后的 CPU/GPU 混合执行 | 高主频 CPU 显著加速编译与 CPU 侧残差计算 |
2.3 训练策略与验证计算
- 训练方式:monolithic(单场联合)vs staggered(热-力交替)对比;Adam 优化器;batch size 与 epoch 因问题而异——论文中不同问题 epoch 达 10,000~50,000,不可机械套用
- 采样策略:DOE/主动采样优于随机采样;输入维度涵盖浇注温度、模具初始温度、换热系数、几何特征、材料物性
- 四层验证:①温度场误差 → ②位移场误差 → ③热流/应力梯度误差 → ④关键工程指标(最大热应力、变形量、危险区域位置)。警惕"平均误差小、热点错误大"——铸造缺陷由梯度与极值控制,全域 MAE 会掩盖裂纹风险
2.4 计算负载全景:一张表看懂瓶颈在哪
| 负载层 | 计算类型 | 精度需求 | 硬件瓶颈 |
|---|---|---|---|
| 神经算子训练 | 残差损失 + 反向传播,10k~50k epoch | FP32/BF16 | GPU 算力 + CPU 残差组装(混合) |
| 高保真样本生成 | ProCAST/FLOW-3D 铸造全流程求解 | FP64/FP32 | CPU 多核 + 大内存 |
| 推理与工艺筛选 | 单次前向传播 | FP32/FP16 | GPU 轻载,可批量并发 |
| 四层验证与热点分析 | 梯度计算、路径对比 | FP64 | CPU 高主频 + 大内存 |
| 训练数据/网格管理 | 非结构网格 I/O | — | NVMe 高速存储 |
三、UltraLAB 硬件配置怎么选
3.1 按工程阶段分档配置
| 档位 | 定位 | CPU | GPU | 内存 | 存储 | 适用对象 |
|---|---|---|---|---|---|---|
| 方案 C1(算法验证) | 论文复现、二维规则区域 | 24核 高主频 | 1× RTX 5090 32GB | 128GB DDR5 ECC | 2TB NVMe | 高校课题组 |
| 方案 C2(三维研发) | 三维RVE/铸造案例训练 | 32核 高主频(AVX-512) | 1× 48GB 专业卡 | 256GB DDR5 ECC | 4TB NVMe | 企业仿真AI团队 |
| 方案 C3(训练节点) | 工业多工况50k epoch训练 | 64核 | 2~4× 48GB(多算子并行) | 512GB~1TB DDR5 ECC | 8TB NVMe RAID | 铸造工艺研发平台 |
| 方案 C4(高保真节点) | ProCAST/FLOW-3D样本生成与复核 | 64~96核 高主频 | 2× 24GB(后处理) | 512GB~1TB | NVMe 阵列 + 30TB 数据盘 | 工艺签核工作站 |
| 方案 C5(产线集成) | 推理代理+自动回退系统 | 32核 | 1~2× 48GB | 256GB | 4TB NVMe | 铸造产线工艺部门 |
3.2 选型要点解读
- CPU 是隐形主角:有限元残差组装、JAX XLA 编译、高保真铸造求解、四层验证——这条技术路线的 CPU 负载占比远高于纯数据驱动的深度学习。AVX-512 指令集与 5GHz 级主频对残差计算的速度提升是成倍级的,这是 UltraLAB C 系列区别于普通 GPU 服务器的关键设计。
- GPU "单卡大显存"优于"多卡拼显存":物理信息损失下大 batch 收益递减,2×24GB 的通信开销换不来训练加速;48GB 单卡 + 后续按需加卡是最稳路径。
- 高保真节点不可省:论文明确指出第一阶段落地就是"旁路代理"——高保真软件生成少量可靠样本、最终候选方案返回高保真复核。砍掉 C4 等于砍掉整条落地路线。
- ECC 与稳定供电是训练刚需:50,000 epoch 的训练中断一次,代价是数天时间。这不是性能参数,是成本参数。
四、软件清单:AI 铸造仿真的完整技术栈
4.1 神经算子与物理信息层
| 层 | 软件 | 用途 |
|---|---|---|
| 算子框架 | Folax(论文官方实现,JAX) | 有限元引导物理信息算子学习 |
| 深度学习框架 | JAX + Flax / PyTorch(神经算子库) | FNO、DeepONet、iFOL 实现 |
| 神经算子库 | neuraloperator(PyTorch)、PhysicsNeMo | 基线模型与对比实验 |
4.2 高保真铸造 CAE 层
| 层 | 软件 | 用途 |
|---|---|---|
| 铸造仿真 | ProCAST、FLOW-3D CAST、THERCAST | 样本生成、最终签核复核 |
| 前处理 | HyperMesh、Gmsh、ANSYS SpaceClaim | 非结构网格划分与几何清理 |
| 材料数据管理 | 自研 T-k/T-E/T-α 物性表格 + 数据库 | 温度相关物性管理(论文强调不可超出试验覆盖区) |
4.3 训练与验证层
| 层 | 软件 | 用途 |
|---|---|---|
| DOE/主动采样 | OpenMDAO、SALib、BoTorch | 参数空间定义与采样 |
| 训练管理 | Optuna、Weights & Biases | 超参搜索与实验追踪(10k~50k epoch 不可机械套用) |
| 验证对比 | ParaView、自研 Python 比对脚本 | 四层验证、热点区域路径对比 |
4.4 工程集成层
| 层 | 软件 | 用途 |
|---|---|---|
| 自动回退编排 | 自研调度脚本 / LangGraph | AI 不可靠时自动回退高保真求解 |
| 工艺知识库 | RAG 向量库 + 企业工艺规范 | 材料数据、历史工艺案例检索 |
五、大模型本地部署:工艺知识 Copilot 与报告生成
AI 铸造仿真的工程化不只有神经算子——材料物性整理、DOE 方案生成、四层验证报告撰写、工艺规范问答,这些环节适合由本地大模型承担。铸造工艺数据是企业核心资产,必须私有化部署。
5.1 模型规模与显存需求对照表
| 部署角色 | 推荐模型 | 参数规模 | INT4量化显存 | 推荐GPU配置 |
|---|---|---|---|---|
| 工艺知识问答 | Qwen3-32B / Qwen2.5-32B | 32B | ~20GB | 单卡 24GB |
| 验证报告生成/物性表解析 | Qwen3-72B(长上下文) | 70B+ | ~40GB+KV | 单卡 48GB |
| 多Agent(采样规划+报告+问答) | 72B × 2 实例 | 70B | ~80GB | 2× 48GB(96GB) |
| 团队中枢 | Qwen3-235B-A22B(MoE) | 235B | ~120GB | 2× 96GB / 4× 48GB |
5.2 推荐部署栈
- 推理引擎:vLLM(报告批量生成)/ Ollama(工位轻量问答)
- RAG:企业材料数据库(T-k/T-E/T-α 表格)、工艺规范、历史算例向量化(Qdrant/Milvus)——论文反复强调"材料数据不能超出试验覆盖区",让大模型检索真实物性表而非凭记忆回答,正是 RAG 的价值
- 神经算子助手:Code 模型(Qwen3-Coder-32B)辅助 Folax/PyTorch 训练脚本编写与调试
- 安全底线:全链路离线,工艺参数与材料数据不出内网
六、典型应用场景与配置速查
| 应用场景 | 负载特征 | 推荐方案 | 预算区间 |
|---|---|---|---|
| 高校论文复现与算法研究 | 轻量训练 + 文献验证 | C1 | 入门 |
| 铸造企业 AI 代理模型研发 | 三维训练 + 高保真样本 | C2 + C4 | 中高 |
| 多材料/多工况工艺筛选平台 | 50k epoch 批量训练 | C3 + C4 | 高 |
| 热处理/增材制造工艺优化 | 同构方法迁移 | C2/C3 | 中~高 |
| 铸造产线实时工艺助手 | 推理 + RAG 问答 | C5 + 32B 模型 | 中 |
| 全栈布局(数据-模型-产线) | 三线全配 | C3 + C4 + C5 组合 | 旗舰 |
七、常见问题:硬件配置深度分析
Q1:神经算子训练对 GPU 显存还是算力更敏感?为什么 48GB 单卡优于 2×24GB?
A:物理信息损失改变了 GPU 利用模式。 纯数据驱动训练可以通过堆 batch 吃满显存换吞吐,但有限元残差是物理约束损失——大 batch 下残差项的平均化会稀释物理约束的约束力,论文实践与文献均显示大 batch 收益递减。因此单卡 48GB 的带宽与算力集中度优于双卡 24GB(后者还要付出 NCCL 通信开销)。除非需要同时训练 FNO/DeepONet/iFOL 三组对照实验,否则 C2 的单卡方案是最优起点。
Q2:为什么 AI 铸造仿真还必须保留高保真有限元工作站?不能全上 GPU 吗?
A:因为论文给出的工程化验收指标是"会不会自动回退",而不是"预测快不快"。 落地路线第一阶段就是旁路代理:高保真软件生成少量可靠样本 → AI 快速筛选候选 → 最终候选返回 ProCAST/FLOW-3D 复核。没有高保真节点,整条路线不成立。更关键的是四层验证中的热点核对——AI 在温度场上准确不代表应力梯度可信,裂纹风险判断必须经高保真结果路径对比。C4 节点的 64~96 核 CPU + 512GB 内存是工程签核的门槛配置。
Q3:10,000~50,000 epoch 的训练对硬件意味着什么?
A:意味着"稳定性"是隐性第一指标。 50k epoch 在 C2 级机器上需要数天到数周连续运行。这期间一次内存位翻转、一次过热降频导致进程崩溃、一次断电,代价都是从头再来。DDR5 ECC、双冗余电源、风道散热余量——这些不体现在跑分里的参数,才是训练平台的真实 ROI。UltraLAB C 系列全线标配 ECC 与冗余电源设计,正是针对这类长时训练负载。
Q4:有限元残差计算为什么强调 CPU 的 AVX-512 和高主频?
A:因为残差组装是"类有限元"的标量密集运算,不是张量运算。 每个训练迭代中,单元级残差要遍历积分点、求形函数、算 Jacobian、组装材料矩阵——这些操作在 GPU 上并行效率有限(不规则网格、动态形状),JAX 的 XLA 编译器会把它们主要放在 CPU 执行。AVX-512 指令集对这些向量化程度中等的浮点运算是成倍加速,5GHz 主频则直接压缩每次迭代的墙钟时间。这也是为什么 C 系列 CPU 选择高主频 + 全指令集支持的平台。
Q5:高保真铸造求解(ProCAST/FLOW-3D)对硬件的真实需求是什么?
A:大内存 + 多核,且是"内存先行"。 三维铸造全流程模拟(流动+凝固+应力)的网格量轻松达到千万级单元,每时间步的场数据驻留就要上百 GB;耦合求解器对内存带宽极其敏感,内存不足触发 swap 后性能断崖式下跌。C4 方案 512GB~1TB 内存 + 高主频多核的组合,就是为这类"内存墙"负载设计。GPU 在后处理渲染环节有用,但求解本体是 CPU 负载。
Q6:小团队预算有限,想验证这条路,最低配置是什么?
A:C1 方案 + 云端高保真求解时长。 先用二维规则区域 + FNO 复现论文基线(RTX 5090 32GB + 128GB 内存足够),高保真样本生成按量购买云端 ProCAST/FLOW-3D 时长而非自建节点。验证可行后再升级到 C2+C4 的自有双轨架构——论文方法的美妙之处就在于不需要预生成海量标签数据,样本量需求远低于纯数据驱动路线,这本身就是小团队的入场优势。
写在最后
这篇论文最重要的启示,不是某个算子在某个基准上赢了几分,而是一个工程哲学的转变:"AI 预测很快"从来不是验收指标,"在未见工况下能否发现自己不可靠并自动回退"才是。
神经算子训练拼 GPU 算力与单卡显存,有限元残差与高保真复核拼 CPU 主频、AVX 指令集与内存容量,而 50k epoch 的训练拼 ECC、冗余与散热——AI 铸造仿真没有单点捷径,只有体系化的算力底座。
UltraLAB 以"高主频 CPU + 大显存 GPU + 大容量 ECC 内存"的均衡架构,覆盖从论文复现到产线集成的全路径。当多物理场神经算子从论文走向浇包,你的算力底座,应该比论文先行一步。
© 2026 UltraLAB 解决方案团队 | 本文基于公开论文《Tackling multiphysics problems via finite element-guided physics-informed operator learning》(Yamazaki 等,2026)及其公开技术解读分析撰写,配置方案为通用参考,具体型号与报价请联系 UltraLAB 官方获取定制化方案。


