






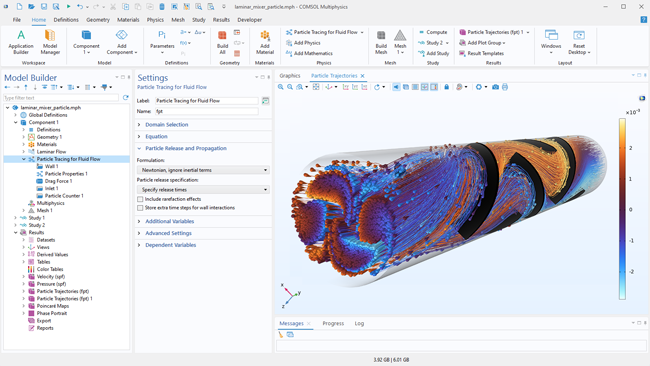
一、范式转移:当Claude/Codex接入有限元内核
COMSOL Multiphysics作为多物理场仿真的标杆工具,长期以来困在一个悖论里:它拥有最灵活的物理场耦合能力,却也是最"吃人"的软件——工程师需要盯着GUI调材料、画网格、设边界、跑参数扫描、翻数百页文档查API。一个亿级网格的流固耦合模型,从几何清理到结果后处理,往往消耗一个博士两周的纯工作时间。
2026年,GitHub上涌现的一批AI+COMSOL开源项目正在改变这个局面。
sim-plugin-comsol让Codex/Claude直接读取.mph模型结构;COMSOL_Multiphysics_MCP通过MCP协议将多物理场建模拆成可调用的工具集;htmlDocsRAG把本地文档做成向量库,消灭LLM的API幻觉;MPh提供稳健的Python自动化底座;OASiS则尝试让AI在FEniCSx、deal.II、COMSOL之间做跨求解器验证。
这不是"一句话出仿真结果"的科幻,而是工程软件从GUI驱动向API驱动的结构性迁移。对高校课题组、工业仿真中心和AI4Sci研究者来说,这意味着:重复劳动交给AI Agent,工程师回归物理判断与模型验证。
二、六大核心应用场景
表格
| 场景 | 技术实现 | 解决痛点 |
|---|---|---|
| 智能模型解析 | sim-plugin-comsol + sim-cli | AI离线检查.mph物理场、参数、网格节点,自动批处理 |
| MCP协议建模 | COMSOL_Multiphysics_MCP | 通过MCP Server将几何、物理、网格、求解、结果导出拆分为AI可调用的原子工具 |
| 文档幻觉消除 | htmlDocsRAG | 本地COMSOL文档向量化检索,Claude/Cursor实时查证API细节 |
| Python自动化层 | MPh (JPype桥接Java API) | 参数扫描、优化、结果提取的稳健脚本底座 |
| 多求解器验证 | OASiS (FEniCSx/deal.II/NGSolve) | AI在同一MCP框架下调用多个FEM后端做交叉验证 |
| 自然语言到仿真 | ppf-contact-solver | 从文本指令直接生成壳体/固体接触仿真流程 |
三、涉及的核心算法与技术栈
1. 有限元方法(FEM)——物理内核
-
多物理场弱形式耦合:热-流-固、电磁-热、声-结构耦合
-
非线性Newton-Raphson迭代、自适应时间步进
-
稀疏线性系统求解:PARDISO(直接法)、GMRES/FGMRES(迭代法)
2. MCP(Model Context Protocol)——AI与工程软件的握手协议
-
将COMSOL能力拆分为模型管理、几何、物理场、网格、求解、后处理六大工具集
-
支持Claude Desktop、Cursor、OpenCode等客户端的无缝调用
3. RAG(Retrieval-Augmented Generation)——文档 grounding
-
本地HTML文档Embedding向量化(text-embedding-3/bge-large等)
-
向量数据库检索 + LLM上下文增强,解决API名称、参数路径的幻觉问题
4. 多Agent协作架构
-
规划Agent(任务分解)→ 代码生成Agent(Python/Java API)→ 执行Agent(COMSOL求解)→ 批评Agent(结果验证)→ 复核Agent(人审接口)
5. 参数扫描与拓扑优化
-
遗传算法、梯度下降、贝叶斯优化(配合MPh的Python接口)
-
伴随法(Adjoint Method)灵敏度分析
四、计算特点深度解析
1. 双栈计算负载:AI层 + 仿真层 这是AI+COMSOL场景与传统仿真的本质区别。同一台工作站需要同时承载:
-
LLM推理层:Claude/Codex代码生成、文档RAG检索、MCP协议通信——显存敏感、带宽敏感
-
COMSOL求解层:稀疏矩阵分解、大规模并行有限元组装——CPU主频敏感、内存容量敏感、内存带宽敏感
2. 自由度与内存的非线性关系 COMSOL的内存需求随自由度(DOF)呈超线性增长:
-
百万级DOF(简单三维稳态):16–32GB
-
千万级DOF(多物理场瞬态):128–256GB
-
亿级DOF(全机流固耦合、鸟撞、动网格):512GB–1TB+
当AI Agent介入后,内存压力进一步叠加:Python脚本层(MPh/JPype)、向量数据库(RAG)、多Agent上下文缓存。
3. 并行特征差异
-
COMSOL参数扫描:embarrassingly parallel,适合多核CPU并行或GPU加速(特定模块)
-
LLM推理:单批次大上下文,适合单卡大显存GPU(48GB/96GB/192GB)
-
MCP服务通信:低延迟网络要求(本地Unix Socket或10GbE以上)
4. 存储I/O瓶颈
-
.mph模型文件(含几何、网格、结果)可达数十GB -
批处理场景下,多版本模型+结果数据产生TB级随机读写
-
NVMe U.2阵列(RAID 0/10)成为刚需,SATA SSD已无法满足AI Agent的频繁Checkpoint需求
五、软件工具链全景
表格
| 层级 | 工具 | 作用 |
|---|---|---|
| 核心求解 | COMSOL Multiphysics 6.3/7.0 | 多物理场有限元内核 |
| AI交互 | Claude Code / Codex CLI / Cursor | 自然语言到代码生成 |
| 自动化底座 | MPh (Python+JPype) | COMSOL Java API的Python封装 |
| MCP服务 | sim-cli / COMSOL_MCP Server | 标准化工具接口 |
| 文档检索 | htmlDocsRAG / ChromaDB | 本地文档向量化 |
| 前后处理 | PyVista / Matplotlib / Paraview | 结果可视化与数据提取 |
| 辅助几何 | gmsh / Blender | 复杂几何预处理(ppf-contact-solver场景) |
| 系统环境 | Ubuntu 22.04 LTS / WSL2 | Python生态与COMSOL Server最佳兼容 |
六、硬件配置推荐(UltraLAB定制方案)
配置一:AI+COMSOL个人研究工作站
面向:博士生、独立研究员、AI4Sci入门用户 典型任务:MPh参数扫描 + Claude Code辅助建模,百万级DOF
相关机型 UltraLAB AX430
表格
| 组件 | 规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon W7-2495X (24核48线程, 睿频4.8GHz) | 高主频保障PARDISO直接求解器效率;24核平衡单线程与多参数扫描 |
| GPU | NVIDIA RTX Pro 5000 48GB (Blackwell架构) | 48GB显存可本地运行32B级代码模型;FP4/FP8量化支持;COMSOL GPU加速模块兼容 |
| 内存 | 128GB DDR5-5600 RDIMM (4×32GB) | 百万级DOF稳态+LLM上下文缓存双栈保障 |
| 系统盘 | 2TB NVMe U.2 (企业级) | 系统+COMSOL安装+Python环境 |
| 数据盘 | 8TB NVMe U.2 | 模型库、批处理结果、RAG向量库 |
| 网络 | 双2.5GbE | 本地MCP服务与文档服务器通信 |
| 系统 | Windows 11 + WSL2 Ubuntu 22.04 | 双环境:GUI建模在Win,MPh/AI Agent在Linux |
| 电源 | 1600W 80Plus钛金 | 预留升级空间 |
配置二:课题组级AI驱动多物理场仿真平台
面向:高校实验室、工业仿真部、CAE自动化团队 典型任务:千万级DOF多物理场瞬态 + 本地LLM多Agent协作 + 批量参数优化
相关机型 UltraLAB GT450P
表格
| 组件 | 规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon 6980P (128核128线程/颗, 3.8GHz全核) | 256线程,PARDISO并行区完美扩展;高内存带宽通道数 |
| GPU | 2× NVIDIA RTX Pro 6000 96GB (Blackwell) | 单卡96GB可承载70B级量化模型或双Agent并行;NVLink桥接双卡显存池化 |
| 内存 | 768GB DDR5-6400 RDIMM (12×32GB) | 千万级DOF瞬态+多物理场耦合的内存基线;RDIMM ECC保障7×24批处理稳定性 |
| 存储阵列 | 4TB NVMe U.2 ×4 (RAID 5) | 阵列卡方案,16GB/s级顺序读写,满足批量Checkpoint与结果导出 |
| 数据盘 | 16TB SATA 企业级 | 长期模型版本管理与RAG文档库 |
| 网络 | 双10GbE (Intel X710) | MCP Server集群通信、多机仿真数据同步 |
| 系统 | Ubuntu 22.04 LTS + COMSOL Server | 纯Linux环境,Python生态与MCP服务原生兼容 |
| 散热 | 360mm×2 液冷 + 机箱风道优化 | 双路CPU+双GPU 1200W+热设计功耗的 sustained 负载 |
配置三:AI4Sci多求解器研究集群节点
面向:跨学科AI4Sci平台、国家仿真中心、多FEM后端验证团队 典型任务:亿级DOF流固耦合 + OASiS多求解器调度 + 大模型多Agent联邦
相关机型 UltraLAB GA660M
表格
| 组件 | 规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× AMD EPYC 9684X (96核192线程/颗, 3D V-Cache) | 192核384线程+超大L3缓存,FEM矩阵组装效率极致;高内存通道数(12×2) |
| GPU | 4× NVIDIA RTX Pro 6000 96GB | 四卡分别承载:主LLM Agent、代码生成Agent、文档检索Agent、COMSOL GPU求解器;多卡NVLink全互联 |
| 内存 | 1TB DDR5-4800 RDIMM (16×64GB) | 亿级DOF多物理场的内存门槛;RDIMM保障长期稳定性 |
| 存储 | 8TB NVMe U.2 ×8 (RAID 10, SmartRAID Ultra 3258p-32i/e) | 32i端口阵列卡,全闪存架构,满足多节点并发I/O |
| 网络 | 25GbE/100GbE (Mellanox ConnectX-6) | OASiS跨节点FEM数据交换、大模型参数同步 |
| 系统 | Ubuntu 22.04 + Kubernetes | 容器化多Agent环境,MCP Server微服务化部署 |
| 电源 | 2000W×2 | 4×GPU+双路CPU峰值功耗 |
七、结语:AI是杠杆,硬件是支点
COMSOL不会因为接上了Claude或Codex就变成一个"黑盒许愿机"。模型的物理可信度,仍然取决于材料参数的准确性、边界条件的合理性、网格的收敛性、以及求解器设置的工程经验。AI的价值在于:把工程师从重复的GUI操作、文档检索、脚本调试中解放出来,让其专注于物理假设与结果验证。
但这套新范式的落地,对硬件提出了"双栈并行"的苛刻要求——既要满足COMSOL有限元求解对高主频CPU、大容量内存、高带宽通道的渴求,又要承载本地LLM推理对超大显存、FP4/FP8量化、NVLink互联的依赖。
UltraLAB深耕定制图形工作站与科学计算平台,针对AI+多物理场仿真的融合场景,提供从塔式静音工作站到机架式集群节点的全系列方案。无论是单兵作战的博士生,还是需要7×24小时批量跑参数扫描的工业仿真部,我们均可基于实际DOF规模、AI Agent负载和预算,提供CPU液冷超频、多卡GPU拓扑优化、全闪存阵列、双系统启动等深度定制服务。
让AI驱动仿真,让硬件不再成为瓶颈。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


