






引言:仿真的瓶颈,从来不是精度,而是时间
算一个千万网格的CFD工况,几小时;扫一遍气动外形的200组参数,一个月;跑一次全芯片SPICE仿真,以周计;用DFT筛一千种候选材料,等不起。传统科学仿真和EDA行业半个世纪来一直在用精度换时间,而AI正在打破这个交换率——神经算子把流场预测压到秒级,AI势函数让分子动力学同时拿下DFT精度和经典力场速度,强化学习把芯片布局布线从人海战术变成算力竞赛。
但新的工作流需要新的算力结构:传统求解器吃内存带宽和双精度,AI训练吃显存和张量算力,EDA单线程工具吃CPU主频。一台"通用高配电脑"喂不饱这三头猛兽。本文把科学仿真/EDA/工业AI四大领域的AI工作流、硬件配置、团队规模、系统软件与预装清单一站讲透。
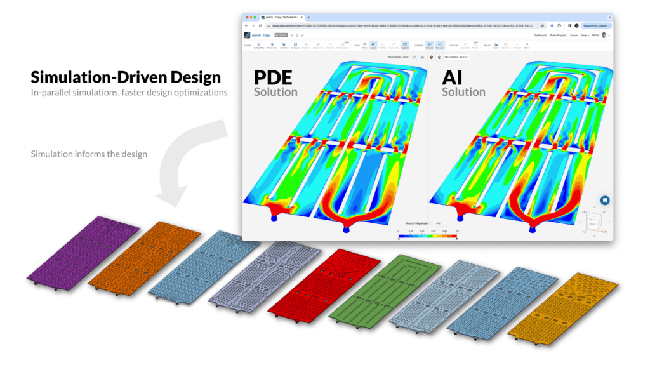
一、AI结合四大主要业务
| 领域 | 传统模式痛点 | AI结合方式 | 加速效果 |
|---|---|---|---|
| 流体(CFD/气动/水动力) | 单工况数小时,参数扫描以月计 | 神经算子(FNO/DeepONet)训练代理模型,秒级预测流场;PINN做流场重构与反问题 | 设计初筛提速100–1000倍 |
| 电磁(天线/EMC/信号完整性) | 全波仿真大阵列数小时,EMC反复打样 | S参数/远场代理模型+贝叶斯优化自动寻优;眼图与串扰AI预测 | 天线优化周期从周到天 |
| 分子动力学(材料/药物/化工) | DFT太贵、经典力场不准、时间尺度短 | AI势函数(DeePMD/MACE)逼近DFT精度,百万原子微秒级模拟;结构预测与虚拟筛选 | 成本降3–4个数量级 |
| 芯片设计EDA | PPA探索靠人力堆,布局布线反复迭代,计算光刻昂贵 | 强化学习布局布线(DSO.ai/Cerebrus);GPU加速计算光刻(cuLitho);LLM生成RTL/TCL/验证用例 | 设计周期缩短30%以上 |
必须先说清的认知:AI不是取代求解器,而是站在求解器肩膀上——代理模型的训练数据来自高保真仿真,最终校核仍要回到传统求解器。正确姿势是"求解器产数据 → AI学规律 → 秒级初筛 → 求解器精校核"的闭环,本地算力要同时扛住两头。
二、系统与大模型矩阵
2.1 操作系统:按工具链分轨
- 结构与流体前处理工作站:Windows 11 专业版——SpaceClaim、SolidWorks、HyperMesh等GUI前处理生态在Windows
- 计算节点与EDA环境:Rocky Linux 9 / Ubuntu 24.04 LTS——求解器集群、Virtuoso/Innovus等EDA工具链、Slurm调度的标准底座
- 容器化部署:Apptainer + NVIDIA NGC镜像——求解器和AI环境隔离,集群内一键分发
2.2 AI框架与领域模型
| 层 | 软件/模型 | 用途 |
|---|---|---|
| AI基础框架 | PyTorch / JAX + CUDA | 一切训练的底座 |
| 物理AI | NVIDIA PhysicsNeMo(原Modulus) | PINN+神经算子官方框架,内置大量CFD/电磁参考案例 |
| PINN库 | DeepXDE | 正反问题、数据同化,论文复现友好 |
| 神经算子 | FNO / DeepONet / Geo-FNO | 流场、温度场、电磁场代理模型主力架构 |
| 分子动力学 | DeePMD-kit + LAMMPS / MACE / NequIP | AI势函数训练与推理 |
| 结构预测 | Boltz-2 / Chai-1 / Protenix(开源) | 蛋白/复合物结构预测,AlphaFold3的开源平替 |
| 材料计算 | ABACUS / Quantum ESPRESSO / CP2K | 开源DFT,为AI势函数产训练数据 |
| 计算光刻 | NVIDIA cuLitho | GPU加速OPC/反演光刻(需配合EDA流程) |
| 商业AI-EDA | Synopsys DSO.ai / Cadence Cerebrus | 强化学习设计空间探索(license制,本地算力承载) |
| 本地LLM | Qwen3 32B / DeepSeek蒸馏版 + vLLM | 写求解器脚本、TCL、文献综述、仿真报告,数据不出内网 |
2.3 传统求解器栈(开源部分全预装)
OpenFOAM、SU2(流体)、LAMMPS、GROMACS(分子动力学)、ParaView/OVITO/VESTA(可视化);商业软件ANSYS、COMSOL、HFSS、CST、Synopsys/Cadence/Siemens EDA按license协助部署并对接License服务器。
三、硬件配置方案:UltraLAB三档算力
档位A:AI4S入门工作站(研究生/个人工程师)
| 部件 | 配置 |
|---|---|
| CPU | Intel Ultra 9 285K / AMD 9950X,压缩机水冷超频至5.x GHz全核 |
| GPU | RTX 5090 32GB |
| 内存 | 128GB DDR5 |
| 存储 | 4TB NVMe |
胜任:PINN与代理模型训练、GROMACS/LAMMPS GPU加速、中小规模CFD、EDA学习全流程。
档位B:主力计算工作站(课题组/研发团队主力)
| 部件 | 配置 |
|---|---|
| CPU | 双路EPYC 9005(最高192核,24通道DDR5)或线程撕裂者PRO 96核 |
| GPU | RTX PRO 6000 Blackwell 96GB ×1–2 |
| 内存 | 768GB–1.5TB ECC |
| 存储 | 8TB NVMe RAID0 + 团队NAS |
| 散热 | 定制水冷/压缩机散热,7×24满载验证 |
胜任:千万级网格CFD、全波电磁仿真、DeePMD百万原子训练、AI势函数+神经算子混合负载。一机同时是"传统求解器计算站"和"AI训练站"。
档位C:计算集群(企业研发中心/芯片设计公司)
| 部件 | 配置 |
|---|---|
| 计算节点 | 双路EPYC节点 ×N(跑CFD/FEA/电磁求解器) |
| GPU节点 | 4–8卡节点 ×N(跑AI训练与推理) |
| 前端工作站 | 高频超频工作站(EDA布局布线、前处理) |
| 网络/存储 | InfiniBand NDR 200/400G + Lustre/BeeGFS并行文件系统 |
| 调度 | Slurm统一队列,CPU/GPU混合编排 |
四条选型铁律(这个行业的钱要花在刀刃上)
- 传统CFD/FEA看内存带宽,不看核心数:求解器是典型的带宽饥渴型负载,消费级双通道喂不饱,EPYC的12/24通道才能让上百个核不饿肚子
- AI训练看显存,分子动力学看单精度算力:DeePMD/GROMACS对单精度友好,RTX卡性价比极高;但纯FP64双精度负载请交给CPU集群或数据中心卡,别指望消费卡
- EDA和前处理看主频——频率就是钱:布局布线、SPICE大量单线程瓶颈,且商业license按核计费,5.5GHz的16核往往比3GHz的64核更快更省license费。这正是超频工作站不可替代的黄金场景
- 水冷决定产量:参数扫描和AI训练以周为周期满载,风冷降频等于每天白丢几小时算力
四、团队规模与算力规模对照
| 团队 | 设备清单 | 大致预算 |
|---|---|---|
| 研究生/个人工程师 | 档位A ×1 | 3–5万元 |
| 课题组(5–10人) | 档位B ×1–2 + 档位A若干 | 15–40万元 |
| 企业研发中心/芯片团队(20–100人) | 档位C集群 + 前端超频工作站 | 100万元起 |
| 整机厂/晶圆厂级 | 机房级混合集群,按需定制 | 另议 |
五、交钥匙预装清单:开机即算
科研团队的时间该花在论文和产品上,不该花在编译报错上。UltraLAB出厂预装:
系统与调度层
- Rocky Linux 9 / Ubuntu 24.04(或Windows双系统),驱动、CUDA、NCCL全调优
- Slurm作业调度 + Open MPI/Intel MPI,多节点队列开箱可用
- Apptainer容器环境 + 常用NGC镜像预拉取
求解器层
- OpenFOAM、SU2、LAMMPS、GROMACS、ABACUS、Quantum ESPRESSO、CP2K全部源码编译,针对本机CPU指令集(AVX-512/AVX2)优化
- 商业软件(ANSYS/COMSOL/HFSS/Synopsys/Cadence)按license协助安装,对接License服务器
AI层
- PyTorch、JAX、PhysicsNeMo、DeepXDE、DeePMD-kit、MACE、Boltz-2、RDKit环境调试完毕
- 本地LLM(Qwen3 + vLLM)部署完成,内网可用
- 6套现成工作流模板:CFD代理模型训练、PINN反问题、AI势函数训练、分子动力学GPU加速、结构预测、EDA脚本LLM助手
调优与验证层
- NUMA绑定、内存通道均衡、超频参数全部固化进BIOS
- 出厂附72小时满载烤机报告 + LINPACK/Stream/OpenFOAM基准跑分,算力承诺白纸黑字
文档与培训
- 图文手册 + 远程培训,新研究生半天上手提交第一个Slurm作业
六、常见问题(FAQ)
Q1:AI会取代传统求解器吗?
不会。代理模型负责设计空间的快速初筛,把候选方案从1000个缩到10个,最终校核仍靠高保真求解器。而且AI的训练数据本来就来自求解器——本地既要算得动仿真,也要训得动模型,这就是混合算力存在的理由。
Q2:预算有限,先堆CPU还是GPU?
看负载构成:以传统CFD/FEA为主,先砸内存带宽和核数(双路EPYC);以AI代理模型、分子动力学、深度学习为主,先砸GPU显存。档位B的"双路EPYC+大显存卡"就是为两头兼顾设计的。
Q3:消费级显卡能跑科学计算吗?
跑AI训练和分子动力学完全胜任且性价比极高;但FP64双精度被大幅削减,纯双精度求解负载请走CPU集群或数据中心GPU,选型时务必分清自己的精度需求。
Q4:为什么内存通道数比核心数更要紧?
CFD/有限元每个核都要持续吞数据,带宽不够,核再多也是空转。实测同一个CFD算例,24通道EPYC平台相比双通道消费平台可快数倍——这不是堆核能补回来的。
Q5:超频对科研计算是不是噱头?
对GPU密集负载确实是噱头,但对EDA单线程工具、GUI前处理、按核收费的license软件,主频直接等于工期和license成本。UltraLAB用压缩机水冷把超频态做到7×24满载稳定,并附烤机报告——超频不是跑分表演,是可交付的生产力。
Q6:芯片设计公司的数据安全怎么保证?
全部本地部署、内网物理隔离,LLM本地化运行,RTL代码和版图数据不出机房一步。
结语
科学计算的下一轮范式已经很清楚:求解器保证可信,AI负责便宜,高频CPU守住单线程阵地。三者的算力特性截然不同,一台"高配电脑"无法通吃——这恰恰是专业定制的价值所在。UltraLAB深耕科学仿真与EDA算力定制,从超频单机到CPU/GPU混合集群、从BIOS调优到全套开源求解器与AI框架预装,让课题组和研发团队开机即算,把工期留给创新,而不是留给排队和编译。
欢迎联系 UltraLAB,获取针对您研究方向与软件栈的定制算力方案及基准测试数据。
UltraLAB图形工作站供货商:


