






摘要与适用读者
nnU-Net 是德国癌症研究中心(DKFZ)医学影像计算团队提出的自配置(self-configuring)生物医学图像分割框架:给定新数据集,它自动完成预处理、网络拓扑、训练与后处理配置,无需人工调参即可在大量分割任务上达到有竞争力的性能。本文基于其 Nature Methods 论文与官方 GitHub 仓库的硬件说明,分析训练与推理各阶段的计算负载,为单机工作站部署 nnU-Net 提供分档硬件建议。
适用读者:医学影像课题组、生物医学工程实验室、从事 CT/MRI 分割算法研究与临床前验证的科研人员,以及为这类团队规划算力的设备管理人员。
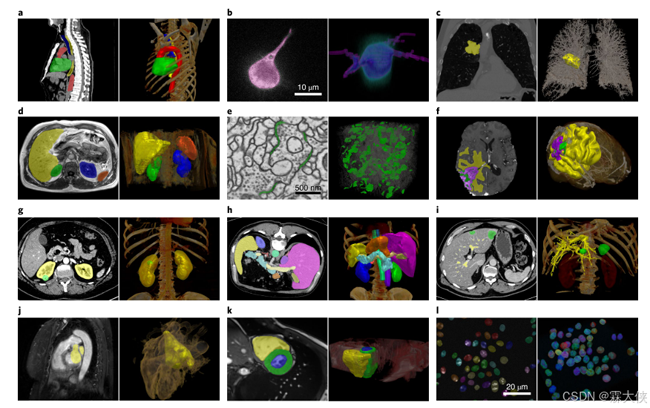
资料背景与核心观点
- 资料一:nnU-Net: a self-configuring method for deep learning-based biomedical image segmentation(Nature Methods,2021),德国癌症研究中心(DKFZ)/海德堡大学。原文链接:https://www.nature.com/articles/s41592-020-01008-z
- 资料二:nnU-Net 官方仓库(MIC-DKFZ/nnUNet)安装与硬件要求文档。链接:https://github.com/MIC-DKFZ/nnUNet
核心观点:
- nnU-Net 的核心贡献不是新网络结构,而是把分割流程中依赖经验的配置决策(重采样、归一化、patch 尺寸、batch size、网络深度、训练计划)转化为基于数据集"指纹"(体素间距、图像尺寸、模态数、类别数)的确定性规则,从而对新任务开箱即用。
- 官方文档明确建议用 GPU 训练,CPU 或 Apple MPS 训练"会慢到不现实";训练用 GPU 至少需要约 10 GB 显存(官方列举的常见非数据中心卡包括 RTX 2080 Ti、RTX 3080/3090、RTX 4080/4090)。
- 官方同时强调需要"与 GPU 匹配的强大 CPU":最低 6 核 12 线程,CPU 需求主要来自数据增强,并随输入通道数与目标结构数量增长;"GPU 越快,CPU 越要跟得上"。
- 推理也推荐 GPU(至少 4 GB 空闲显存),但 CPU/MPS 上的推理时间通常仍可接受。
主要功能模块与核心算法
- 数据集指纹提取与管线指纹:统计训练集的空间分辨率、尺寸分布、强度分布,按内置规则自动确定重采样目标间距、归一化方案与 patch 尺寸。
- 自动网络配置:以 U-Net 为骨架,按 patch 尺寸自动确定下采样层数、卷积核与特征通道;nnU-Net v2 支持多种残差编码器预设。
- 五折交叉验证与集成:默认训练 2D U-Net、3D 全分辨率 U-Net 与 3D 低分辨率 U-Net 三个配置并自动选择/集成。
- CPU 端数据增强流水线:训练时实时执行旋转、缩放、弹性形变、镜像、亮度/对比度等增强,由 batchgenerators 库在 CPU 上完成,与 GPU 训练异步流水。
- 滑窗推理与高斯加权拼接:对超出显存的大体数据,推理以 patch 滑窗进行并按高斯权重融合。
计算特点与性能瓶颈
- GPU 密集的训练内核:3D 卷积训练是显存与算力双重密集负载。显存占用由 patch 尺寸、batch size 与网络深度决定;官方给出的下限约 10 GB,大体数据/大 patch 配置会显著更高。
- CPU 端增强是关键配套:实时数据增强在 CPU 上逐 patch 计算,6 核 12 线程只是下限;当 GPU 升级(更快消费完增强后的 batch)而 CPU 不变时,数据供给会成为新瓶颈,出现 GPU 空转。输入通道多(多模态)、分割结构多的数据集进一步加重 CPU 负担。
- 预处理阶段 I/O 与内存敏感:重采样与归一化会把整个数据集读入处理,内存需求与单例图像尺寸相关;大型 3D 数据集预处理可能需要数十 GB 内存。
- 推理负载轻于训练:滑窗推理显存需求约 4 GB 起步,CPU 推理可行但慢;批量临床级推理仍建议 GPU。
- 并行扩展方式:单数据集训练以单卡为主;多卡更多用于并行跑不同 fold 或不同配置,而非单任务数据并行——选型时不应盲目堆多卡。
典型应用场景
- 器官/肿瘤自动勾画研究:CT 或 MRI 数据集(数十至数百例),训练五折交叉验证的三个配置,是工作站级 nnU-Net 最典型的负载;单卡 24 GB 显存可覆盖绝大多数官方预设。
- 多模态分割(如 BraTS 类脑肿瘤多序列 MRI):输入通道多、CPU 增强负载大,需要更强 CPU 与更大内存。
- 算法基准与竞赛复现:nnU-Net 常作为分割基线,需要反复训练不同数据集,NVMe 项目盘与足够内存可显著缩短预处理与切换开销。
- 临床前批量推理:对已训练模型做大批量影像推理,GPU 推理 + 多线程数据加载的工作站即可胜任。
UltraLAB 硬件配置建议
依据官方硬件说明(训练 GPU ≥约 10 GB 显存、CPU ≥6 核 12 线程、推理 ≥4 GB 显存)与 3D 医学影像数据集的规模差异给出条件化分档:
| 配置档位 | 入门(2D/小数据集、教学) | 主流(3D 分割研究主力) | 高性能(多模态/大规模数据集) |
|---|---|---|---|
| CPU 选型思路 | 8—12 核,高主频 | 16—24 核,高主频优先,保障增强流水线不拖累 GPU | 24—32 核,多模态增强与多实验并行 |
| 内存 | 64 GB | 128 GB(大体数据预处理更从容) | 192—256 GB |
| GPU 与显存 | 单卡 12—16 GB 显存 | 单卡 24 GB 显存,覆盖官方绝大多数 3D 预设 | 单卡 48 GB 显存或双卡 24 GB(并行跑 fold/配置) |
| 系统盘/项目盘/数据盘 | 1 TB NVMe;2 TB 数据盘 | 1—2 TB NVMe 系统+项目盘;4 TB 数据盘 | 2 TB NVMe 系统+项目盘(预处理缓存放 NVMe);8 TB 数据盘 |
| 散热/电源/扩展性/稳定性 | 单卡风冷,≥850 W | 强风道塔式,≥1200 W,预留第二卡位 | 高塔/机架散热,≥1600 W,ECC 内存,支持长时间满负荷训练 |
| 适用场景 | 2D 分割、小样本验证、课程实验 | CT/MRI 单模态 3D 分割、竞赛基线 | 多模态/多中心大数据集、密集实验迭代 |
推荐理由与边界:官方明确的下限(10 GB 显存、6 核 12 线程)只保证"能跑",3D 全分辨率配置在实际数据集上通常需要 16 GB 以上显存;CPU 与 GPU 需按"GPU 越快、CPU 越强"的原则匹配,避免高端 GPU 配低端 CPU 造成数据饥饿。nnU-Net 对专业图形卡无认证要求,消费级 CUDA 卡即可满足官方列举范围。
软件清单
| 软件 | 角色 | 必需/可选 |
|---|---|---|
| nnU-Net v2 | 分割框架本体 | 必需 |
| PyTorch(CUDA 版) | 深度学习框架 | 必需 |
| batchgenerators | 数据增强库(nnU-Net 依赖) | 必需(随框架安装) |
| SimpleITK / nibabel | 医学影像 I/O | 必需(随框架安装) |
| NVIDIA 驱动 + CUDA | GPU 运行环境 | 必需 |
| ITK-SNAP / 3D Slicer | 标注与结果查看 | 可选 |
| Docker / Apptainer | 环境封装与复现 | 可选 |
常见问题
1. 为什么官方说"GPU 越快,CPU 越要跟得上"?
nnU-Net 训练时每个 batch 的增强在 CPU 上实时完成。GPU 升级后单步计算更快,单位时间消耗的增强数据更多;CPU 核数或主频不足时 GPU 会等待数据,实测利用率下降。16—24 核高主频 CPU 搭配 24 GB 级 GPU 是均衡点。
2. 12 GB 显存能训练 3D 全分辨率模型吗?
官方下限约 10 GB 意味着小 patch 配置可运行;3D 全分辨率 U-Net 在较大 patch 下常超过 12 GB。实践上 12—16 GB 适合 2D 配置与小 patch 3D,主力 3D 研究建议 24 GB 起步。
3. 多卡训练单个 nnU-Net 模型划算吗?
nnU-Net 的标准流程是单卡训练各配置,五折交叉验证与三种配置天然适合"一卡一任务"并行。双卡的价值在于同时跑两个 fold/配置把总时长减半,而不是对单任务做数据并行;预算有限时优先把单卡显存配足。
4. 内存 64 GB 够吗?
常规数据集足够;但当单例体数据很大(如高分辨率全脑 MRI、多模态拼接)或同时预处理多个数据集时,重采样与归一化会推高内存峰值,128 GB 更稳妥。
5. 推理工作站可以怎么省?
官方说明推理只需约 4 GB 空闲显存,CPU 推理也可接受。批量推理可用入门档 GPU 或纯 CPU 工作站承担,把训练资源留给实验迭代;大批量临床级吞吐再考虑专用推理卡。
总结与选型建议
nnU-Net 的选型要点是"GPU 显存决定能训什么配置,CPU 决定训练跑多快"。建议:3D 医学影像分割主力配置为 16—24 核高主频 CPU + 128 GB 内存 + 24 GB 显存单卡;多模态或大型数据集把 CPU 提到 24—32 核、内存 192 GB 以上;教学与 2D 场景 12—16 GB 显存即可。双卡优先用于并行跑交叉验证折而非单任务并行。采购前用目标数据集跑一次预处理与单折训练,验证显存与内存水位后再定档。
参考来源
- Isensee F, Jaeger PF, Kohl SAA, Petersen J, Maier-Hein KH. nnU-Net: a self-configuring method for deep learning-based biomedical image segmentation. Nature Methods, 2021. https://www.nature.com/articles/s41592-020-01008-z
- MIC-DKFZ/nnUNet 官方仓库(含安装与硬件要求文档). https://github.com/MIC-DKFZ/nnUNet
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



