






——Lumerical、Speos、Zemax三大引擎如何覆盖纳米到米级的光学设计?
一、引言:光学仿真的"尺度鸿沟"如何跨越?
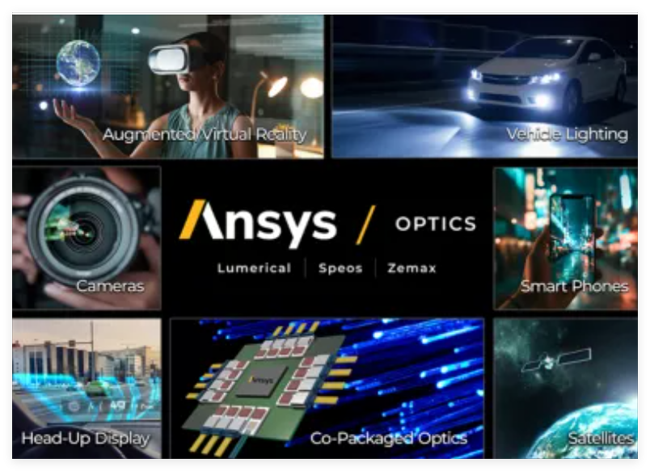
从智能手机摄像头里的纳米级光栅,到汽车前照灯投射的百米级光路,从AR眼镜的微纳波导,到卫星通信的巨型天线——光学产品的设计跨度横跨九个数量级(纳米到米)。传统光学设计工具往往只能覆盖其中一两个尺度,工程师不得不在不同软件之间反复切换、手动转换数据,效率低下且容易出错。
Ansys Optics 的出现,彻底打破了这一"尺度鸿沟"。它将 Lumerical(纳米光子)、Speos(宏观照明/视觉)、Zemax(光学系统设计) 三大引擎整合为统一平台,实现从纳米到米级的端到端光学仿真。2026 R1版本更引入了光学设计交换(ODX)、NEST公差分析、Synopsys OptoCompiler集成等重磅功能,将光学工程的效率推向新高度。
但这份"全栈"能力的背后,是对硬件平台的极致要求——FDTD电磁求解、GPU光线追迹、大规模优化迭代,每一项都在"压榨"算力。本文将从Ansys Optics的模块组成、计算特点、应用场景到硬件配置,为您全面拆解。
二、Ansys Optics 三大核心引擎与六大模块
Ansys Optics 2026 R1 的功能体系围绕 Lumerical、Speos、Zemax 三大引擎展开,覆盖六大核心模块:
引擎一:Ansys Lumerical — 纳米光子与光子集成电路
模块1:FDTD(时域有限差分)—— 纳米光子器件的黄金标准
主要功能:
-
3D电磁全波仿真,求解Maxwell方程组
-
纳米级光栅、超表面、等离子体器件建模
-
周期结构和多层薄膜的RCWA(严格耦合波分析)快速仿真
-
STACK薄膜多层堆叠快速分析
计算特点:
-
显式时间推进:Yee网格离散,时间步长受CFL条件严格限制(Δt ≤ Δx/c·√3)
-
三维网格精细:纳米级特征需亚波长网格(通常λ/10~λ/20),百万至数千万网格点
-
长时仿真:光脉冲传播需大量时间步,总计算量 = 网格数 × 时间步数 × 场分量
-
内存密集型:三维场数据(Ex, Ey, Ez, Hx, Hy, Hz)同时驻留内存,显存/内存是硬瓶颈
应用场景:
-
超表面(Metalens)设计
-
光子晶体
-
纳米光栅
-
太阳能电池陷光结构
-
等离子体传感器
模块2:MODE — 波导与光导器件设计
主要功能:
-
FDE(有限差分本征模):直波导和弯曲波导模式分析
-
varFDTD:平面器件快速仿真(2.5D近似)
-
EME(本征模展开):长器件快速仿真(如定向耦合器、MZI)
计算特点:
-
FDE = 特征值求解:求解截面网格的电磁模式,矩阵规模与网格点数正相关
-
EME = 分段模态叠加:将长器件分段,每段求解模式后通过散射矩阵连接,内存需求低于FDTD但计算复杂度更高
-
varFDTD = 2.5D加速:利用平面近似将3D问题降维,速度提升10-100倍
应用场景:
-
硅光波导
-
光纤耦合器
-
光调制器
-
环形谐振器
模块3:DEVICE — 多物理场器件仿真
主要功能:
-
CHARGE:3D电荷传输求解(半导体器件)
-
HEAT:3D热传递求解
-
FEEM:波导有限元电磁求解
-
MQW:多量子阱求解
-
DGTD:3D电磁有限元求解(间断Galerkin)
计算特点:
-
多物理场耦合迭代:电-热-光三场耦合,需反复求解至自洽
-
半导体方程非线性:泊松方程+连续性方程+载流子输运,Newton-Raphson迭代
-
有限元网格自适应:DGTD支持非结构化网格,复杂几何适应性优于FDTD
应用场景:
-
CMOS图像传感器
-
Micro-LED
-
光电探测器
-
电光调制器
-
SPAD(单光子雪崩探测器)
模块4:INTERCONNECT — 光子集成电路(PIC)系统级仿真
主要功能:
-
经典光子集成电路仿真(时域/频域)
-
量子光子集成电路仿真
-
激光器设计(TWLM行波激光模型)
-
电子-光子协同设计自动化(与Synopsys OptoCompiler集成)
-
铸造厂兼容的PDK设计
计算特点:
-
电路级仿真:基于紧凑模型(Compact Model),计算量远低于器件级FDTD
-
参数化扫描:大量设计点(如耦合系数、波导长度)需批量仿真
-
与Lumerical器件级联动:器件参数自动提取为紧凑模型参数
应用场景:
-
硅光收发器
-
光神经网络
-
量子计算光路
-
激光雷达(LiDAR)芯片
引擎二:Ansys Speos — 宏观光学与人眼视觉
模块5:Speos — 照明系统设计与人类感知仿真
主要功能:
-
照明系统设计与验证(车灯、室内照明、显示屏)
-
真实场景仿真(3D环境、材料光学属性)
-
人眼视觉建模(眩光、视觉舒适度、色彩感知)
-
GPU加速光线追迹
-
多物理场集成(与Mechanical/Fluent耦合)
计算特点:
-
蒙特卡洛光线追迹:从光源发射大量光线(百万至数十亿条),统计光强分布
-
GPU加速核心:NVIDIA CUDA核心并行追迹,速度比CPU提升10-100倍
-
材料BSDF(双向散射分布函数):精确描述表面散射特性,需大量采样
-
人眼视觉后处理:将物理光强转换为感知亮度(如CIE标准),需额外计算
应用场景:
-
汽车前照灯/尾灯设计
-
AR/VR头显光学
-
抬头显示(HUD)
-
室内/建筑照明
-
航空座舱照明
引擎三:Ansys Zemax OpticStudio — 光学系统设计与优化
模块6:OpticStudio — 复杂光学系统设计
主要功能:
-
序列/非序列光线追迹
-
高级优化算法(阻尼最小二乘法、全局优化)
-
公差分析(NEST、蒙特卡洛、灵敏度分析)
-
STAR模块:热-结构-光学(STOP)分析
-
光学设计交换(ODX)与Speos联动
计算特点:
-
序列光线追迹:快速但仅适用于同轴系统,计算量与光线数和表面数成正比
-
非序列光线追迹:支持杂散光、散射、衍射,计算量显著增加
-
优化迭代密集:每次优化需追迹数千至数百万条光线,迭代数百至数千次
-
公差分析 = 海量蒙特卡洛:每个公差变量组合需独立追迹,总计算量爆炸
应用场景:
-
相机镜头设计
-
显微镜/望远镜
-
激光光学系统
-
光刻机照明系统
-
卫星光学载荷
三、Ansys Optics 计算特点总览
表格
| 引擎/模块 | 核心算法 | 计算瓶颈 | 硬件依赖 |
|---|---|---|---|
| Lumerical FDTD | 时域有限差分,显式推进 | 网格规模 × 时间步数 | GPU(CUDA)或CPU多核 + 大内存 |
| Lumerical MODE/FDE | 特征值求解 | 矩阵规模 | CPU核心数 + 内存带宽 |
| Lumerical DEVICE | 有限元/间断Galerkin | 非线性迭代 + 多物理场耦合 | CPU核心数 + 大内存 |
| Lumerical INTERCONNECT | 电路级紧凑模型 | 参数扫描批量计算 | CPU多核并行 |
| Speos | 蒙特卡洛光线追迹 | 光线数量 × 场景复杂度 | GPU(CUDA核心数 + 显存) |
| Zemax OpticStudio | 光线追迹 + 优化迭代 | 优化迭代次数 × 光线数 | CPU高主频 + 多核 |
关键洞察:
-
Lumerical FDTD 和 Speos 是GPU密集型,CUDA核心数和显存容量决定仿真规模
-
Zemax优化 和 Lumerical DEVICE 是CPU密集型,高主频 + 多核 + 大内存是关键
-
多物理场耦合(如STOP分析、电-热-光)需要CPU+GPU协同
四、应用场景:Ansys Optics 的"全栈覆盖"
场景一:AR/VR光学系统(★★★★★)
典型任务: 超表面(Metalens)设计 + 光波导耦合 + 人眼视觉验证
工作流程:
-
Lumerical FDTD设计纳米级超表面光栅
-
MODE设计波导耦合结构
-
INTERCONNECT系统级仿真光路
-
Speos验证人眼视觉体验(MTF、畸变、亮度均匀性)
硬件需求: GPU(FDTD+Speos)+ 大内存(超表面网格精细)+ 高主频CPU(Zemax优化)
场景二:汽车照明与传感器(★★★★★)
典型任务: 前照灯配光设计 + LiDAR光学 + 摄像头杂散光分析
工作流程:
-
Zemax设计镜头组
-
Speos进行整车级照明仿真(配光曲线、眩光评估)
-
Lumerical设计LiDAR芯片级光路
-
ODX交换数据,验证系统级性能
硬件需求: GPU(Speos光线追迹)+ 多核CPU(Zemax优化+公差)
场景三:硅光/光子集成电路(★★★★)
典型任务: 硅光收发器设计 + 激光器优化 + 电子-光子协同
工作流程:
-
Lumerical FDTD/MODE设计器件
-
DEVICE进行电-热-光多物理场仿真
-
INTERCONNECT提取紧凑模型,系统级仿真
-
与Synopsys OptoCompiler联动,生成版图
硬件需求: GPU(FDTD)+ 大内存(DEVICE多物理场)+ 多核CPU(批量参数扫描)
场景四:CMOS图像传感器(★★★★)
典型任务: 像素设计 + 微透镜优化 + 串扰分析 + 暗计数率仿真
工作流程:
-
Lumerical FDTD仿真微透镜聚光效率
-
DEVICE/CHARGE仿真电荷收集与串扰
-
Speos进行摄像头系统级成像验证
硬件需求: GPU(FDTD)+ 大内存(3D像素模型)+ 多核CPU(批量设计点)
场景五:航空航天光学载荷(★★★)
典型任务: 望远镜/相机设计 + 热-结构-光学(STOP)分析 + 杂散光控制
工作流程:
-
Zemax设计光学系统
-
STAR模块导入Mechanical热-结构变形数据
-
优化补偿热致像差
-
Speos/非序列追迹分析杂散光
硬件需求: 多核CPU(Zemax+STAR+优化)+ GPU(Speos杂散光)
五、硬件配置推荐:光学仿真的"算力密码"
基于Ansys Optics三大引擎的不同计算特性,我们推荐以下配置方案:
方案A:Lumerical 纳米光子工作站(推荐配置)
适用场景: FDTD超表面设计、波导器件仿真、纳米光栅优化
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 7950X (16核32线程) | 高主频保障MODE特征值求解 |
| GPU | NVIDIA RTX 5000 Ada 32GB | FDTD GPU加速核心,32GB显存支持千万级网格 |
| 内存 | 128GB DDR5-5600 | FDTD场数据常驻内存,大容量保障 |
| 存储 | 2TB NVMe SSD + 4TB NVMe SSD | 快速加载复杂几何与材料数据 |
| 散热 | CPU双360水冷 + GPU定制水冷 | 持续高负载不降频 |
| 操作系统 | Windows 11 Pro / Linux Ubuntu 22.04 | Lumerical双平台支持 |
预估性能: 超表面模型(500万网格)FDTD仿真约 30-60分钟;MODE波导模式分析 <5分钟。
方案B:Speos 照明/视觉仿真工作站(高性能配置)
适用场景: 汽车照明、AR/VR光学、人眼视觉验证、杂散光分析
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | Intel Core i9-14900K | 高主频保障交互响应 |
| GPU | NVIDIA RTX 6000 Ada 48GB | Speos GPU光线追迹核心,48GB显存支持十亿级光线 |
| 内存 | 128GB DDR5-5600 | 大型场景BSDF数据 + 人眼视觉后处理 |
| 存储 | 2TB NVMe SSD + 8TB NVMe SSD | 大型场景文件(含材料库)可达数十GB |
| 显示器 | 27" 4K IPS × 2 | Speos界面信息密度高,双屏提升效率 |
| 散热 | 双360水冷 + GPU水冷 | 整机满载功耗超600W |
预估性能: 整车前照灯配光仿真(1亿条光线)约 10-20分钟;AR眼镜视觉验证 <5分钟。
方案C:Zemax 光学系统设计工作站(专业配置)
适用场景: 复杂镜头设计、公差分析、STOP热-结构-光学耦合
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核) | 八通道内存,优化迭代并行度高 |
| GPU | NVIDIA RTX 5000 Ada 32GB | 非序列追迹加速 + 可视化 |
| 内存 | 512GB DDR5-4800 ECC | 大规模公差蒙特卡洛需大量内存 |
| 存储 | 2TB NVMe SSD + 8TB NVMe SSD RAID0 | 海量设计点数据 |
| 散热 | 定制分体式水冷(800W+) | 96核满载+GPU持续高负载 |
预估性能: 复杂镜头优化(50面+)约 1-2小时;蒙特卡洛公差分析(5000次)约 4-8小时。
方案D:Ansys Optics 全栈企业级工作站(旗舰配置)
适用场景: Lumerical + Speos + Zemax 全引擎同时使用,多用户并发
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9654 (96核×2 = 192核) | 海量核心支持多引擎并行 |
| GPU | NVIDIA RTX 6000 Ada 48GB × 2 | 双GPU:一卡跑FDTD,一卡跑Speos |
| 内存 | 1TB DDR5-4800 ECC | 全栈仿真内存需求叠加 |
| 存储 | 全闪存阵列 + 16TB NVMe SSD | 高并发I/O |
| 网络 | 双端口100GbE | 团队协作与数据共享 |
| 操作系统 | Windows Server 2022 / Linux | 大内存稳定性 |
预估性能: 支持3-5名光学工程师同时工作,全链路仿真 overnight 完成。
六、配置选型核心建议
1. GPU:光学仿真的"第一优先级"
Ansys Optics中,FDTD和Speos 是GPU加速的核心:
表格
| 指标 | 建议 | 原因 |
|---|---|---|
| 显存容量 | ≥16GB(推荐32GB+) | FDTD三维场数据 + Speos场景数据常驻显存 |
| CUDA核心数 | 越多越好 | 光线追迹和FDTD的并行度与核心数正相关 |
| 专业卡 vs 游戏卡 | 强烈推荐RTX A/Ada系列 | 驱动稳定性、ECC纠错、Ansys官方认证 |
| 双GPU | 可选 | Lumerical和Speos可分别占用不同GPU |
2. CPU:优化与多物理场的"后盾"
-
Zemax优化:高主频(>4.5GHz)减少单次迭代时间
-
Lumerical MODE/DEVICE:多核心加速特征值求解和有限元计算
-
多物理场耦合:高内存带宽(Threadripper PRO八通道、EPYC十二通道)加速数据交换
3. 内存:容量 > 频率
表格
| 仿真类型 | 内存需求估算 |
|---|---|
| FDTD(500万网格) | 32-64GB |
| FDTD(2000万网格) | 128-256GB |
| Speos大型场景 | 64-128GB |
| Zemax公差蒙特卡洛 | 256-512GB |
| 全栈多引擎并发 | 512GB-1TB |
4. 存储:NVMe 是"刚需"
光学仿真项目包含:
-
复杂CAD几何(.step/.iges)
-
材料光学属性库(BSDF、折射率色散数据)
-
仿真结果(场分布、光线数据、图像序列)
大型项目可达 数十至数百GB,NVMe SSD(>3GB/s)是保障效率的基础。
5. 散热:水冷是"标配"
光学仿真通常需要GPU和CPU长时间满载:
-
RTX 6000 Ada 满载约 300W
-
Threadripper PRO 7995WX 满载约 400W
-
整机双满载超 700W
定制水冷系统是保障持续性能、避免降频的必要投资。
七、2026 R1 新功能与硬件协同
表格
| 新功能 | 计算特点 | 硬件需求 |
|---|---|---|
| 光学设计交换(ODX) | Zemax ↔ Speos 数据自动传输 | 高速存储 + 大内存(同时加载两套模型) |
| NEST公差分析 | 嵌套公差蒙特卡洛 | 多核CPU并行 + 大内存 |
| Synopsys OptoCompiler集成 | 电子-光子协同设计 | 多核CPU + 大内存(同时运行Lumerical + OptoCompiler) |
| GPU加速增强 | Speos光线追迹效率提升 | 最新RTX Ada架构GPU |
八、结语:光学仿真的"全栈时代"已来
Ansys Optics 通过 Lumerical + Speos + Zemax 三大引擎的整合,实现了从纳米光子到宏观照明的端到端覆盖。2026 R1版本的ODX、NEST、OptoCompiler集成,更进一步打通了"器件-系统-制造"的全链路。
但这份"全栈"能力的释放,离不开与之匹配的硬件平台:
-
Lumerical FDTD 需要GPU的CUDA核心和显存
-
Speos 需要GPU的光线追迹加速
-
Zemax优化 需要CPU的多核并行和高主频
-
多物理场耦合 需要CPU+GPU的协同
对于从事AR/VR、汽车照明、硅光芯片、CMOS传感器、航空航天光学等领域的企业和科研团队而言,投资一套与Ansys Optics能力匹配的GPU工作站,不是成本,而是缩短光学设计周期、提升产品性能、抢占市场先机的战略必需。
关于UltraLAB
UltraLAB(www.xasun.com)专注于为光学仿真、光子学设计、科学计算等场景提供高性能定制工作站。针对Ansys Lumerical、Speos、Zemax OpticStudio等光学仿真软件,我们提供从GPU选型、CPU配置、内存容量到散热方案的全流程优化服务,确保每一台设备都能"跑满"光学仿真性能。
如需获取针对Ansys Optics的定制化硬件配置方案,欢迎访问UltraLAB官网或致电咨询。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


