






摘要:一套 Zemax 企业授权的价格,足以劝退绝大多数个人工程师、学生和小团队——但不做光学设计的理由从来不是价格。3DOptix、Geopter、Optiland、TorchOptics 等 8 款免费/开源工具,已覆盖从网页端快速验证、序列式成像设计,到"可微分 + AI 反向设计"的前沿玩法。本文深度解析这些工具背后的光线追迹、ABCD 矩阵、傅里叶光学与自动微分算法及其计算特点,并给出从个人设计工作站到 AI 计算光学集群的 UltraLAB 硬件配置方案——软件免费了,算力更要花在刀刃上。
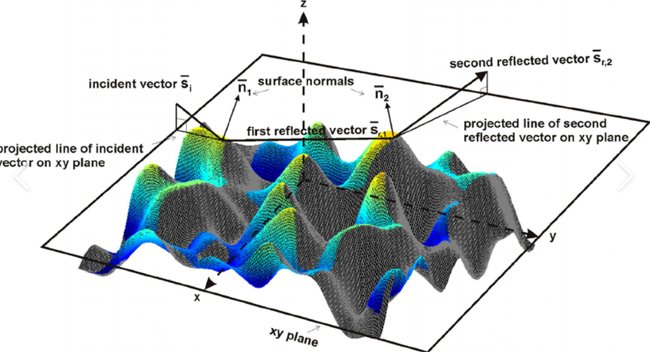
图 1:几何光线追迹——所有光学设计软件的共同内核,也是计算负载的主要来源
本文目录
- 一、核心内容应用分析:Zemax 之外的第三条路
- 二、主要核心算法及其计算特点
- 三、从计算负载到硬件需求的映射逻辑
- 四、UltraLAB 硬件配置怎么选:选型法则与四级方案
- 五、软件清单:免费光学设计全栈工具链
- 六、应用场景:八大工具的实战分工
- 七、大模型本地部署:光学设计的 AI 协作者
- 八、常见问题硬件配置分析(FAQ)
- 九、总结与选型结论
一、核心内容应用分析:Zemax 之外的第三条路
1.1 问题的本质:不是买不起,而是"重资产模式"不适配
做光学设计,Zemax(现 Ansys Zemax OpticStudio)几乎是默认答案。但企业授权的价格,对个人、学生、小团队是一道真实的门槛。原文给出的答案不是"忍一忍买正版",而是第三条路——一条按"上手难度 × 干活能力"分层的免费工具地图:
1.2 两大流派 × 八款工具全景
| 流派 | 工具 | 定位 | 杀手锏 |
|---|---|---|---|
| 网页版/免安装 | 3DOptix | 免费云端光学设计 | 浏览器内 3D 建模+追迹,新手 3 分钟上手,教学演示神器 |
| 网页版/免安装 | LensHH-LT | $385 一次性买断 | 正经序列式设计能力:赛德尔/高阶像差、MTF/PSF、全局优化、读写 Zemax/Code V/OSLO 文件 |
| 网页版/免安装 | WinLens 3D | 老牌免费版 | 光学教育与成像系统预设计(Qioptiq/Excelitas 传承) |
| 开源/Python | Geopter | 开源最像 Zemax 的一个 | GPL-3.0 完全免费,几何追迹+设计+分析+优化 |
| 开源/Python | Optiland | 天生带 AI 基因 | NumPy(CPU)/PyTorch(GPU+自动微分)双后端同接口,可微分追迹直通机器学习 |
| 开源/Python | RayOptics | 老牌成像光学库 | Michael Hayford 出品,导入 .zmx/.seq,Jupyter 友好 |
| 开源/Python | RayTracing | ABCD 矩阵快验证 | 近轴参数秒算,新版 OpenCL GPU 加速百万级光线 |
| 开源/Python | TorchOptics | 可微分傅里叶光学 | PyTorch 自动微分,元件参数当"可学习变量",AI 反向设计入口 |
1.3 三个必须看清的趋势
- 趋势一:文件互通瓦解了生态锁定。 LensHH-LT、RayOptics、Geopter 都能读写 Zemax 文件——免费工具不再是"孤岛",而是可以与商业软件混编的工作流组件。
- 趋势二:可微分化是光学仿真的分水岭。 Optiland/TorchOptics 把光学仿真变成 PyTorch 计算图的一层,梯度可以穿过光学系统回流到结构参数——这是"AI 反向设计"的基础设施。
- 趋势三:免费工具的边界依然清晰。 量产级公差分析、杂散光分析、机械 CAD 联动仍属商业软件领地。"免费做探索 + 商业做量产"是理性分工,硬件配置应按全流程负载规划。
二、主要核心算法及其计算特点
2.1 核心算法全景表
| 算法 | 典型工具 | 数学内核 | 计算特点 |
|---|---|---|---|
| 序列式几何追迹 | Geopter / LensHH-LT / 3DOptix | 折射/反射定律逐面迭代,近轴+实际光线 | CPU 单核频率敏感;多视场多波长组合为外层循环,天然可并行;百万级光线时 GPU 加速收益大 |
| 非序列追迹 | 3DOptix | 蒙特卡洛光线 + 散射模型 | 光线数动辄千万级,GPU 必选;内存带宽敏感 |
| ABCD 矩阵 | RayTracing | 2×2 矩阵连乘(近轴高斯光学) | 极轻量,毫秒级;适合快速验证物像关系与光阑位置,不涉像差 |
| 傅里叶光学传播 | TorchOptics | 角谱法 / 菲涅尔衍射(FFT 核心) | FFT 密集:2048² 复数场单次传播数百毫秒(GPU);支持偏振与部分相干时计算量翻倍 |
| 自动微分(Autograd) | Optiland / TorchOptics | PyTorch 计算图 + 反向传播 | 前向需保存全部中间张量,显存开销为纯前向 2~5 倍;这是可微分光学的第一约束 |
| 优化算法 | Geopter / LensHH-LT / Optiland | 阻尼最小二乘(DLS)、全局搜索、玻璃替换、库存透镜匹配 | 迭代数百至数千次 × 每次全量追迹;CPU 高频或 GPU 可微分双路径 |
| 像差分析 | 全线工具 | 赛德尔系数、泽尼克多项式、MTF/PSF、点列图 | PSF/MTF 需要大量光线采样或 pupil 积分,CPU/GPU 均可 |
| AI 反向设计 | TorchOptics + PyTorch | 损失函数 + 梯度下降,结构剖面参数化 | 数百~数千步迭代 × 每步前向+反向传播;显存决定可设计系统的规模上限 |
| 神经代理模型 | Optiland(自带 ML 教程) | 小型 MLP/CNN 替代耗时追迹 | 训练吃 GPU,推理毫秒级;需先生成数万样本数据集 |
2.2 计算特点深度剖析
(1)光线追迹的"尴尬的并行性"
每条光线的追迹完全独立——这是教科书级的embarrassingly parallel负载。传统 CPU 实现受限于单核频率与多线程扩展;RayTracing 新版加入 OpenCL GPU 加速后,百万级光线从分钟级压到秒级。结论:交互式设计吃高频 CPU,批量分析/蒙特卡洛吃 GPU。
(2)可微分光学的"显存税"
自动微分的代价是计算图存储:一次前向传播的每个中间张量都要保留到反向传播结束。实测经验:可微分仿真的显存占用 ≈ 纯前向的 2~5 倍。2048×2048 的复数光场经过 10 个传播面,仅计算图就可能占用数 GB 显存。这是 48GB 成为 AI 光学入门线、96GB 成为研究标配的根本原因。
(3)优化迭代的"万次追迹"
无论 DLS 还是梯度下降,优化 = 数百至数千次完整系统求值。CPU 路径(Geopter/LensHH-LT)靠高频缩短单次求值;GPU 路径(Optiland)靠并行同时求多个结构变体——两条路径对硬件的诉求截然不同,混合工作流需二者兼顾。
(4)傅里叶光学的分辨率-显存双膨胀
角谱法的精度由采样网格决定:网格加倍 → 内存 ×4、FFT 时间 ×4。模拟大口径衍射光学元件(DOE)时,2048² 只是起步。再叠加偏振(Jones 矩阵×2)、部分相干(多光谱采样)、3D 显示(多视角),显存与算力需求呈组合爆炸。
图 3:算法微分驱动的超光学反向设计——正向传播与反向传播的闭环让"AI 长出光学结构"成为可能三、从计算负载到硬件需求的映射逻辑
| 计算负载特征 | 对应硬件诉求 | 推荐规格方向 |
|---|---|---|
| 交互式序列追迹 | 极限高主频 CPU | 5.0GHz+ 全核,工业级水冷 |
| 蒙特卡洛/非序列追迹 | GPU 吞吐 + 内存带宽 | 24~48GB 显存,多光线并行 |
| 傅里叶光学 FFT | GPU 算力 + 显存容量 | 48GB 起步,2048² 网格从容 |
| 可微分计算图 | 大显存(2~5×前向开销) | 48~96GB |
| 优化迭代万次求值 | 高频 CPU 或 GPU 并行 | 高频多核 + GPU 异构 |
| AI 反向设计数千步训练 | GPU 算力 + 显存 + NVMe checkpoint | 96GB + Gen5 |
| 神经代理模型数据集生成 | 批量追迹 + 高速存储 | 32~64 核 + NVMe |
| 3D 可视化交互 | GPU 图形 + 显存 | 专业显卡或游戏卡均可 |
四、UltraLAB 硬件配置怎么选:选型法则与四级方案
4.1 选型黄金法则(工具链 → 算法路径 → 硬件的专业匹配)
- 交互吃频率,批量吃 GPU:手动调结构的追迹体验由 CPU 主频决定;蒙特卡洛、批量公差抽样、数据集生成交给 GPU。
- 可微分场景显存翻倍规划:按"纯前向显存 × 3"估算可微分需求,反向设计直接 96GB 起步。
- 傅里叶光学按网格规模选卡:1024² 网格 24GB 可跑,2048² 建议 48GB,4096² 或多物理场叠加建议 96GB。
- 优化迭代双路并行:CPU 路径(Geopter/Optiland NumPy 后端)配高频多核,GPU 路径(Optiland/TorchOptics)配大显存,异构平台两头兼顾。
- 开源工具链吃磁盘:多版本 Python 环境、Zemax 文件库、ML 数据集与 checkpoint,NVMe 容量按 2TB 起步规划。
4.2 UltraLAB 四级配置方案(2026 版)
方案 A:光学设计入门 / 教学工作站(预算 2~5 万)
适合:学生、高校教学、3DOptix/WinLens 网页工具 + 轻量 Python 验证。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB AX400 / A350 | 超频便携/台式工作站 |
| CPU | Intel Ultra7 265K(20核 5.1GHz) | 高频保障交互式追迹流畅 |
| GPU | RTX 5060Ti 16GB | RayTracing GPU 加速 + 7B 模型 |
| 内存 | 64~128GB DDR5 | 多波长多视场组合分析 |
| 存储 | 2TB NVMe Gen4 + 4TB HDD | 环境与文件库 |
| 特色 | 预装 Python 光学栈(Optiland/RayOptics/RayTracing) | 开箱即用的开源光学环境 |
方案 B:个人工程师 / 小团队设计工作站(预算 5~12 万)
适合:LensHH-LT/Geopter 正经成像设计,含 .zmx 文件兼容工作流。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB GR450P | 撕裂者超频平台 |
| CPU | AMD 撕裂者 7980X(64核 5.0GHz) | 高频交互 + 多核批量优化并行 |
| GPU | RTX Pro 5000 48GB | 蒙特卡洛追迹 + 32B 模型 + 傅里叶入门 |
| 内存 | 192~256GB DDR5 ECC | 大系统(30+ 面)优化矩阵常驻 |
| 存储 | 4TB NVMe Gen5 + 16TB HDD | 设计库 + 历史版本 + 数据集 |
| 网络 | 万兆以太网 | 团队共享设计文件 |
方案 C:AI 计算光学研究工作站(预算 12~30 万)
适合:Optiland/TorchOptics 可微分仿真、AI 反向设计、超透镜/DOE 研究。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB AE450 / CX390 | 旗舰科研级平台 |
| CPU | AMD EPYC 9275F(24核 4.5GHz) | 高频驱动 Python 调度与数据集生成 |
| GPU | RTX Pro 6000 96GB |
可微分计算图 2 |
| 内存 | 384~512GB DDR5 ECC | 代理模型训练数据常驻 |
| 存储 | 8TB NVMe Gen5 + 30TB 数据盘 | checkpoint 秒存 + 大规模样本库 |
| 特色 | 预装 PyTorch + CUDA + Optiland/TorchOptics 优化环境 | 可微分光学开箱即用 |
方案 D:计算光学团队平台 / 集群(预算 30 万~200 万)
适合:光学实验室、企业研发中心、多用户反向设计训练平台。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB EX660 / CT400 集群 | 双路服务器 + 多机分布式 |
| CPU | 2× AMD EPYC 9755(256 核) | 批量公差抽样 + 超大数据集生成 |
| GPU | 4~8× RTX Pro 6000 96GB(NVLink) | 多用户反向设计 + 神经代理模型训练 + 大模型服务池 |
| 内存 | 1~2TB DDR5-4800 | 多任务并行缓存池 |
| 存储 | 100TB+ 全闪存阵列 | 设计库 + 样本库 + 模型仓库统一底座 |
| 网络 | 200Gb InfiniBand | 多节点梯度同步 |
| 软件栈 | JupyterHub + SLURM + W&B | 多用户实验管理与追踪 |
五、软件清单:免费光学设计全栈工具链
5.1 光学设计与仿真(原文八大工具)
| 软件 | 类型 | 核心能力 | 硬件需求要点 |
|---|---|---|---|
| 3DOptix | 云端网页 | 3D 建模 + 追迹 + 扩束器/成像系统 | 浏览器即可,复杂系统吃本地网络 |
| LensHH-LT | 买断制 | 序列设计 + 像差/MTF/PSF + 全局优化 + 文件互通 | 高主频 CPU |
| WinLens 3D | 免费版 | 教学 + 预设计 | 轻量 |
| Geopter | 开源 GPL-3.0 | 追迹 + 设计 + 分析 + 优化(最像 Zemax) | 高主频 CPU |
| Optiland | Python 库 | 双后端(NumPy/PyTorch),可微分 + 公差 + 优化 | CPU 或 GPU 可微分 |
| RayOptics | Python 库 | 成像光学 + .zmx/.seq 导入 | 高主频 CPU |
| RayTracing | Python 库 | ABCD 矩阵 + OpenCL GPU 百万光线 | 入门 GPU 即可 |
| TorchOptics | Python 库 | 可微分傅里叶光学 + 偏振 + 全息 + DOE | 大显存 GPU |
5.2 AI 框架与科学计算底座
| 工具 | 核心能力 | 硬件需求要点 |
|---|---|---|
| PyTorch + CUDA | 自动微分 + GPU 加速 | GPU 必备 |
| JAX | 高阶自动微分 + XLA 编译 | GPU,学术圈另一主流 |
| NumPy / SciPy | CPU 数值计算底座 | 高主频 + AVX-512 |
| Matplotlib / Plotly | 点列图/MTF 可视化 | 轻量 |
| Jupyter Lab | 交互式研究工作流 | 高频 CPU |
5.3 大模型与效率工具
| 工具 | 核心能力 | 硬件需求要点 |
|---|---|---|
| Ollama / vLLM | 本地 LLM 推理服务 | 16~96GB 显存 |
| LangChain / LlamaIndex | 光学知识库 RAG、工具调用链 | 高频 CPU + 大内存 |
| Continue.dev / Cline | IDE 内 AI 代码助手(写 Optiland 代码) | 轻量 |
| Dify | 光学设计 Agent 低代码编排 | 全栈容器化 |
| Git + DVC | 设计文件版本管理 + 数据集版本化 | NVMe I/O |
六、应用场景:八大工具的实战分工
| 应用场景 | 推荐工具 | 算法内核 | 硬件配置 |
|---|---|---|---|
| 课堂演示 / 快速验证想法 | 3DOptix | 网页 3D 追迹 | 普通电脑 + 好网络 |
| 正经成像系统设计(个人) | LensHH-LT / Geopter | 序列追迹 + DLS 优化 | A/B |
| 激光扩束/光路快速核算 | RayTracing | ABCD 矩阵 | A(GPU 加速可选) |
| 存量 Zemax 文件继续开发 | LensHH-LT / RayOptics | 文件互通 + 追迹 | B |
| 衍射光学元件(DOE/全息) | TorchOptics | 角谱 FFT 传播 | C |
| 超透镜/超表面反向设计 | TorchOptics + PyTorch | 可微分 + 梯度下降 | C/D |
| 光学系统神经代理模型 | Optiland(ML 教程) | MLP/CNN 替代追迹 | C |
| 公差/蒙特卡洛批量分析 | Optiland / Geopter | 并行抽样 | B/C/D |
| 量产级公差/杂散光 | 商业软件(Zemax/CODE V) | —— | 按商业软件授权配套 |
七、大模型本地部署:光学设计的 AI 协作者
7.1 为什么光学工程师是本地大模型的天然用户
原文点出 Optiland"天生带 AI 基因"——而这种基因要真正发芽,离不开本地大模型的三个刚需场景:
- 光学代码助手:直接对 LLM 说"用 Optiland 搭一个双高斯物镜并优化 MTF",自动生成可运行的 Python 代码——把 API 文档学习成本压到零;
- 数据主权:军工、航天光学设计文件属保密范畴,涉密项目的设计思路与代码不出内网是硬底线;
- "LLM 提初值 + 梯度精修"混合范式:LLM 依据光学设计经验法则给出初始结构,可微分仿真做梯度精修——大模型与 TorchOptics 的组合拳必须本地同机部署才能闭环。
7.2 显存是第一生产力:模型权重占用估算
| 模型规模 | FP16 权重 | INT8 权重 | INT4 权重 | 光学典型用途 | 推荐显存 |
|---|---|---|---|---|---|
| 7B | ≈14 GB | ≈7 GB | ≈4 GB | 公式问答、单行代码补全 | 16~32 GB |
| 14B | ≈28 GB | ≈14 GB | ≈7 GB | Optiland/RayOptics 代码生成 | 32 GB |
| 32B | ≈64 GB | ≈32 GB | ≈16 GB | 多文件工程级代码 + 文献综述 | 48~96 GB |
| 70B | ≈140 GB | ≈70 GB | ≈35 GB | 复杂 Agent:检索专利库+生成设计报告 | 96 GB 或多卡 |
7.3 光学团队的典型本地部署场景
| 场景 | 模型规模 | UltraLAB 推荐 |
|---|---|---|
| 个人光学代码助手 | 7B~14B | 方案 A(16~32GB 显存) |
| 课题组共享 AI + 设计平台 | 14B~32B | 方案 B/C(48GB 显存) |
| 涉密项目全本地闭环(LLM+可微分仿真) | 32B~70B | 方案 C(96GB 显存) |
| 多用户 AI 设计平台 + 反向设计训练 | 全参数微调 | 方案 D(多卡 NVLink) |
八、常见问题硬件配置分析(FAQ)
Q1:光线追迹到底吃 CPU 还是 GPU?
分场景:交互式序列追迹(拖动透镜实时看光路)由 CPU 单核频率决定,5.0GHz 高频的体感远优于低频多核;批量负载(蒙特卡洛公差、百万级非序列光线、代理模型数据集生成)光线间天然独立,RayTracing 的 OpenCL GPU 加速可提速数十倍。结论:高频 CPU + GPU 异构,两者不是替代关系。
Q2:可微分光学仿真为什么特别吃显存?
自动微分的机制决定了它必须在前向传播时保存整个计算图的每个中间张量,直到反向传播完成。实测可微分仿真的显存占用约为纯前向的 2~5 倍:2048×2048 复数光场经 10 个传播面,计算图本身就可能占数 GB。叠加偏振与多波长采样后更夸张——48GB 是可微分光学入门线,96GB 是研究标配。
Q3:免费/开源工具与 Zemax 的差距在哪里?
三件事仍是商业软件更稳:量产级公差分析(蒙特卡洛 + 灵敏度矩阵的工程化程度)、杂散光分析(非序列 + 散射模型的完备性)、机械 CAD 联动(热-力-光一体化)。免费工具的定位是设计验证、教学、前期探索与 AI 实验。建议:探索期用免费工具跑通方案,量产期再上商业软件做收口——硬件平台两者通吃。
Q4:学生/个人入门怎么花最少的钱?
方案 A 起步(2~5 万):高频 20 核 CPU + 16GB 显存 + 128GB 内存。软件全部免费——3DOptix 做概念验证、RayTracing 算光路、Optiland 跑正经设计、Ollama 本地跑 7B 代码助手。避开两个误区:不必为上不着的商业授权先配"保险"硬件;也不必买双卡——单卡 16GB 足够入门全流程。
Q5:傅里叶光学仿真该按什么选显卡?
按采样网格定:1024² 网格 24GB 显存可跑单波长;2048² 建议 48GB(精度与 DOE 口径直接相关);4096² 或叠加偏振/部分相干/多波长建议 96GB。角谱法的内存开销随网格平方增长,选卡前先估算目标器件的最小特征尺寸与口径之比。
Q6:大模型在光学设计中的实际价值是什么?
三个已被验证的价值:① 代码生成——"用 TorchOptics 模拟贝塞尔光束经轴棱锥传播"一句话出代码;② 文献/专利调研加速——本地论文库问答 + 综述草稿;③ 混合设计范式——LLM 凭经验法则给初始结构,梯度优化精修。7B14B 模型 + 1632GB 显存即可流畅运行,是光学工程师性价比最高的效率投资。
Q7:为什么需要 NVMe Gen5?SATA SSD 不够吗?
优化迭代与反向设计训练会反复读写 checkpoint 与样本数据——数千步迭代 × 每步数百 MB 的读写,SATA SSD(500MB/s)会成为隐形瓶颈拖长每一步。NVMe Gen5(14GB/s)把 I/O 等待压到可忽略。对只做交互设计的人 Gen4 足够,做 AI 反向设计的人 Gen5 是刚需。
Q8:开源工具链的环境配置有什么坑?
主要是依赖冲突:Optiland(PyTorch 后端)与 RayOptics(Qt GUI)对 NumPy/Qt 版本要求不同;TorchOptics 对 PyTorch 版本敏感。建议:① 用 conda/uv 建独立环境;② UltraLAB 预装环境已做版本锁定与兼容性测试,可避免"装环境三天,跑仿真三分钟";③ 大项目用 Docker 固化环境,换机秒级恢复。
九、总结与选型结论
Zemax 的价格壁垒正在被两条线瓦解:一条是 LensHH-LT 这类"白菜价正版",一条是 Optiland/TorchOptics 这类"开源 + 可微分 + AI"的新物种。当光学仿真成为 PyTorch 计算图的一层,设计的边界从"人调参数"扩展到"AI 反向生长结构"——而这条新赛道没有沉重的授权费,只有对算力的真实渴望。软件已经免费,让每一分硬件预算都花在刀刃上。
UltraLAB 选型速查
| 你的需求 | 推荐方案 | 关键配置 |
|---|---|---|
| 学生 / 教学 / 快速验证 | 方案 A(2~5 万) | 高频 20 核 + 16GB 显存 + 128GB 内存 |
| 个人/小团队正经成像设计 | 方案 B(5~12 万) | 64 核 5.0GHz + 48GB 显存 + 256GB ECC |
| AI 反向设计 / 可微分傅里叶光学 | 方案 C(12~30 万) | 高频霄龙 + RTX Pro 6000 96GB + 512GB ECC |
| 多用户计算光学平台 / 训练集群 | 方案 D(30 万+) | 双路 EPYC + 多卡 NVLink + 1TB 内存 + 全闪阵列 |
一步到位的建议:按"最大追迹规模 × 可微分网格上限 × 团队并发数"三维匹配一次选对。UltraLAB 可针对您的工具链(Geopter/Optiland/TorchOptics 等)、目标器件类型与预算,对 CPU、GPU、内存、存储进行定制化设计,并预装经兼容性测试的开源光学软件栈,提供真实设计案例的上线前验证。
参考文献
- 《买不起 Zemax?这 8 款免费光学设计软件照样能干》,OpticsKit(光学科技资讯)
- Optiland Documentation(optiland.readthedocs.io)
- TorchOptics: Differentiable Fourier optics in PyTorch(github.com/facebookresearch/TorchOptics)
- RayOptics: Python geometric optics / imaging optics(github.com/mjhoptics/ray-optics)
- RayTracing: ABCD matrix optical propagation with OpenCL acceleration(github.com/DCC-Lab/RayTracing)
- Geopter: Open-source optical design software(github.com/geopter/geopter)
- 3DOptix 官方博客:Ray Tracing Techniques in Optical Simulation Software
- Inverse design and flexible parameterization of meta-optics using algorithmic differentiation, Communications Physics, 2021
关于 UltraLAB:UltraLAB(西安坤隆计算机科技有限公司)是国内知名高端定制图形工作站厂家,面向光学设计、计算光学、光子学、人工智能等领域提供"工具链→算法路径→硬件"精准匹配的专业计算平台,支持预装开源软件栈与多机集群交付。
本文基于公开技术资料与开源社区信息整理,硬件配置参数以 UltraLAB 官方最新方案为准。技术咨询:400-705-6800。


