






title: "CMG油藏模拟软件:基于AI的高效模拟技术与大模型本地部署——UltraLAB硬件配置全指南"
description: "深度解析CMG油藏模拟软件家族(IMEX/GEM/STARS/CMOST AI)的AI加速技术、GPU并行求解能力及大模型本地部署方案,提供UltraLAB图形工作站硬件配置推荐与常见问题分析。"
keywords: "CMG,油藏模拟,IMEX,GEM,STARS,CMOST AI,GPU加速,大模型本地部署,UltraLAB,图形工作站,油藏数值模拟"
author: "UltraLAB技术团队"
date: "2026-07-28"
category: "油藏模拟与AI计算"
CMG油藏模拟软件:基于AI的高效模拟技术与大模型本地部署——UltraLAB硬件配置全指南
当千万级网格的组分模拟遇上AI驱动的智能历史拟合,当CO₂封存的地质化学耦合需要GPU加速求解——CMG软件家族正以CMOST AI、AUTOTUNE AI和GPU并行求解器重新定义油藏模拟的效率边界。本文基于 learncmg.cn 技术社区最新实践,系统梳理CMG九大核心模块的AI能力、GEM GPU加速机制,以及面向大模型本地部署的UltraLAB硬件配置方案。
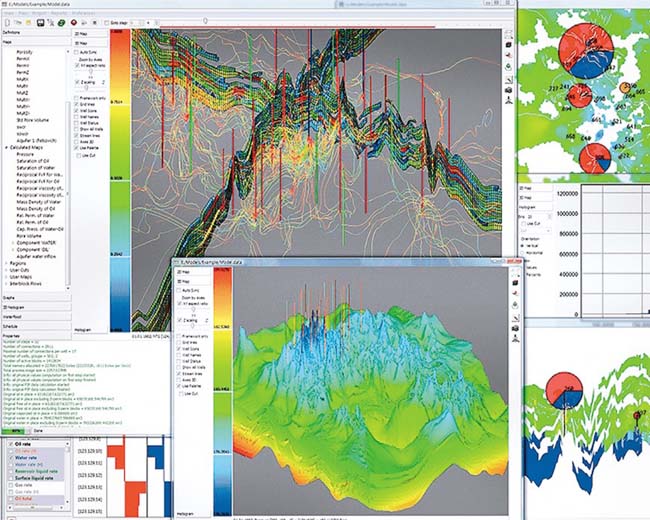
一、CMG软件家族全景:从黑油到AI驱动的智能模拟
 图1:CMG软件家族全栈架构——覆盖从地质建模到AI优化的完整油藏模拟工作流
Computer Modelling Group(CMG)是全球油藏数值模拟领域的标杆企业,其软件产品覆盖从常规黑油模拟到复杂EOR(提高采收率)热采、从CO₂封存到智能优化决策的完整技术链条。
1.1 三大核心求解器
| 求解器 | 定位 | 核心算法 | 适用场景 | GPU支持 |
|---|---|---|---|---|
| IMEX | 黑油/扩展黑油模拟器 | 有限差分法 + 隐式/显式自适应时间步进 | 常规油藏衰竭开发、水驱、气驱、非常规油气(页岩气/致密油) | ❌ 不支持 |
| GEM | 组分/状态方程模拟器 | 有限差分法 + EOS(Peng-Robinson/SRK)+ 牛顿迭代 | 凝析气藏、挥发性油藏、CO₂-EOR、CCS封存、化学驱 | ✅ 单GPU加速(多GPU开发中) |
| STARS | 热采与化学驱模拟器 | 有限差分法 + 全耦合质量/能量守恒方程 | SAGD、蒸汽吞吐、火烧油层、化学驱(聚合物/表面活性剂/碱驱) | ❌ 不支持 |
技术要点:GEM作为CMG最先进的组分模拟器,已支持NVIDIA GPU单卡加速,无需额外许可证即可启用。对于涉及CO₂封存、化学EOR等千万级网格的复杂组分模型,GPU加速可显著缩短线性求解时间。
1.2 六大支撑模块
| 模块 | 功能定位 | AI/智能特性 | 计算特点 |
|---|---|---|---|
| Builder | 交互式前处理与模型构建 | 水力压裂向导、Process Wizard流程引导 | 大模型加载优化、3D可视化响应速度依赖GPU |
| Results | 后处理与可视化分析 | 自动化报告生成、SR3快速加载格式 | 大显存GPU利于三维体渲染与千万网格实时剖切 |
| WinProp | PVT相态与流体建模 | 自动参数回归、差分进化算法计算MMP | 中等计算量,CPU单核/多核即可 |
| CMOST AI | 智能优化与不确定性分析 | RBF神经网络、PSO粒子群、DE差分进化、CMGDECE | 大规模并行计算,可同时提交数百个模拟作业 |
| CoFlow | 油藏-井筒-管网耦合 | 稳态/瞬态流动保障分析 | 耦合迭代求解,内存需求高 |
| LedaFlow | 瞬态多相流模拟 | 段塞追踪、关井动态分析 | 时间步进密集,CPU多核并行 |
二、CMG的AI技术内核:从AUTOTUNE到CMOST智能优化
 图2:CMOST AI智能优化闭环——将机器学习、统计分析与油藏工程专家经验深度融合
2.1 AUTOTUNE AI:自适应时间步智能控制
AUTOTUNE AI是CMG内置的基于人工智能的自适应时间步控制技术,仅需一个关键词(ADTSC)即可自动应用最优数值设置:
- 核心算法:AI驱动的自适应时间步长控制,动态平衡精度、稳定性与速度
- 性能提升:相比传统固定设置,平均提速3倍;在蒸汽驱等大型热采模型中,用户实测从19–20分钟缩短至7分钟
- 适用求解器:IMEX、GEM、STARS全系列支持
2.2 CMOST AI:油藏模拟的"智能大脑"
CMOST AI是CMG软件家族中最具AI基因的核心模块,将统计分析、机器学习(RBF神经网络)与无偏数据解释相结合:
| 功能模块 | AI算法/技术 | 业务价值 |
|---|---|---|
| 敏感性分析 | RBF径向基函数网络 + 实验设计(DoE) | 自动识别关键不确定性参数,量化各参数对产量的影响权重 |
| 智能历史拟合 | 高级统计方法 + 多引擎联合优化(PSO/DE/CMGDECE) | 以最少模拟次数实现最优拟合,解决传统试错法耗时难题 |
| 方案优化 | 多目标优化算法 + 代理模型(Surrogate Model) | 自动搜索最佳开发方案,最大化NPV与采收率 |
| 不确定性分析 | 蒙特卡洛模拟 + 后验概率密度(CMGPAR) | 生成多个历史拟合模型进行预测集合,降低决策风险 |
| 自动鲁棒优化 | 鲁棒优化工作流 + 多场景评估 | 提高开发方案成功率,降低地质不确定性带来的风险 |
实战案例:在二叠纪页岩油田CO₂-EOR优化研究中,研究者利用CMG-GEM结合CMOST AI进行迭代历史拟合与裂缝模型验证,通过快速遗传算法优化NPV,实现了从细管MMP估算到全油田周期注入策略的闭环优化。
三、GPU加速:GEM求解器的并行革命
3.1 GEM GPU加速技术解析
CMG GEM是目前家族中唯一原生支持NVIDIA GPU加速的求解器,其加速核心在于GPU线性求解器对大规模稀疏矩阵方程组的并行求解:
| 技术项 | 规格说明 |
|---|---|
| 支持架构 | NVIDIA CUDA(计算能力≥3.5,Pascal架构及以上) |
| 加速模式 | 单GPU per run(当前版本);多GPU支持开发中 |
| 许可证 | 无需单独GPU许可证,标准GEM许可即可启用 |
| 适用模型 | EOS组分模型、CO₂封存、化学EOR等复杂千万级网格模型 |
| 加速环节 | 线性方程组求解(Jacobian矩阵分解与回代) |
3.2 为什么GPU对CMG至关重要?
油藏模拟的数学本质是求解大规模非线性偏微分方程组离散化后的大型稀疏线性系统。对于GEM组分模型:
- Jacobian矩阵规模:每个网格块含多组分质量守恒方程 + 能量方程,千万级网格的Jacobian矩阵可达数亿阶
- 计算瓶颈:牛顿迭代中每次线性求解占整体运行时间的60%–80%
- GPU优势:稀疏矩阵-向量乘法、ILU预处理等操作具有高度数据并行性,GPU的众核架构可发挥极致效率
 图3:GEM GPU加速架构——CPU负责逻辑控制与牛顿迭代,GPU专注稀疏线性代数运算
四、应用场景:CMG + AI + GPU能解决什么?
| 应用场景 | 核心软件 | AI价值 | GPU价值 | 典型规模 |
|---|---|---|---|---|
| CO₂地质封存与CCS | GEM + WinProp + CMOST AI | CMOST AI优化注入策略,AUTOTUNE加速长期模拟 | GEM GPU加速千万网格组分-地球化学耦合模拟 | 500万–3000万网格,模拟期100年+ |
| 致密油/页岩气开发 | IMEX/GEM + Builder + CMOST AI | 智能历史拟合校准裂缝参数,优化井距/缝间距 | GEM GPU加速EDFM(嵌入式离散裂缝模型) | 100万–1000万网格,多段压裂水平井 |
| SAGD热采优化 | STARS + CMOST AI | 多目标优化蒸汽注入参数,预测沥青沉积风险 | — | 50万–500万网格,25对井以上 |
| 化学驱(ASP/聚合物/表面活性剂) | STARS/GEM + WinProp + CMOST AI | 优化化学剂浓度与段塞设计,快速遗传算法提升NPV | GEM GPU加速组分-化学耦合 | 100万–1000万网格 |
| 天然气水合物开发 | GEM + Builder | — | GEM GPU加速3D EDFM水合物储层模拟 | 复杂裂缝网络 + 相变耦合 |
| 纳米流体提高采收率 | STARS + CMOST AI | 敏感性分析确定最优纳米颗粒浓度与注入策略 | — | 岩心尺度到油藏尺度多尺度模拟 |
| 电磁加热采油(EOR) | STARS | — | — | 耦合微波能量传递与多相流 |
五、UltraLAB硬件配置推荐
 图4:UltraLAB CMG油藏模拟工作站——专为千万级网格AI驱动油藏模拟设计的算力平台
5.1 配置选型矩阵
| 配置等级 | 入门级 | 专业级 | 旗舰级 | 集群级 |
|---|---|---|---|---|
| 定位 |
常规黑油模拟 中小模型历史拟合 |
组分模拟/GEM GPU CMOST AI批量优化 |
千万网格热采/EOR CO₂封存全耦合 |
多用户并行 CMOST AI数百任务并发 |
| CPU |
Intel Xeon W7-3465X 28核 2.5GHz |
AMD Threadripper PRO 7995WX 96核 2.5GHz |
双路 AMD EPYC 9655 192核 2.4GHz |
双路 AMD EPYC 9755 256核 2.7GHz |
| 内存 | 128GB DDR5 ECC | 256GB DDR5 ECC | 512GB DDR5 ECC | 1TB DDR5 ECC |
| GPU |
NVIDIA RTX 4000 Ada 20GB ×1 |
NVIDIA RTX Pro 6000 96GB ×2 |
NVIDIA RTX Pro 6000 96GB ×4 (NVLink) |
NVIDIA H100 80GB ×8 (NVLink + InfiniBand) |
| 系统盘 | 2TB NVMe Gen4 SSD | 4TB NVMe Gen5 SSD | 2×4TB NVMe Gen5 SSD (RAID 0) | 2×7.68TB NVMe Gen5 SSD |
| 数据盘 | 8TB SATA HDD | 2×8TB NVMe SSD | 4×16TB NVMe SSD | 并行存储阵列 100TB+ |
| 网络 | 双千兆网卡 | 双万兆以太网 | 双万兆 + InfiniBand HDR | InfiniBand NDR 400G |
| 操作系统 | Windows 11 Pro / Linux | Windows 11 Pro / Linux | Linux (Rocky/Alma/RHEL) | Linux + Slurm调度 |
| 预估预算 | 5–8万元 | 18–28万元 | 45–65万元 | 150万元+ |
5.2 按业务场景的精准配置
| 业务场景 | 推荐配置 | 关键硬件决策 |
|---|---|---|
| 常规黑油模拟(IMEX) |
UltraLAB EX620i Xeon W7-3465X / 128GB / RTX 4000 Ada |
CPU高频优先(IMEX对单核性能敏感),内存128GB足够应对500万网格级模型 |
| 组分模拟 + GPU加速(GEM) |
UltraLAB GX960 TR PRO 7995WX / 256GB / RTX Pro 6000 96GB ×2 |
显存≥48GB(复杂EOS模型Jacobian矩阵大),双卡可分别跑不同模型 |
| 热采模拟(STARS) |
UltraLAB DX1280 双路EPYC 9655 / 512GB / RTX Pro 6000 96GB ×2 |
STARS不支持GPU,CPU核数与内存容量是关键;热采模型时间步进密集,多核并行收益高 |
| CMOST AI批量优化 |
UltraLAB CX2560 双路EPYC 9755 / 1TB / RTX Pro 6000 ×4 |
CMOST可同时提交数百个模拟作业,需要超多核CPU + 大内存 + 多GPU并发 |
| CO₂封存全耦合(GEM+地球化学) |
UltraLAB GX960 TR PRO 7995WX / 512GB / RTX Pro 6000 96GB ×4 |
GEM GPU加速 + 大内存(地球化学耦合模型内存占用翻倍),NVLink互联提升多卡效率 |
| 大模型可视化(Results) |
UltraLAB EX620i Xeon W9-3495X / 256GB / RTX Pro 6000 96GB |
Results模块三维渲染依赖OpenGL与大显存,96GB显存可流畅加载千万网格SR3结果文件 |
六、预装软件清单(开机即用)
| 类别 | 软件名称 | 版本/说明 | 用途 |
|---|---|---|---|
| CMG核心套件 | CMG IMEX | 最新版 | 黑油/扩展黑油模拟 |
| CMG GEM | 最新版(含GPU模块) | 组分/EOS模拟 | |
| CMG STARS | 最新版 | 热采与化学驱模拟 | |
| CMG Builder | 最新版 | 前处理与模型构建 | |
| CMG Results | 最新版 | 后处理与可视化 | |
| CMG工具模块 | CMG WinProp | 最新版 | PVT相态建模 |
| CMG CMOST AI | 最新版 | 智能优化与不确定性分析 | |
| CMG耦合模块 | CMG CoFlow | 最新版 | 油藏-井筒-管网耦合 |
| CMG LedaFlow | 最新版 | 瞬态多相流模拟 | |
| AI/ML框架 | Python + Anaconda | 3.11+ | CMOST AI脚本扩展、自定义代理模型 |
| TensorFlow / PyTorch | GPU版本 | 深度学习代理模型训练 | |
| Jupyter Lab | 最新版 | 交互式数据分析与可视化 | |
| 开发工具 | Microsoft Visual Studio | 2022 Community | CMG二次开发与接口编程 |
| Git | 最新版 | 版本控制 | |
| Intel oneAPI | 最新版 | MKL数学库、OpenMP优化 | |
| 系统与驱动 | NVIDIA CUDA Toolkit | 12.x | GEM GPU加速运行环境 |
| NVIDIA GPU驱动 | 最新稳定版 | GPU运算与图形渲染 |
七、常见问题硬件配置分析
Q1:CMG GEM的GPU加速需要什么样的显卡?A100和RTX游戏卡有什么区别?
| 对比项 | NVIDIA RTX Pro 6000 96GB | NVIDIA A100 80GB | NVIDIA RTX 4090 24GB |
|---|---|---|---|
| 显存容量 | 96GB GDDR6 ECC | 80GB HBM2e ECC | 24GB GDDR6X |
| FP64双精度 | ~2.0 TFLOPS | 9.7 TFLOPS | ~0.08 TFLOPS |
| 适用模型 | 千万网格复杂组分模型 | 超大规模科学计算 | 中小模型(显存受限) |
| CMG GEM兼容性 | ✅ 完美支持 | ✅ 支持 | ⚠️ 显存可能不足 |
| 性价比 | ★★★★☆ | ★★★☆☆ | ★★★★★(仅限小模型) |
| UltraLAB推荐 | 首选(大显存+ECC+专业驱动) | 数据中心级部署 | 不推荐用于生产级GEM模拟 |
结论:对于CMG GEM GPU加速,显存容量是第一硬指标。复杂EOS模型的Jacobian矩阵在千万网格级别可轻松占用20–40GB显存,24GB显存会在中等规模模型上触发内存溢出。RTX Pro 6000 96GB凭借超大显存与ECC纠错,是当前CMG GEM GPU加速的最佳工作站级选择。
Q2:STARS热采模拟为什么不支持GPU?该如何配置硬件?
STARS求解的是全耦合质量-能量守恒方程组,涉及复杂的相变潜热、化学反应动力学和温度-压力强耦合。其Jacobian矩阵的结构和条件数与GEM的等温组分模型差异显著,当前版本尚未实现GPU线性求解器。
STARS硬件配置要点:
- CPU:选择高主频、多核心的处理器(如AMD Threadripper PRO或双路EPYC),STARS的OpenMP并行可充分利用多核
- 内存:热采模型内存占用通常比黑油模型高30%–50%,建议按模型网格数×1.5倍估算内存需求
- 散热:长时间满负荷运行(SAGD模型可能连续跑数天)需要企业级散热方案,UltraLAB压缩机水冷系统可将CPU全核频率稳定在标称值以上
Q3:CMOST AI同时跑100个模拟作业,硬件瓶颈在哪里?
CMOST AI的批量优化本质是 embarrassingly parallel(易并行)任务——每个模拟作业独立运行,但共享同一套硬件资源。
| 资源类型 | 瓶颈表现 | UltraLAB解决方案 |
|---|---|---|
| CPU核心数 | 作业队列堆积,CPU利用率100%但吞吐量不足 | 双路EPYC 9755(256核)或TR PRO 7995WX(96核),支持同时运行数十个并行进程 |
| 内存容量 | 内存耗尽导致作业失败或频繁换页 | 512GB–1TB ECC DDR5,确保每个作业分配8–16GB内存仍有富余 |
| 磁盘I/O | 大量结果文件同时读写导致I/O等待 | 多路NVMe Gen5 SSD RAID 0,读写带宽≥20GB/s |
| GPU显存 | GEM GPU作业过多导致显存争抢 | 多卡配置(4× RTX Pro 6000),每卡独立运行一个GEM实例 |
Q4:Builder加载大型地质模型卡顿,是CPU还是GPU的问题?
Builder的前处理操作(网格生成、属性插值、三维可视化)对硬件的需求分层明显:
- 模型加载与网格生成:依赖CPU单核性能与内存带宽。CMG 2025版已大幅优化大模型加载时间,但复杂角点网格(Corner-Point Grid)的生成仍受限于CPU主频
- 三维可视化与交互:依赖GPU显存与OpenGL性能。千万级网格的实时旋转、剖切、属性体渲染需要大显存(≥24GB)支撑
- 建议:Builder工作站配置应平衡CPU高频与GPU大显存,避免"CPU等GPU"或"GPU等CPU"的瓶颈
Q5:CO₂封存模拟需要多大的内存和显存?
CO₂封存(CCS)模拟是CMG GEM最复杂的应用场景之一,通常涉及:
- 组分追踪:CO₂、CH₄、H₂O、多种离子与矿物组分
- 地球化学耦合:矿物溶解/沉淀动力学(Wolery数据库,14+种矿物)
- 地质力学耦合:孔隙压力-应力-渗透率耦合
资源估算公式:
内存需求 ≈ 网格数 × 每网格方程数 × 8字节 × 安全系数(2–3)
显存需求 ≈ Jacobian矩阵非零元数量 × 8字节 × 1.5
以200万网格、10组分、耦合地球化学的CCS模型为例:
- 内存需求:约256–512GB
- 显存需求:约40–80GB(GEM GPU加速时)
因此,CO₂封存项目建议直接采用UltraLAB旗舰级配置(512GB内存 + 96GB显存GPU)。
八、总结:CMG + AI + UltraLAB = 油藏模拟新范式
| 维度 | 传统模式 | AI + GPU + UltraLAB新模式 |
|---|---|---|
| 历史拟合 | 工程师手动试错,数周至数月 | CMOST AI自动优化,数天完成 |
| 模拟速度 | 纯CPU求解,千万网格模型运行数天 | GEM GPU加速,线性求解环节提速数倍 |
| 不确定性分析 | 少量场景人工评估 | 蒙特卡洛 + RBF代理模型,数百场景自动评估 |
| 决策效率 | 单方案比选,风险难量化 | 多目标鲁棒优化,NPV与风险同时权衡 |
| 硬件投入 | 通用服务器,资源利用率低 | UltraLAB定制化配置,CPU/GPU/内存精准匹配CMG负载特征 |
CMG软件家族通过CMOST AI将机器学习引入油藏工程核心工作流,通过GEM GPU加速突破大规模组分模拟的性能瓶颈,通过AUTOTUNE AI让数值调优自动化。这三大技术支柱,配合UltraLAB针对油藏模拟负载特征深度定制的高性能工作站,正在帮助全球油气企业从"经验驱动"走向"数据+物理双驱动"的智能开发新时代。
关于UltraLAB
UltraLAB是西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,专注为科学计算、工程仿真、AI训练等场景提供超频硬件配置方案。针对CMG油藏模拟、COMSOL多物理场、ANSYS结构仿真等应用,提供从单塔式工作站到GPU集群的全栈算力解决方案。
微信号:xasun001 或100369800 | 咨询热线:400-705-6800


