






摘要:Eclipse 是 SLB 的工业参考级油藏数值模拟器,覆盖黑油、组分、热采与非常规模型。本文依据 SLB 官方产品资料梳理其模型体系与求解特征,分析网格规模驱动的内存需求、全隐式线性求解的并行边界,以及历史拟合批量运行的任务级并行机会,为油藏工程团队给出 UltraLAB 工作站分档配置建议。
适用读者:油藏工程师、油田开发方案设计团队、油藏数值模拟研究人员、非常规油气开发模拟团队。
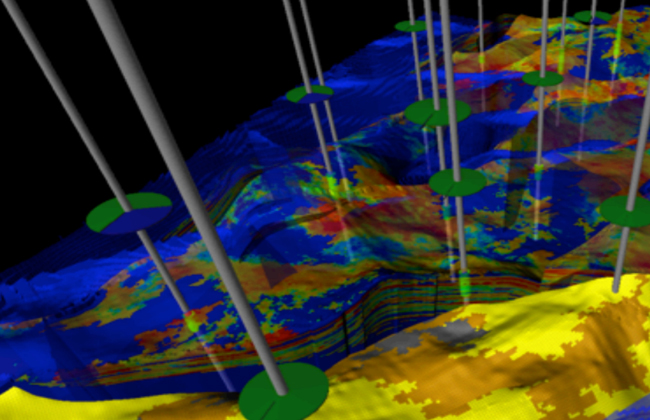
一、资料背景与核心观点
- 资料名称:Eclipse 官方产品资料(SLB Software)
- 发布机构:SLB(斯伦贝谢)
- 原文链接:SLB Eclipse 产品页
核心观点:Eclipse 定位于"工业参考"油藏模拟,官方资料强调其黑油(E100)、组分(E300)与热采等模型体系、复杂井与油藏管理(场级策略)能力,以及与 Petrel 油藏建模的一体化工作流。对硬件选型最关键的认识是:油藏模拟的成本由"网格单元数 × 每单元变量数 × 时间步数"决定,全隐式求解每步要求解大规模稀疏线性方程组,内存占用与求解耗时随有效网格数近似超线性增长;而历史拟合与方案比选需要成百上千次完整模拟,构成任务级并行的主要负载。
二、主要功能模块与核心算法
依据官方产品资料及公开技术文档:
- 模型体系:黑油模型(油、气、水三相组分化简)与组分模型(状态方程描述 PVT);热采、裂缝性油藏与非常规扩展。
- 空间离散:有限差分/有限体积类离散,角点网格与断层处理;局部网格加密(LGR)使有效网格数显著增加。
- 时间积分与线性化:IMPES 与全隐式(Fully Implicit)时间格式;全隐式每步牛顿迭代求解雅可比系统,是计算与内存的主体。
- 线性求解器:预处理迭代求解(CPR 类思路为行业通用做法),多相压力-饱和度耦合;具体实现细节以官方文档为准。
- 井与油藏管理:复杂井模型、管网耦合、开发策略逻辑(场级控制)增加每步非线性开销。
- 并行能力:官方资料提供并行运行能力以扩展大规模模型;并行效率受网格分区质量与井处理制约,核数扩展收益递减。
原文未提供公开的分档硬件配置表;并行许可与版本特性以 SLB 官方说明为准。
三、计算特点与性能瓶颈
计算密集特征
- 稀疏线性求解主导:全隐式每时间步的线性求解占用大部分 CPU 时间,属于内存带宽敏感的稀疏计算,多核扩展在 16–32 线程后收益递减。
- 非线性开销:井控制、相态计算(组分模型 EOS 闪蒸)随组分与井数增长;组分模型单步成本显著高于黑油模型。
- 串行时间推进:时间步严格串行,单次模拟无法靠多 GPU/多节点随意缩短;批量模拟(历史拟合、方案比选)是任务级并行的主战场。
内存需求
- 内存近似随"有效网格数 × 每单元变量数 × 雅可比存储"增长:十万级网格 32–64 GB;百万级网格全隐式建议 128–256 GB;含 LGR 与组分模型取上限。
- 求解器工作数组与重启文件缓存需额外余量,建议按峰值 × 1.3 配置。
I/O 与存储
- 重启文件(restart)与结果文件(summary/grid 输出)随网格数与输出频率增长,完整项目可达 TB 级;批量历史拟合产生大量案例目录,NVMe 项目盘 + 大容量归档盘为标准组合。
四、典型应用场景
- 区块级开发方案模拟:十万—百万网格、数百口井、全隐式,主流档工作站可在小时级完成单次模拟。
- 历史拟合:辅助历史拟合(AHM)批量运行数百案例,任务级并行,多核大内存平台。
- 组分/非常规模型:致密油、凝析气藏的组分模拟,单步成本高,高主频与大内存并重。
- 教学与机理研究:小网格概念模型,入门档即可。
五、UltraLAB 硬件配置建议
说明:SLB 未公开统一硬件配比表,以下按网格规模与负载模式推导;Eclipse 的并行许可与平台支持矩阵请与 SLB 核实。
| 档位 | CPU 选型思路 | 内存 | GPU | 系统盘 / 项目盘 / 数据盘 | 散热 / 电源 / 扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门级 | 高主频 8–12 核 | 64 GB | 常规显卡(Petrel 图形需中端专业卡) | 1 TB NVMe 系统盘 + 2 TB NVMe 项目盘 | 静音塔式,750 W 电源 | 教学、概念模型、十万网格内黑油模拟 |
| 主流级 | 高主频 16–24 核 | 128–256 GB ECC | 专业图形显卡(三维油藏可视化) | 1 TB NVMe 系统盘 + 4 TB NVMe 项目盘 + 16 TB HDD 归档 | 强化风冷塔式,1200 W 级电源 | 区块级全隐式模拟、小规模历史拟合 |
| 高性能级 | 32 核级高内存带宽平台 | 256–512 GB ECC | 专业图形显卡 | 2 TB NVMe 系统盘 + 8 TB NVMe 项目盘 + 32 TB RAID 归档 | 冗余电源、7×24 运行设计 | 百万级网格组分模型、批量历史拟合队列 |
推荐理由与升级方向:单次模拟的甜点位在 16–24 核高主频;历史拟合等批量负载按"案例数 × 单案例内存"反推核数与内存,优先考虑"多案例并行"而非单案例继续加核;网格超百万且组分复杂时升级至 512 GB 级内存平台或评估集群。
六、软件清单
| 类别 | 软件 | 必需性 | 说明 |
|---|---|---|---|
| 油藏模拟器 | Eclipse(E100/E300 等) | 必需 | 商业许可,按模型类型授权 |
| 建模一体化 | Petrel | 可选(团队标配) | 地质建模与前后处理 |
| 前处理工具 | 网格与 PVT 处理(Petrel RE 等) | 可选 | 角点网格、流体模型准备 |
| 历史拟合 | 辅助历史拟合工具/脚本(Python 驱动批量) | 可选 | 批量案例管理 |
| 数据分析 | Python + pandas、spotfire 类 | 可选 | 结果曲线与指标分析 |
| 调度 | 作业队列脚本 | 可选 | 批量案例排队运行 |
七、常见问题(FAQ)
Q1:模型网格翻倍,内存需求也翻倍吗?
通常更糟。全隐式雅可比存储与求解器工作数组随非零元增长,而网格加密往往增加单元间连接数,内存近似超线性增长。经验上按"有效网格数变化 × 1.5–2"预估内存变化,并实测校准。
Q2:Eclipse 加核能明显缩短单次模拟时间吗?
有限。稀疏线性求解的多核扩展在 16–32 线程后明显递减,井处理等环节并行度更低。缩短单次模拟更有效的方法是:优化网格(合理 LGR)、调整时间步策略、减少不必要的输出——硬件上优先高主频与内存带宽。
Q3:组分模型为什么比黑油模型贵这么多?
组分模型每个网格单元要反复做 EOS 闪蒸计算,且未知量随组分数增加,单步成本数倍于黑油。选型时组分模型应在同网格规模基础上上调一个内存档位,并优先高主频 CPU。
Q4:历史拟合应该买一台大机器还是多台中等机器?
看案例规模。单案例内存 ≤ 32 GB 时,多台 16 核/64 GB 节点并行跑案例的总吞吐和故障隔离优于单台 64 核;单案例本身就要 128 GB 以上时,只能上大内存平台。先统计案例资源画像再决策。
Q5:Eclipse 需要 GPU 吗?
官方产品资料未将 GPU 加速作为 Eclipse 求解特性提供,不应为其配置计算 GPU;但 Petrel 三维油藏可视化对图形显卡有要求,前后处理机器需配专业图形卡。
八、总结与选型建议
Eclipse 油藏模拟的选型逻辑是"网格定内存、组分加一档、单跑看主频、批量看案例并行"。十万级网格黑油模拟 64 GB 内存起步;区块级全隐式与组分模型选 16–24 核 + 128–256 GB ECC;历史拟合批量按案例资源画像横向扩展。GPU 预算投给 Petrel 可视化而非求解器;并行许可与版本特性以 SLB 官方说明为准。
参考来源
- SLB:Eclipse 官方产品资料。https://software.slb.com/products/eclipse
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



