






从数据分析到算法开发,从Simulink仿真到AI模型训练,MATLAB作为工程计算领域的核心平台,其运行效率始终与硬件配置深度绑定。随着MATLAB R2026a预发布版的推出,以及科学计算向千万级自由度、亿级网格规模的演进,传统工作站正面临严峻的性能挑战。本文将从MATLAB最新系统要求出发,结合UltraLAB系列高端图形工作站的最新硬件配置,为不同需求的用户提供一份完整的选型参考。
一、MATLAB R2026a的硬件门槛与性能密码
1.1 官方系统要求解读
根据MathWorks发布的最新系统要求,MATLAB R2026a对硬件提出了明确指引:
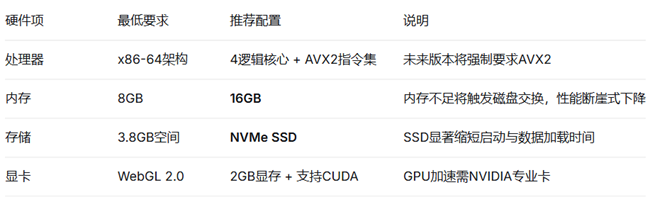
值得关注的是,AVX2指令集正在成为关键门槛。MATLAB大量核心运算(矩阵乘法、FFT、LU分解)依赖Intel MKL或AMD AOCL数学库,这些库通过AVX2/AVX-512指令集实现向量化加速。缺乏AVX2支持的旧款处理器,性能差距可达数倍
1.2 MATLAB的性能密码:CPU主频、内存带宽与GPU的三重博弈
多核心释放“并行潜力”。MATLAB的向量化运算(如A+B)、parfor并行循环、参数化扫描等场景天然适合多核并行。96核的AMD Threadripper PRO 9995WX在处理COMSOL参数化扫描时,可将原本串行执行需要80小时的任务压缩至1小时内。
内存带宽决定“数据吞吐天花板”。这是最容易被忽视的瓶颈。稀疏矩阵运算(SpMV)中,每次迭代需遍历全部非零元,内存带宽直接决定迭代速度。UltraLAB的8通道DDR5架构提供≥300GB/s带宽,是普通双通道桌面平台的6-8倍。
GPU是“算力杠杆”。对于大规模稠密矩阵运算(如10000×10000矩阵求逆)和深度学习训练,GPU加速可达10-50倍。但需注意:MATLAB的Parallel Computing Toolbox通过CUDA调用GPU,消费级显卡的双精度(FP64)性能通常被大幅阉割,科学计算场景需要RTX 6000 Ada等专业卡。

二、UltraLAB科学计算工作站硬件方案详解
UltraLAB作为国内高端定制图形工作站的专业厂商,其产品线针对MATLAB、COMSOL、ANSYS等科学计算软件进行了深度优化。以下结合2026年最新硬件平台,提供二套精准方案。
二、UltraLAB科学计算工作站硬件方案详解
|
组件 |
推荐配置 |
技术逻辑 |
|
CPU |
AMD Threadripper PRO 9995WX(96核,5.4GHz睿频) |
96核支撑COMSOL参数化扫描并行;高主频优化MATLAB JIT编译 |
|
GPU |
NVIDIA RTX 6000 Ada 48GB |
48GB显存支撑大规模GPU加速;FP64性能为消费级显卡3倍以上 |
|
内存 |
256GB DDR5-6400 ECC |
256GB可支撑千万级自由度模型(约2000万COMSOL自由度) |
|
存储 |
4TB NVMe Gen5(读速14GB/s)+ 8TB HDD |
Gen5 SSD加速临时文件与当前项目;HDD归档历史结果 |
|
参考型号 |
UltraLAB AE450 |
塔式可选,支持GPU升级与液冷静音 |
性能预估:
-
MATLAB 10000×10000稠密矩阵求逆:利用GPU加速,从30分钟压缩至3分钟
-
COMSOL多物理场耦合(500万自由度):单次求解时间压缩至2-3小时(原8-10小时)
-
Simulink大型模型仿真:多核并行加速3-5倍
适用场景:亿级网格CFD、整车碰撞仿真、全机强度校核、大规模参数扫描。此方案可单机运行,也可作为集群节点横向扩展。
|
组件 |
推荐配置 |
技术逻辑 |
|
CPU |
双路Intel Xeon Platinum 8592+(128核,320MB L3缓存) |
128核支撑ANSYS Fluent分布式并行;超大L3缓存优化稀疏矩阵随机访问 |
|
GPU |
NVIDIA H100 80GB × 2 |
80GB显存支撑GPU-native求解器;NVLink保障双卡通信带宽 |
|
内存 |
512GB DDR5-4800 ECC |
512GB支撑亿级网格CFD(约5000万自由度)的稀疏矩阵存储 |
|
存储 |
8TB NVMe 读速28GB/s)+ 16TB HDD |
加速临时文件读写;HDD存储海量计算结果 |
|
网络 |
100GbE |
多节点集群扩展,支撑分布式并行求解 |
|
参考型号 |
UltraLAB GX660 |
机架式,支持大容量内存与多节点集群 |
性能预估:
-
ANSYS Fluent(亿级网格):多节点并行求解时间压缩至12-24小时(原单节点3-5天)
-
LS-DYNA整车碰撞(2000万单元):单节点求解时间从4天压缩至24小时
三、关键优化技术与选型决策
3.1 内存容量的“经验公式”
科学计算中,内存容量直接决定可解问题的规模上限。经验公式为:内存需求(GB)≈ 自由度 × 8-12字节。千万级自由度模型需80-120GB内存,亿级网格则需512GB以上。当物理内存不足时,求解器会启用磁盘交换(out-of-core),效率骤降10-100倍。
3.2 稀疏求解器优化
对于COMSOL、ANSYS等有限元软件的稀疏矩阵求解,内存带宽比CPU核心数更为关键。UltraLAB的8通道DDR5架构和HBM(高带宽内存)配置可显著提升SpMV(稀疏矩阵向量乘)效率。此外,启用直接求解器的“核外求解”模式,将分解矩阵暂存至NVMe SSD,可在内存容量有限时保持求解连续性。
3.3 MATLAB专属优化策略
-
GPU加速:使用
gpuArray将数据转移至GPU显存,调用cuBLAS/cuSOLVER加速稠密运算。 -
并行池:
parpool利用CPU多核并行参数化扫描,实测96核配置下加速比可达80倍以上。
MATLAB与UltraLAB的结合,无论是寂静实验室中的算法调试,还是超算中心里的大规模仿真,选择正确的硬件平台,就是选择与效率同行。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
电话/微信:18092689780


