






UltraLAB 定制图形工作站/服务器方案
西安坤隆计算机科技有限公司
适用场景:流固耦合(FSI)、热-结构耦合、电磁-热耦合、电化学-热-力耦合、MEMS多物理场、数字孪生、AI代理模型
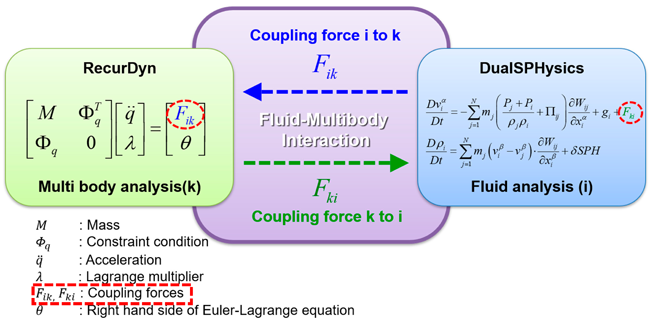
一、多物理场耦合仿真的核心特征:CPU主导+GPU辅助,内存是硬约束
多物理场耦合仿真与传统单物理场仿真有本质区别:全耦合直接求解器需要同时处理多个物理场的稀疏矩阵,内存容量和带宽是硬约束,单核性能决定交互体验,GPU仅部分模块加速。
| 场景 | 单物理场仿真 | 多物理场耦合 | AI代理模型 | 混合方法 |
|---|---|---|---|---|
| 计算时间 | 小时级 | 天级(耦合迭代) | 秒级~分钟级 | 小时级 |
| 内存需求 | 网格数x0.2KB | 网格数x(0.5-2)KBx场数 | 模型权重+数据 | 中等 |
| CPU瓶颈 | 多核并行 | 单核+内存带宽 | GPU计算 | CPU预处理 |
| GPU加速 | 部分(CFD/电磁) | 有限(2026年仍CPU主导) | 核心 | 辅助 |
| 硬件哲学 | 多核+GPU | 大内存+高主频+适度多核 | 大显存GPU | 混合架构 |
核心原则:多物理场耦合的"不可能三角"——大内存容量、单核高性能、多核并行度三者不可兼得,需按物理场数量和网格规模权衡。2026年COMSOL仍CPU主导,GPU为辅助。
二、硬件配置方案(按场景分级)
2.1 入门学习/教学/简单耦合 — 3~6万
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | Intel Core i7-14700K / AMD Ryzen 7 7700X(8P+12E核 / 8核16线程) | 高主频利于前处理与网格划分 |
| GPU | RTX 4060 Ti 16GB | 大显存支持后处理复杂三维模型流畅旋转与切面显示 |
| 内存 | 64GB DDR5-5600(双通道) | COMSOL对内存容量极其敏感,32GB在耦合场中容易吃紧 |
| 存储 | 1TB NVMe SSD(PCIe 4.0) | 快速加载模型与保存结果 |
| 散热 | 240mm一体式水冷 | 长时间满载求解,避免CPU降频 |
| 系统 | Windows 11 Pro / Ubuntu 22.04 | 双系统可选 |
适用场景:
- 高校学生、初级工程师进行中小规模(<50万自由度)的二维或简单三维模型学习
- 单物理场/双物理场耦合(热-结构、流-热)
- 参数化扫描入门
- AI代理模型小样本训练(<1万样本)
可跑软件:COMSOL(学生版/入门模块)、ANSYS Workbench(简单耦合)、Elmer(开源)
2.2 专业仿真/中型耦合/企业研发 — 10~20万
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | Intel Core i9-14900K / AMD Ryzen 9 7950X(24核32线程 / 16核32线程) | 多核并行加速矩阵求解,高主频保障交互 |
| GPU | RTX 4070 Ti Super 16GB / RTX A4000 16GB | 专业卡驱动更稳定,支持COMSOL的GPU加速后处理 |
| 内存 | 128GB DDR5-6000(四通道或双通道高容量) | 百万级自由度模型的刚需 |
| 存储 | 2TB NVMe SSD(PCIe 4.0)+ 4TB HDD(归档) | 分层存储 |
| 散热 | 360mm一体式水冷或高端风冷 | 满载功耗250W+,温度控制是稳定求解的前提 |
| 显示器 | 双屏27英寸 2K/4K IPS | 一屏建模,一屏监控求解器收敛曲线与后处理 |
| 系统 | Windows 11 Pro for Workstations / Linux | 根据许可证与集群环境选择 |
适用场景:
- 企业研发工程师处理中等规模(50万-200万自由度)的三维多物理场耦合模型
- 热-结构-流三场耦合、电磁-热耦合
- 参数化扫描、设计优化
- AI代理模型中等规模训练(1-10万样本)
- 锂电池电化学-热-力耦合
可跑软件:COMSOL(全模块)、ANSYS Workbench(Fluent+Mechanical耦合)、CFX+Mechanical、Elmer、OpenFOAM+CalculiX
2.3 企业级/大规模耦合/研究院所 — 25~40万 ⭐推荐
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX(96核,5.1GHz睿频) | 单核5GHz+96核规模,最接近"不可能三角"最优解 |
| GPU | RTX A5000 24GB / RTX 5000 Ada 32GB | 大显存、专业驱动认证,支持复杂模型实时渲染与动画输出 |
| 内存 | 1TB DDR5-4800 ECC(8x128GB,8通道,307GB/s) | 支持完整城市级数字孪生模型(十亿级单元) |
| 存储 | 4TB NVMe Gen5 + 16TB NVMe Gen4 RAID0 | 高速读写大模型文件 |
| 网络 | 双口100GbE | 未来集群扩展 |
| 系统 | Windows 11 Pro for Workstations / Linux | 稳定性优先 |
适用场景:
- 热设计团队、研究院所进行大规模(200万+自由度)复杂封装结构的全耦合瞬态分析
- 三物理场耦合(流-固-热、电磁-热-结构)
- 参数化优化与批量仿真
- AI代理模型大规模训练(10-100万样本)
- MEMS/传感器(电磁-压电-流-固)
可跑软件:COMSOL(全模块+LiveLink)、ANSYS Workbench(全耦合)、CFX+Mechanical+Maxwell、Elmer、OpenFOAM+CalculiX+preCICE
2.4 超大规模/四物理场+/国家级项目 — 60~100万
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 双路AMD EPYC 9754(256核512线程)/ 双路Intel Xeon Platinum 8490H(120核) | 超大规模并行,支持100+工况同时求解 |
| GPU | RTX 6000 Ada 48GB x2(NVLink)/ A100 80GB x2 | 96GB显存池化,支持亿级网格实时可视化 |
| 内存 | 2TB-4TB DDR5-4800 ECC RDIMM | 四物理场+(等离子体/核工程/多尺度) |
| 存储 | 16TB NVMe全闪存阵列(RAID 10) | 高速+冗余,保障数字孪生数据安全 |
| 网络 | 双口25GbE / 100GbE InfiniBand | 连接IoT传感器数据流与边缘计算节点 |
| 系统 | Linux CentOS/RHEL 8+ + Slurm | 集群调度 |
适用场景:
- 四物理场+耦合(等离子体/聚变/核工程)
- 整车/整机数字孪生
- 城市级多物理场模拟
- AI大模型本地部署(70B参数级)
- 超大规模参数化优化 citeweb_search:23#3citeweb_search:23#13
可跑软件:COMSOL(集群版)、ANSYS Workbench(HPC)、CFX+Mechanical+Maxwell+Icepak、OpenFOAM+Elmer+preCICE
2.5 AI代理模型/数字孪生专用节点 — 30~60万
注意:多物理场AI代理模型(PINN/FNO/神经网络替代部分物理场)需要大显存GPU
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX(96核)/ Intel Xeon W-3495X(56核,5.0GHz+) | 高主频数据预处理+多任务 |
| GPU | RTX Pro 6000 96GB / A100 80GB x2 | 96GB显存,大模型权重+多物理场数据 |
| 内存 | 256GB-512GB DDR5 ECC | 大模型并发+多物理场数据集缓存 |
| 存储 | 8TB NVMe U.2 x2(RAID0)+ 32TB HDD | 高速读写大模型文件 |
| 网络 | 25GbE | 多机数据同步 |
| 系统 | Ubuntu 22.04 LTS + Docker | 容器化多模型隔离 |
适用场景:
- ANSYS Twin Builder ROM构建
- 物理信息神经网络(PINN)多物理场求解
- 傅里叶神经算子(FNO)快速PDE求解
- 生成式设计(扩散模型+拓扑优化)
- 实时数字孪生(毫秒级响应)
可跑软件:ANSYS Twin Builder、NVIDIA Modulus、DeepXDE、PyTorch+DeepSpeed、TensorRT
2.6 集群/超算/国家级多物理场中心 — 200万+
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 多节点双路EPYC/Xeon + 多GPU(H100/A100) | 每节点高配置 |
| GPU | H100 80GB SXM5 x8/节点 | NVLink全互联 |
| 内存 | 2TB+/节点 DDR5 ECC | 超大规模模型 |
| 存储 | Lustre/GPFS并行文件系统,PB级容量 | 分层存储(热SSD+温HDD+冷磁带) |
| 网络 | 400G/800G InfiniBand全互联 | 超低延迟全互联 |
| 调度 | Slurm + PBS Pro | 作业调度 |
适用场景:
- 国家级多物理场基础模型预训练
- 城市级/流域级多物理场数字孪生
- 气候-海洋-大气耦合模拟
- 核聚变等离子体-壁面-中子耦合
三、多物理场耦合显存/内存需求速查表
| 任务类型 | 自由度/网格规模 | 内存需求 | GPU显存 | 说明 |
|---|---|---|---|---|
| COMSOL单物理场 | 10-50万 | 32-64GB | 有限 | 频域/稳态,CPU为主 |
| COMSOL双物理场 | 50-200万 | 128-256GB | 有限 | 热-结构/流-热 |
| COMSOL三物理场 | 200-1000万 | 512GB-1TB | 部分后处理 | 流-固-热/电磁-热-结构 |
| COMSOL四物理场+ | 1000万+ | 1TB-4TB | 辅助 | 等离子体/核工程 |
| ANSYS Fluent+Mechanical | 100-1000万 | 256GB-1TB | 24-48GB | GPU加速Fluent,CPU做结构 |
| ANSYS Maxwell+Mechanical | 50-200万 | 128-512GB | 24-48GB | GPU加速Maxwell 2026R1 |
| OpenFOAM+CalculiX | 100-500万 | 256GB-1TB | 不适用 | 开源组合,preCICE耦合 |
| Elmer多物理场 | 10-200万 | 64-512GB | 不适用 | 开源,GUI拖拽耦合 |
| PINN多物理场 | — | 128-256GB | 48-80GB | 物理信息神经网络 |
| FNO神经算子 | — | 128-256GB | 48-80GB | 傅里叶神经算子 |
| 生成式设计(扩散模型) | — | 256-512GB | 48-80GBx2 | 反向扩散计算密集 |
| 数字孪生ROM | — | 128-256GB | 24-48GB | 低维ODE系统,高频CPU |
| 多物理场大模型推理 | — | 256-512GB | 80GBx2/4 | 70B参数级 |
| 多物理场大模型微调 | — | 512GB-1TB | 80GBx4/8 | 全参数微调 |
内存估算公式:多物理场内存 = 单物理场内存 x 物理场数量 x 耦合系数(1.2-2.0)
直接求解器:内存 = 自由度 x 0.5KB-2KB(取决于稀疏矩阵填充率)
迭代求解器:内存 = 自由度 x 0.1KB-0.5KB(GMRES等)
高阶单元:内存需求比低阶单元高3-5倍
四、软件清单
4.1 商业多物理场仿真软件
| 软件 | 开发商 | 耦合能力 | GPU支持 | 说明 |
|---|---|---|---|---|
| COMSOL Multiphysics | COMSOL | 全耦合/松散耦合,34+模块 | 有限(2026年CPU主导) | 多物理场耦合王者,GUI极友好,AC/DC模块强大,昂贵(单用户约4000美元/年) |
| ANSYS Workbench | Ansys | 流-固-热-磁-电多场耦合 | 部分(Fluent/Maxwell GPU) | 综合工程仿真平台,流固耦合和系统级仿真能力强,价格高,学习曲线陡峭 |
| ANSYS Twin Builder | Ansys | ROM构建、实时数据融合 | 支持 | 数字孪生平台,ROM压缩比1000:1,毫秒级物理预测 |
| CFX+Mechanical | Ansys | 流-固耦合(FSI) | 部分 | 旋转机械、涡轮机械专用 |
| Fluent+Mechanical | Ansys | 流-固-热耦合 | Fluent GPU支持 | 通用CFD+结构耦合 |
| Maxwell+Mechanical+Icepak | Ansys | 电磁-结构-热耦合 | Maxwell 2026R1 GPU刚需 | 电机/变压器/功率电子 |
| STAR-CCM+ | Siemens | 流体+热+结构+电磁 | 完整GPU支持 | CFD+多物理场,JTOpen集成 |
| ADINA | ADINA R&D | 流-固-热-电磁-多孔介质 | 有限 | 非线性分析强 |
| LS-DYNA | Ansys/LSTC | 显式动力学+多物理场 | 部分GPU | 冲击、碰撞、爆炸 |
| Simulia Abaqus | Dassault | 结构+热+电+磁+流体 | 有限 | 非线性结构分析标杆 |
| Simdroid | 云道智造 | 国产多物理场 | 支持 | 国产替代,云原生 |
| HAJIF | 中国航空 | 国产航空结构分析 | 有限 | 航空专用 |
4.2 开源多物理场仿真软件
| 软件 | 语言 | 耦合能力 | GPU | 说明 |
|---|---|---|---|---|
| Elmer | Fortran/C++ | 多物理场全耦合,GUI拖拽 | 不支持 | 开源多物理场王者,完全免费,跨平台,学术和企业均可自由使用,学习曲线陡峭 |
| OpenFOAM | C++ | 流体+热+多相流+拉格朗日粒子 | 有限 | 开源CFD标杆,需配合其他工具做耦合 |
| CalculiX | C++/Fortran | 结构+热+电 | 不支持 | 开源结构分析,Abaqus替代 |
| preCICE | C++ | 耦合库,连接OpenFOAM+CalculiX等 | 不支持 | 开源耦合中间件,多代码协同 |
| FEniCS | Python/C++ | 有限元,数学表达友好 | 不支持 | 开源,偏微分方程求解 |
| deal.II | C++ | 有限元,自适应网格 | 不支持 | 开源,hp自适应 |
| MOOSE | C++ | 多物理场,面向对象 | 不支持 | Idaho国家实验室,核工程 |
| DUNE | C++ | 有限元/有限体积,网格自适应 | 不支持 | 分布式统一数值环境 |
| DuMux | C++ | 多孔介质多相流 | 不支持 | 开源,地质/环境 |
| MFEM | C++ | 有限元,高阶并行 | 支持 | 高性能计算,GPU加速 |
| NGSolve/Netgen | C++ | 有限元,网格生成+求解 | 不支持 | 开源,Python接口 |
| PyGBe | Python | 边界元,GPU加速 | CUDA | 开源,纳米光学 |
4.3 AI/机器学习框架(多物理场专用)
| 软件 | 说明 |
|---|---|
| NVIDIA Modulus | 科学ML框架,物理信息神经网络PINNs,多物理场约束 |
| DeepXDE | 开源PINN库,支持多种PDE,多物理场 |
| NeuroDiffEq | 神经网络求解微分方程 |
| SciANN | 科学计算+ANN,物理约束神经网络 |
| PyTorch | 主流深度学习框架,多物理场AI首选 |
| TensorFlow / Keras | Google出品,生产部署友好 |
| JAX / Flax | 高性能计算框架,适合FNO/PINN研究 |
| DeepSpeed | 分布式训练,大模型显存优化 |
| ONNX Runtime | 跨平台推理加速 |
| TensorRT | NVIDIA推理加速,FP16/INT8量化 |
| Fourier Neural Operator (FNO) | 傅里叶神经算子,快速求解PDE |
| DeepONet | 算子学习,多物理场映射 |
| Physics-Informed Neural Networks (PINN) | 将控制方程嵌入损失函数,物理保真 |
| Neural Operator | 神经算子库,多物理场快速求解 |
4.4 代理模型与降阶模型(ROM)
| 软件/方法 | 说明 |
|---|---|
| ANSYS Twin Builder ROM | 非侵入式ROM,从全阶模型自动提取状态空间模型,压缩比1000:1 |
| Proper Orthogonal Decomposition (POD) | 本征正交分解,降阶模型基础 |
| Dynamic Mode Decomposition (DMD) | 动态模态分解,流场降阶 |
| Gaussian Process (GP) | 高斯过程,贝叶斯优化代理 |
| RBF网络 | 径向基函数,快速代理模型 |
| 神经网络代理(SRM) | MLP/CNN/Transformer替代全阶仿真 |
| 强化学习(RL) | 实时优化,自适应控制 |
| 生成对抗网络(GAN) | 多物理场数据生成 |
| 变分自编码器(VAE) | 多物理场数据降维 |
| 归一化流(Normalizing Flow) | 可逆生成模型,精确似然 |
4.5 优化与不确定性量化
| 软件/方法 | 说明 |
|---|---|
| ANSYS optiSLang | 设计空间探索、敏感性分析、不确定性量化,AI+加速1600倍 |
| COMSOL Optimization Module | 内置优化模块,SNOPT/IPOPT |
| DAKOTA | 开源优化与不确定性量化工具包 |
| NOMAD | 无导数优化,黑箱函数 |
| Bayesian Optimization | 贝叶斯优化,样本高效 |
| Genetic Algorithm (GA) | 遗传算法,全局优化 |
| Particle Swarm Optimization (PSO) | 粒子群优化 |
| Monte Carlo | 蒙特卡洛采样,不确定性传播 |
| Polynomial Chaos Expansion (PCE) | 多项式混沌展开,谱方法 |
4.6 电路与系统级仿真
| 软件 | 说明 |
|---|---|
| SPICE/Spectre | 电路仿真,电热耦合 |
| VHDL-AMS | 硬件描述语言,多物理场系统级 |
| Modelica | 面向对象建模语言,多领域物理系统 |
| Dymola | Modelica商业环境 |
| OpenModelica | 开源Modelica环境 |
| Simulink | MATLAB多域仿真,控制系统+物理 |
| AMESim | 液压/机械/热系统仿真 |
| Simscape | MATLAB物理建模库 |
4.7 可视化与后处理
| 软件 | 说明 |
|---|---|
| ParaView | 开源3D可视化,支持亿级网格,多物理场数据 |
| NVIDIA Omniverse | 高保真协作3D可视化,多物理场实时渲染 |
| Tecplot | 专业科学可视化 |
| FieldView | CFD/多物理场后处理 |
| MATLAB | 多物理场数据处理、算法开发 |
| Python (Matplotlib/Plotly) | 2D/3D场分布可视化 |
| COMSOL Postprocessing | 内置后处理,表达式灵活 |
| ANSYS CFD-Post | Fluent/CFX专用后处理 |
| Ensight | 大规模数据可视化 |
4.8 数据管理与实验跟踪
| 软件 | 说明 |
|---|---|
| Pandas / Polars | 多物理场参数数据处理 |
| NumPy / SciPy | 数值计算、稀疏矩阵操作 |
| scikit-learn | 经典机器学习,多物理场特征提取 |
| XGBoost / LightGBM | 梯度提升,代理模型训练 |
| PyTorch Geometric | 图神经网络,多物理场网络建模 |
| W&B / MLflow | 实验跟踪与模型管理 |
| TensorBoard | 训练可视化 |
| Docker | 模型容器化部署 |
| HDF5 / NetCDF | 科学数据格式,多物理场时序数据 |
| Model Registry | 模型版本管理 |
4.9 国产信创替代方案
| 软件 | 说明 |
|---|---|
| Simdroid | 云道智造,国产多物理场,云原生 |
| HAJIF | 中国航空,国产航空结构分析 |
| HiSim | 中石油,地质建模-模拟一体化 |
| MindSpore (昇思) | 华为深度学习框架,适配昇腾NPU |
| PaddlePaddle (飞桨) | 百度深度学习框架 |
| 银河麒麟 / 统信UOS | 国产操作系统 |
| 达梦 / 人大金仓 | 国产数据库 |
| OpenFOAM+CalculiX+preCICE | 开源组合,完全自主可控 |
五、推荐软件栈组合(按场景)
场景1:传统多物理场耦合(流-固-热)
仿真:     COMSOL(全耦合)/ ANSYS Workbench(System Coupling)
流体:     Fluent / CFX / OpenFOAM
结构:     Mechanical / Abaqus / CalculiX
热:       Icepak / FloTHERM
耦合:     直接耦合(COMSOL)/ 迭代耦合(ANSYS)
优化:     optiSLang / COMSOL Optimization
场景2:电磁-热-结构耦合(功率电子/电机)
电磁:     Maxwell 2026R1(GPU加速)
热:       Icepak / FloEFD
结构:     Mechanical
电路:     Simplorer / SPICE
耦合:     ANSYS Workbench System Coupling
AI优化:   PINN(Modulus)+ 热-电联合优化
场景3:电化学-热-力耦合(锂电池)
电化学:   COMSOL Battery Module / Newman模型
热:       COMSOL Heat Transfer / Fluent
结构:     COMSOL Solid Mechanics / Abaqus
耦合:     COMSOL全耦合(直接求解器)
AI:       神经网络预测热失控 / 寿命预测
场景4:MEMS/传感器多物理场
电磁:     COMSOL AC/DC Module
压电:     COMSOL Piezoelectric
流:       COMSOL Microfluidics
固:       COMSOL Structural
耦合:     COMSOL全耦合
优化:     参数化扫描 + 拓扑优化
场景5:AI代理模型替代部分物理场
数据生成: COMSOL/ANSYS参数扫描(离线)
训练:     PyTorch + DeepSpeed + PINN/FNO
验证:     与全阶仿真对比,误差<3%
部署:     TensorRT + ONNX Runtime
应用:     实时预测、设计空间探索、数字孪生
场景6:数字孪生实时仿真
全阶模型: COMSOL/ANSYS(离线训练)
ROM:      Twin Builder POD / 神经网络降阶
实时数据: IoT传感器 + Kafka数据流
融合:     卡尔曼滤波数据同化
响应:     GPU加速ROM(<20ms延迟)
可视化:  NVIDIA Omniverse / ParaView
场景7:生成式设计(AI+拓扑优化)
基座模型: 扩散模型(Diffusion Model)
物理约束: 多物理场有限元(COMSOL/ANSYS)
优化:     多目标优化(重量+刚度+热+成本)
制造约束: 3D打印方向性、铣削可达性
硬件:     GPU(RTX 5090/Pro 6000)+ 高频CPU
场景8:国产信创环境
仿真:     Simdroid / HAJIF / OpenFOAM+CalculiX+preCICE
AI框架:   MindSpore + CANN(昇腾NPU)
OS:       银河麒麟 / 统信UOS
数据:     达梦数据库
安全:     等保三级 + 国密算法
六、常见问题硬件配置分析
Q1:为什么多物理场耦合比单物理场更"吃内存"?
多物理场耦合的内存需求呈指数增长:
- 单物理场:稀疏矩阵,内存 = 自由度 x 0.2KB
- 双物理场:耦合矩阵,内存 = 自由度 x 0.5KB x 2 x 1.2(耦合系数)
- 三物理场:全耦合,内存 = 自由度 x 1KB x 3 x 1.5
- 四物理场+:内存 = 自由度 x 2KB x 4 x 2.0
举例:100万自由度
- 单物理场:约200MB
- 双物理场:约1.2GB
- 三物理场:约4.5GB
- 四物理场:约16GB
加上网格、边界条件、后处理数据,三物理场100万自由度实际需128-256GB内存。
Q2:COMSOL的"不可能三角"是什么?如何破解?
COMSOL用户面临永恒的抉择:
        大内存容量
            /\
           /  \
          /    \
         / 最优  \  <- 现实中只能逼近
        /   解    \
       /____________\
单核高性能  <---->  多核并行度
(高主频)            (高核心数)
约束条件:
- 大内存服务器通常使用多路低频CPU(EPYC/Xeon Platinum)
- 高频CPU(Core-X/Threadripper)内存通道有限(4-8通道)
- 单节点内存上限:DDR5目前支持2TB(8x256GB),但频率下降
2026年逼近最优解的配置:
- 配置A(8-15万):Threadripper 7970X + 256GB DDR5-5200 —— 极致单核,中小规模
- 配置B(25-35万)⭐推荐:Threadripper PRO 7995WX + 1TB DDR5-4800 —— 单核5GHz+96核+1TB内存,最接近最优解
- 配置C(60-80万):双路EPYC + 2-4TB DDR5 —— 内存怪兽,牺牲单核性能
Q3:GPU在多物理场耦合中到底有多大用?
2026年现状:
- COMSOL:仅特定求解器支持GPU(如GMRES迭代求解器),总体提速仅8%,GPU大部分时间空闲,仍CPU主导
- ANSYS Fluent:GPU原生求解器,单卡RTX 4090相当于32核CPU,24倍加速
- ANSYS Maxwell 2026R1:ACAPhi求解器纯CPU模式数小时,GPU模式分钟级,GPU刚需
- ANSYS Mechanical:GPU加速稀疏矩阵求解,6倍加速
- ANSYS optiSLang AI+:1600倍加速
结论:
- 纯多物理场耦合(COMSOL):CPU+内存优先,GPU辅助
- 流体主导的多物理场(Fluent+Mechanical):GPU加速流体,CPU做结构
- 电磁主导的多物理场(Maxwell+Mechanical):GPU加速电磁,2026R1刚需
- AI代理模型/数字孪生:GPU是核心
Q4:消费级GPU(RTX 4090)能否用于多物理场AI?
| 对比项 | RTX 4090 24GB | RTX A6000 48GB |
|---|---|---|
| 显存 | 24GB | 48GB |
| ECC纠错 | 无 | 有 |
| 驱动稳定性 | 游戏驱动 | 专业驱动 |
| 虚拟化 | 不支持 | 支持 |
| 价格 | ~1.5万 | ~3万 |
结论:
- 个人研究/教学:RTX 4090足够,ANSYS Discovery Live实时仿真流畅
- 企业生产环境:必须用A6000/RTX Pro系列(ECC+专业驱动+7x24稳定)
- AI大模型训练:A100/H100更优(显存大+NVLink+Tensor Core)
- 数字孪生实时响应:RTX系列低延迟GPU优于A100/H100计算卡
Q5:ANSYS 2026的AI功能需要多少显存?
ANSYS 2026五大AI功能显存需求:citeweb_search:23#3
| AI功能 | 显存需求 | 说明 |
|---|---|---|
| ANSYS Copilot | 24GB+ | GPT-4级大语言模型,自然语言驱动仿真 |
| Twin Builder ROM | 16-24GB | 降阶模型实时推理,高频CPU更重要 |
| Generative Design AI | 48GB+ | 扩散模型,反向扩散计算密集 |
| Fluent GPU求解器 | 每100万网格8GB | LES模拟翻倍 |
| Mechanical GPU加速 | 24-48GB | 稀疏矩阵求解加速 |
| PINNs训练 | 48-80GB | 高阶偏导数计算图深度是CNN的3-5倍 |
Q6:国产GPU(昇腾/寒武纪)能否跑多物理场AI?
| 国产平台 | 适配情况 | 建议 |
|---|---|---|
| 华为昇腾910B | CANN已适配PyTorch/MindSpore,NVIDIA Modulus有昇腾版 | 可用,生态成熟 |
| 寒武纪MLU370-X8 | BANG C + MagicMind | 可用,开发成本高 |
| 海光DCU | ROCm生态,HIP兼容CUDA | 可用,兼容性待验证 |
结论:信创项目可选昇腾910B,已有成熟科学ML迁移方案。
七、UltraLAB 推荐机型速查
| 预算 | 机型 | 核心配置 | 适用场景 |
|---|---|---|---|
| 3-6万 | UltraLAB A350 | i7-14700K + RTX 4060 Ti 16GB + 64GB | 入门学习/教学/简单耦合 |
| 10-20万 | UltraLAB A450 | i9-14900K + RTX 4070 Ti S 16GB + 128GB | 专业仿真/中型耦合/企业研发 |
| 25-40万 | UltraLAB A550 ⭐推荐 | 7995WX + RTX A5000 24GB + 1TB | 企业级/大规模耦合/三物理场 |
| 60-100万 | UltraLAB GA660M | 双EPYC 9754 + RTX 6000 Ada x2 + 2-4TB | 超大规模/四物理场+/数字孪生 |
| 30-60万 | UltraLAB A660-AI | 7995WX + RTX Pro 6000 96GB + 512GB | AI代理模型/PINN/数字孪生 |
| 200万+ | UltraLAB GX880M | 多节点H100x8 + InfiniBand | 国家级/基础模型/超算中心 |
商务咨询:400-705-6800
技术咨询:微信号 100369800
官网:www.xasun.com


