






title: "COMSOL Multiphysics NVIDIA GPU加速与AI-DNN代理模型全攻略:UltraLAB硬件配置选型指南"
description: "基于COMSOL官方GPU选型指南,深度解析cuDSS直接稀疏求解器、DNN深度神经网络代理模型训练、时域显式压力声学三大GPU加速技术,提供UltraLAB图形工作站硬件配置推荐与常见问题分析。"
keywords: "COMSOL,Multiphysics,GPU加速,NVIDIA,cuDSS,DNN代理模型,深度神经网络,压力声学,显式求解器,UltraLAB,图形工作站,硬件配置"
author: "UltraLAB技术团队"
date: "2026-07-28"
category: "多物理场仿真与AI计算"
COMSOL Multiphysics NVIDIA GPU加速与AI-DNN代理模型全攻略:UltraLAB硬件配置选型指南
当千万自由度多物理场耦合模型的稀疏矩阵分解遇上NVIDIA cuDSS GPU直接求解器,当复杂仿真App需要毫秒级响应而DNN代理模型在GPU上完成训练——COMSOL Multiphysics 6.4正以三大GPU加速引擎重新定义工程仿真的效率边界。本文基于COMSOL官方GPU选型指南(GPU Selection Guidelines for COMSOL Computing),系统梳理cuDSS、DNN代理模型训练与时域显式压力声学求解器的GPU加速机制,并提供面向AI大模型本地部署的UltraLAB硬件配置全方案。
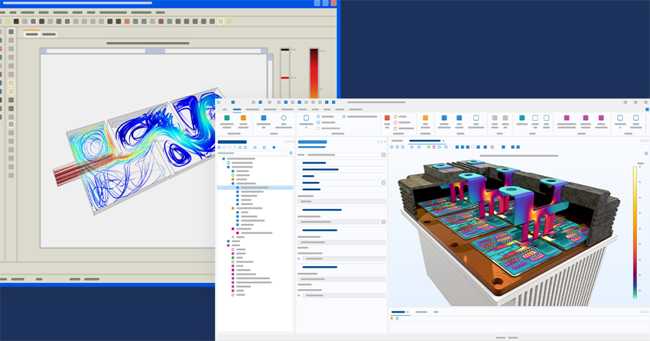
一、COMSOL GPU加速三大引擎:从稀疏矩阵到神经网络
 图1:COMSOL 6.4 GPU加速三大引擎——覆盖隐式直接求解、AI代理模型与显式波动仿真的全场景加速
COMSOL Multiphysics对NVIDIA GPU的支持目前聚焦三大核心应用场景,每种场景对GPU硬件特性的需求截然不同:
| 加速引擎 | 核心算法 | 精度需求 | GPU瓶颈 | 适用物理场 |
|---|---|---|---|---|
| cuDSS直接稀疏求解器 | NVIDIA CUDA Direct Sparse Solver(稀疏矩阵LU/Cholesky分解) | FP64双精度为主(部分模型可用FP32) | 显存容量 + 内存带宽(HBM > GDDR) | 所有物理场:结构力学、电磁、流体、传热、声学、多物理场耦合 |
| DNN深度神经网络代理模型 | 密集神经网络(Dense Network)前向/反向传播训练 | FP32单精度 | FP32计算吞吐量 | 全物理场(用于App Builder快速评估与优化循环) |
| 时域显式压力声学 | 间断伽辽金法(dG-FEM)+ 显式时间推进 | FP32单精度(默认),可选FP64 | 显存容量 + FP32吞吐量 | 压力声学(Pressure Acoustics, Time Explicit) |
版本要求:cuDSS和DNN训练支持从COMSOL 6.2起逐步引入,6.4版本实现全物理场cuDSS覆盖。时域显式压力声学的多GPU支持在6.4 Update 1中推出。
二、cuDSS:所有物理场的GPU稀疏直接求解革命
2.1 技术原理
cuDSS(CUDA Direct Sparse Solver)是NVIDIA提供的稀疏矩阵直接求解库,COMSOL 6.4将其深度集成到求解流程中:
- 求解对象:隐式时间步进、非线性牛顿迭代、特征频率分析、参数化扫描中产生的大型稀疏线性方程组
- 核心操作:Jacobian矩阵的LU分解(非对称)或Cholesky分解(对称正定)
-
精度模式:
- 双精度(FP64):默认模式,适用于结构力学、电磁等精度敏感场景
- 单精度(FP32):显存占用减半,在条件数良好的模型上可获得显著加速,尤其在工作站/消费级GPU上FP32速度远超FP64
2.2 多GPU与内存共享机制
cuDSS支持灵活的内存扩展策略:
| 内存模式 | 技术实现 | 性能影响 | 适用场景 |
|---|---|---|---|
| 单GPU显存 | 模型完全驻留单卡显存 | 最优性能,无额外开销 | 模型规模 < 单卡显存容量 |
| 多GPU NVLink共享 | 多卡显存池化,NVLink高速互联 | 影响极小(接近单卡性能) | 模型规模超过单卡但小于多卡总显存 |
| 多GPU PCIe共享 | 多卡通过PCIe共享显存 | 中等性能损失 | 无NVLink的多GPU工作站 |
| Hybrid混合模式 | GPU显存 + CPU RAM协同 | 显著性能损失(显存-内存带宽瓶颈) | 模型规模远超显存总量,仍需GPU加速 |
关键建议:在配置UltraLAB工作站时,优先保证单卡显存足够容纳目标模型,避免触发Hybrid模式导致的性能衰减。对于超大规模模型,选择NVLink互联的多GPU方案。
2.3 实测加速效果
- 声学换能器多物理场仿真:单张H100 GPU相比CPU求解实现8倍加速
- 穿孔板声传输模型:四块H100相比双路Xeon Platinum 8260实现近5倍加速
- FP32 vs FP64:在适合单精度的模型上,工作站级GPU的FP32性能可达FP64的30–60倍,带来额外数量级提速
三、DNN深度神经网络代理模型:让仿真App拥有毫秒级响应
3.1 技术定位
COMSOL的DNN代理模型训练功能将复杂的多物理场模型压缩为轻量级神经网络,嵌入App Builder或优化工作流中:
- 训练阶段:在GPU上使用行业标准库(如cuDNN)进行密集网络训练,完全基于FP32单精度
- 推理阶段:训练好的代理模型可在毫秒级完成参数扫描与结果预测,无需重新运行完整有限元仿真
- 网络类型:当前支持Dense Networks(全连接密集网络)
3.2 计算特征
DNN训练属于计算密集型(Compute-Bound)任务:
- 瓶颈:FP32持续吞吐量,而非显存带宽
- 加速比:即使中端GPU相比CPU也能带来显著提速
- 规模扩展:数据中心GPU适合大规模密集网络;工作站GPU适合中等规模;消费级GPU足以应对教程级/中小型网络
 图2:DNN代理模型工作流——将千万自由度有限元模型压缩为毫秒级响应的神经网络
四、时域显式压力声学:DG-FEM的GPU众核狂欢
4.1 算法特点
基于间断伽辽金有限元法(dG-FEM)的时域显式求解器:
- 无需求解大型线性方程组:每时间步仅执行局部单元更新与矢量运算
- 天然GPU友好:高度规则的数据访问模式与大规模并行性完美匹配GPU架构
- 精度选择:默认FP32,可切换FP64
- 规模能力:单张H100可处理数亿自由度的3D声学模型(如3亿自由度音乐厅模型数小时完成)
4.2 多GPU扩展
- 6.3版本:单GPU支持
- 6.4 Update 1:支持单机多GPU与GPU集群分布式计算
- 许可要求:多GPU加速需浮动网络许可证(FNL)
- 互联限制:不支持NVLink,多GPU通过PCIe或网络互联
五、NVIDIA GPU选型指南:数据中心 vs 工作站 vs 消费级
 图3:NVIDIA GPU三大类别——根据COMSOL应用场景精准选型
5.1 三类GPU核心特性对比
| 特性 | 数据中心GPU(H/B系列) | 专业工作站GPU(RTX PRO系列) | 消费级GPU(GeForce RTX系列) |
|---|---|---|---|
| 最大显存 | 最优(远超工作站级) | 优秀(如RTX PRO 6000 Blackwell 96GB) | 一般(最高约32GB) |
| 内存带宽 | 最优(HBM3E,如B100达2×4 TB/s) | 优秀(GDDR7,如RTX PRO 6000达1.8 TB/s) | 良好(GDDR6X/GDDR7) |
| ECC纠错 | 通常支持 | 通常支持 | 通常不支持(RTX 50系列支持单比特纠错,无可纠正错误报告) |
| 企业级驱动 | 支持(Production Branch) | 支持(Production Branch) | 不支持(仅Game Ready/Studio驱动) |
| FP64性能 | 最优(FP64:FP32 ≈ 1:2) | 一般(低于数据中心级) | 较弱(显著低于前两者) |
| 多GPU优化 | 支持NVLink,资源池化优化 | 支持多卡(未针对池化优化) | 支持多卡(未针对池化优化) |
| 典型型号 | H100、H200、B100、B200 | RTX PRO 6000、RTX 6000 Ada | RTX 5090、RTX 4090 |
5.2 按COMSOL应用场景的GPU选型策略
| 应用场景 | 首选GPU | 备选/升级方案 | 选型理由 |
|---|---|---|---|
| cuDSS大型模型(FP64) | NVIDIA H100/H200 80GB | NVIDIA B100/B200(HBM3E更高带宽) | FP64性能强 + HBM高带宽 + 大显存,稀疏直接求解瓶颈在内存带宽 |
| cuDSS中型模型(FP32) | NVIDIA RTX PRO 6000 96GB | NVIDIA RTX 6000 Ada 48GB | FP32速度极快 + 大显存 + ECC + 企业驱动,性价比优于数据中心卡 |
| DNN代理模型训练 | NVIDIA RTX PRO 6000 96GB | NVIDIA H100(大规模密集网络) | FP32吞吐量高 + 显存充足,工作站级足以应对大多数代理模型 |
| 时域显式压力声学 | NVIDIA RTX PRO 6000 96GB | NVIDIA H100(超大规模模型) | FP32默认 + 显存容量决定最大模型规模,工作站级性价比最优 |
| 教学/入门/小规模模型 | NVIDIA GeForce RTX 5090 32GB | NVIDIA GeForce RTX 4090 24GB | 成本效益高,但受限于显存容量与无企业驱动/ECC |
COMSOL官方建议:cuDSS应用优先选择数据中心GPU(H/B系列)以获得最佳性能;RTX PRO系列工作站GPU同样表现优秀;时域显式声学与DNN训练在RTX PRO系列上即可获得出色性价比。
六、应用场景:GPU加速如何改变工程仿真
| 应用场景 | 核心物理场 | GPU加速引擎 | AI价值 | 典型规模 |
|---|---|---|---|---|
| MEMS传感器多物理场耦合 | 结构-电磁-流体-传热 | cuDSS(FP64) | DNN代理模型实现参数化快速评估 | 百万–千万自由度 |
| 5G/6G天线阵列电磁仿真 | 电磁波(RF/微波) | cuDSS(FP64/FP32) | DNN优化天线几何参数 | 千万–数亿网格 |
| 电动汽车电池热管理 | 传热-流体-电化学 | cuDSS(FP32) | DNN实时预测不同工况下的温度分布 | 百万–千万自由度 |
| 汽车座舱/音乐厅声学设计 | 压力声学(时域显式) | dG-FEM GPU显式求解 | DNN代理模型替代重复声学仿真 | 千万–数亿自由度 |
| 航空发动机涡轮叶片热应力 | 结构力学-传热-流体 | cuDSS(FP64) | DNN预测不同转速/温度下的应力场 | 百万–千万自由度 |
| 半导体器件电热耦合 | 半导体-传热-电磁 | cuDSS(FP64) | DNN加速工艺参数优化 | 数十万–百万自由度 |
| 医疗超声换能器设计 | 声学-结构-压电 | cuDSS + 时域显式声学 | DNN实时优化换能器几何 | 百万–千万自由度 |
| 化工反应器多相流 | 流体-传热-化学反应 | cuDSS(FP32) | DNN代理模型用于在线控制优化 | 百万–千万自由度 |
七、UltraLAB硬件配置推荐
 图4:UltraLAB COMSOL多物理场仿真工作站——cuDSS、DNN与显式声学三位一体的算力平台
7.1 配置选型矩阵
| 配置等级 | 科研入门型 | 专业仿真型 | 旗舰加速型 | 集群扩展型 |
|---|---|---|---|---|
| 定位 |
教学/中小模型 DNN入门训练 |
中大型多物理场 cuDSS + DNN |
千万级网格 多GPU cuDSS + 声学 |
超大规模模型 分布式多GPU集群 |
| CPU |
Intel Core i9-14900K 24核 3.2GHz |
AMD Threadripper PRO 7995WX 96核 2.5GHz |
双路 AMD EPYC 9655 192核 2.4GHz |
双路 AMD EPYC 9755 256核 2.7GHz |
| 内存 | 64GB DDR5 | 256GB DDR5 ECC | 512GB DDR5 ECC | 1TB DDR5 ECC |
| GPU |
NVIDIA RTX 4090 24GB ×1 |
NVIDIA RTX PRO 6000 96GB ×2 (NVLink) |
NVIDIA RTX PRO 6000 96GB ×4 (NVLink) |
NVIDIA H100 80GB ×8 (NVLink + InfiniBand) |
| 系统盘 | 2TB NVMe Gen4 SSD | 4TB NVMe Gen5 SSD | 2×4TB NVMe Gen5 SSD (RAID 0) | 2×7.68TB NVMe Gen5 SSD |
| 数据盘 | 4TB SATA HDD | 2×8TB NVMe SSD | 4×16TB NVMe SSD | 并行存储阵列 100TB+ |
| 网络 | 千兆网卡 | 双万兆以太网 | 双万兆 + InfiniBand HDR | InfiniBand NDR 400G |
| 操作系统 | Windows 11 Pro | Windows 11 Pro / Linux | Linux (Rocky/Alma/RHEL) | Linux + Slurm调度 |
| 预估预算 | 3–5万元 | 18–28万元 | 45–65万元 | 150万元+ |
7.2 按COMSOL应用场景的精准配置
| 业务场景 | 推荐配置 | 关键硬件决策 |
|---|---|---|
| cuDSS双精度大型模型(结构/电磁) |
UltraLAB GX960 TR PRO 7995WX / 256GB / RTX PRO 6000 96GB ×2 (NVLink) |
FP64性能 + 显存容量是核心。RTX PRO 6000的FP64约2 TFLOPS,H100约9.7 TFLOPS;若预算充足且模型极大,优先H100 |
| cuDSS单精度中型模型(流体/传热) |
UltraLAB EX620i Xeon W7-3465X / 128GB / RTX PRO 6000 96GB |
FP32模式下RTX PRO 6000性能极佳,96GB显存可覆盖绝大多数中型模型,避免Hybrid内存模式 |
| DNN代理模型训练 |
UltraLAB GX960 TR PRO 7995WX / 256GB / RTX PRO 6000 96GB ×2 |
DNN训练纯FP32,FP32吞吐量优先;显存决定可训练网络规模,96GB可支持大型密集网络 |
| 时域显式压力声学(单机多GPU) |
UltraLAB DX1280 双路EPYC 9655 / 512GB / RTX PRO 6000 96GB ×4 |
显式声学多GPU不支持NVLink,通过PCIe互联;每卡独立运行子域,显存总和决定最大模型规模 |
| 时域显式压力声学(GPU集群) |
UltraLAB CX2560集群 双路EPYC 9755 / 1TB / H100 80GB ×8 (InfiniBand) |
需FNL浮动网络许可证;InfiniBand低延迟网络对分布式显式求解至关重要 |
| App Builder + DNN实时推理 |
UltraLAB EX620i Xeon W9-3495X / 128GB / RTX PRO 6000 96GB |
推理阶段GPU负载低,但大显存利于同时加载多个代理模型;CPU高频保证App UI响应 |
八、预装软件清单(开机即用)
| 类别 | 软件名称 | 版本/说明 | 用途 |
|---|---|---|---|
| COMSOL核心套件 | COMSOL Multiphysics | 6.4+(含GPU模块) | 多物理场仿真平台 |
| COMSOL Server | 6.4+ | 仿真App部署与Web访问 | |
| COMSOL Compiler | 6.4+ | 独立仿真App编译 | |
| COMSOL模块(按需) | AC/DC Module | 最新版 | 电磁场仿真 |
| Structural Mechanics Module | 最新版 | 结构力学分析 | |
| CFD Module / Heat Transfer Module | 最新版 | 流体与传热仿真 | |
| Acoustics Module | 最新版 | 声学仿真(含时域显式接口) | |
| MEMS Module / Semiconductor Module | 最新版 | 微机电与半导体器件 | |
| Optimization Module | 最新版 | 优化与DNN代理模型训练 | |
| AI/ML框架 | Python + Anaconda | 3.11+ | COMSOL LiveLink for MATLAB/Python脚本 |
| TensorFlow / PyTorch | GPU版本 | DNN代理模型外部训练与验证 | |
| Jupyter Lab | 最新版 | 交互式数据分析 | |
| 开发工具 | MATLAB | R2024a+ | LiveLink for MATLAB |
| Microsoft Visual Studio | 2022 Community | 外部C++接口开发 | |
| Intel oneAPI | 最新版 | MKL数学库优化 | |
| 系统与驱动 | NVIDIA CUDA Toolkit | 12.x | cuDSS与DNN训练运行环境 |
| NVIDIA GPU驱动 | Production Branch(企业级) | RTX PRO/H100企业级驱动,确保稳定性 |
九、常见问题硬件配置分析
Q1:cuDSS求解时提示显存不足,如何判断模型需要多大显存?
诊断方法:
- 先用CPU直接求解器(PARDISO或MUMPS)运行一次模型
- 在求解日志中查看报告的峰值内存使用量(Peak Memory Usage)
- GPU显存需求约为峰值内存的1.0–1.5倍(取决于矩阵稀疏结构与精度模式)
解决方案:
- 若模型接近显存上限:尝试切换至FP32单精度,显存占用减半
- 若模型超过单卡显存:配置多GPU NVLink(性能损失最小)或启用Hybrid模式(性能损失较大)
- UltraLAB推荐:为cuDSS应用预留至少20%显存余量,避免求解过程中因内存增长导致失败
Q2:RTX PRO 6000 vs H100,cuDSS求解到底选哪个?
| 对比维度 | NVIDIA RTX PRO 6000 96GB | NVIDIA H100 80GB |
|---|---|---|
| 显存容量 | 96GB GDDR7 ECC | 80GB HBM2e ECC |
| 内存带宽 | 1.8 TB/s | 3.35 TB/s |
| FP64性能 | ~2.0 TFLOPS | 9.7 TFLOPS |
| FP32性能 | ~120 TFLOPS | 67 TFLOPS |
| cuDSS FP64模型 | 良好(性价比高) | 最佳(带宽+FP64双优势) |
| cuDSS FP32模型 | 极佳(FP32速度远超H100) | 良好 |
| DNN训练 | 极佳(FP32吞吐量大) | 优秀(大规模网络) |
| 时域显式声学 | 首选(大显存+高FP32) | 升级选项 |
| 工作站部署 | ✅ 塔式/机架式均可 | ⚠️ 通常需机架式+专业散热 |
| 性价比 | ★★★★★ | ★★★☆☆ |
结论:若模型以FP32单精度为主(流体、传热、部分声学),或重点做DNN训练与时域显式声学,RTX PRO 6000 96GB是工作站级性价比之王;若模型必须FP64双精度且规模极大(结构力学、电磁),H100的带宽与FP64优势不可替代。
Q3:消费级GeForce RTX 5090能用于COMSOL生产环境吗?
可以使用,但有明确限制:
- ✅ 优势:FP32性能强劲,成本效益高,适合DNN训练入门、中小规模cuDSS(FP32)、时域显式声学
-
❌ 劣势:
- 显存最高32GB,大模型易触发Hybrid模式
- 无企业级Production Branch驱动,长期运行稳定性不如RTX PRO
- ECC支持有限(RTX 50系列仅单比特纠错,无不可纠正错误报告)
- FP64性能极弱,双精度模型求解缓慢
UltraLAB建议:GeForce RTX 5090适合个人科研、教学验证、中小模型快速迭代;企业级生产环境、关键项目交付、7×24小时运行场景,务必选择RTX PRO或数据中心GPU。
Q4:多GPU配置时,NVLink是必须的吗?
| 互联方式 | 适用场景 | 性能影响 | UltraLAB建议 |
|---|---|---|---|
| NVLink | cuDSS多GPU内存共享 | 影响极小(接近单卡性能) | cuDSS超大规模模型首选,RTX PRO 6000支持NVLink桥接 |
| PCIe 5.0 x16 | 多GPU通用互联 | 中等性能损失 | 无NVLink时的可行方案,cuDSS仍可用 |
| InfiniBand | GPU集群分布式 | 取决于网络延迟与带宽 | 时域显式声学多机集群必需;cuDSS一般不跨机分布 |
特别注意:时域显式压力声学的多GPU加速不支持NVLink,多卡通过PCIe或网络互联即可。
Q5:DNN代理模型训练需要多长时间?如何加速?
DNN训练时间取决于:
- 网络规模:隐藏层数量与每层神经元数
- 训练样本量:有限元仿真生成的输入-输出数据对数量
- 收敛精度:验证集误差阈值
加速策略:
- GPU选择:优先FP32吞吐量高的卡(RTX PRO 6000在FP32上速度极快)
- 批大小(Batch Size):在显存允许范围内最大化批大小,提升GPU利用率
- 早停策略:设置合理的验证集监控,避免过训练
- 数据并行:若样本量极大,可考虑多GPU数据并行训练(需自定义实现)
Q6:COMSOL模型在GPU上求解失败,如何排查?
| 故障现象 | 可能原因 | 解决方案 |
|---|---|---|
| "Out of GPU memory" | 模型规模超过显存容量 | 切换FP32、启用Hybrid模式、升级更大显存GPU、多GPU NVLink扩展 |
| 求解结果与CPU不一致 | FP32精度不足导致数值发散 | 切换回FP64双精度;检查模型条件数 |
| GPU利用率低(<50%) | 模型规模过小,GPU未饱和 | 增大模型自由度;检查是否启用GPU求解器(部分边界条件可能回退CPU) |
| 驱动崩溃/黑屏 | 消费级驱动稳定性不足 | 更换RTX PRO/数据中心GPU;安装Production Branch企业驱动 |
| 多GPU时仅单卡工作 | 许可证限制或配置错误 | 确认FNL许可证覆盖多GPU;检查COMSOL首选项中GPU设备选择 |
十、总结:COMSOL + NVIDIA GPU + UltraLAB = 多物理场仿真新范式
| 维度 | 传统CPU模式 | GPU + AI + UltraLAB新模式 |
|---|---|---|
| 直接求解速度 | PARDISO/MUMPS CPU求解,千万自由度模型数小时至数天 | cuDSS GPU加速,同规模模型提速5–8倍(H100级) |
| 声学仿真规模 | 隐式求解器受限于内存,百万网格即吃力 | 时域显式dG-FEM GPU求解,数亿自由度数小时完成 |
| App响应速度 | 每次参数修改需重新仿真,等待数分钟至数小时 | DNN代理模型毫秒级推理,实时交互优化 |
| 参数扫描效率 | 串行或有限并行,数百个参数点需数天 | DNN代理替代参数扫描,秒级完成全空间评估 |
| 硬件投入 | 双路CPU服务器,内存扩展成本高 | UltraLAB精准配置GPU算力,显存即内存扩展,性价比更优 |
COMSOL Multiphysics 6.4通过cuDSS将GPU加速从niche场景扩展为全物理场通用能力,通过DNN代理模型将AI融入工程仿真核心工作流,通过时域显式dG-FEM释放了GPU在波动方程中的极致并行潜力。这三大技术支柱,配合UltraLAB基于COMSOL官方GPU选型指南深度定制的高性能工作站,正在帮助全球工程师从"等待仿真结果"走向"实时交互设计"的智能仿真新时代。
参考资料:本文硬件选型建议基于COMSOL官方文档《GPU Selection Guidelines for COMSOL Computing》(原文链接),以及COMSOL 6.4 Release Highlights中关于GPU Acceleration的技术说明。
关于UltraLAB
UltraLAB是西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,专注为科学计算、工程仿真、AI训练等场景提供超频硬件配置方案。针对COMSOL Multiphysics多物理场仿真、ANSYS结构分析、CFD流体计算等应用,提供从单塔式工作站到GPU集群的全栈算力解决方案,所有配置均经过COMSOL官方GPU兼容性验证。


