






摘要与适用读者
ParaView 是 Kitware 主导开发的开源科学数据可视化与后处理平台,广泛用于 CFD、结构力学、电磁仿真与各类数值模拟结果的分析。与普通桌面软件不同,ParaView 采用客户端/服务器与数据并行架构:数据并行模式下每个进程处理约 1/N 的数据,而"数据必须能装进聚合内存"是其硬性边界。本文基于 Kitware 官方培训资料与 ParaView 文档,解析其负载特征,为单机工作站处理大模型后处理任务给出 UltraLAB 分档硬件建议。
适用读者:需要打开和处理大型 CFD/CAE 结果文件(数十 GB 级 Ensight、OpenFOAM、CGNS、XDMF 数据)的仿真工程师、可视化方向科研人员及 HPC 环境用户。
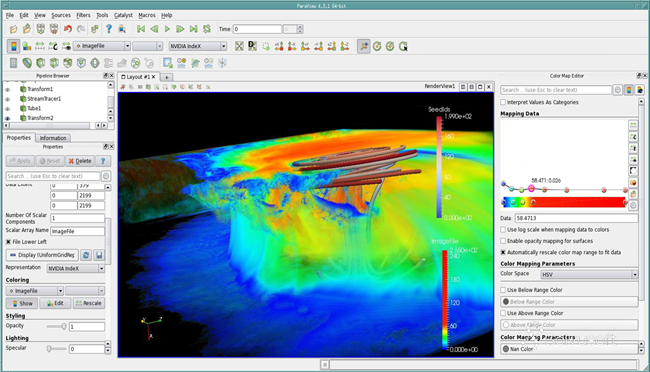
资料背景与核心观点
- 资料一:Kitware 官方培训讲义 Big Data Analysis with ParaView(Argonne 国家实验室 ATPESC 培训材料,Kitware 讲师 David DeMarle)。链接:https://wordpress.cels.anl.gov/atpesc/wp-content/uploads/sites/96/2015/03/DOEPV11-demarle-aug6-330.pdf
- 资料二:ParaView 官方文档。链接:https://docs.paraview.org/en/latest/
核心观点:
- 内存边界:并行 ParaView 处理的数据规模受限于聚合内存(aggregate RAM)——数据并行把流水线复制 N 份、每个进程处理约 1/N 的数据;内存至少要不小于文件大小,并额外容纳每个过滤器输出的中间结果。
- 并行需要 MPI:大数据处理必须启用 MPI 构建;官方预编译二进制不适合真正的并行场景,需要自行用 PARAVIEW_USE_MPI=ON 构建或使用集群上已装好的并行版本。
- Python 强烈建议开启:Python 支持脚本化、无人值守批处理(pvbatch)、可复现的参数研究。
- I/O 特征:写得好的读取器(ADIOS、Exodus、XDMF)只读本地数据块;"笨"读取器只有 rank 0 读数据再分发。多节点同时读时 NFS 有瓶颈,并行文件系统(Lustre 等)表现更好;单机场景下对应"项目盘要用高带宽 NVMe"。
- 显示/渲染:多 GPU 配置较复杂,每个 GPU 需独立显示或采用离屏渲染(--use-offscreen-rendering);多进程可共享同一 GPU 显示。
主要功能模块与核心算法
- 客户端/服务器架构:paraview 客户端负责交互界面;pvserver(数据/渲染服务器)承载数据与计算,可与客户端同机也可分离;pvbatch 提供无界面脚本批处理。
- 数据并行流水线:基于 VTK 的流水线在 MPI 进程间复制,各进程处理数据的子集(约 1/N),过滤器输出按引用共享输入以节省内存。
- 分布式渲染:sort-last 等并行渲染策略,可选 GPU 加速的硬件渲染或 OSPRay 等 CPU 光线追踪后端。
- 催化剂 Catalyst(原位可视化):在求解器运行过程中嵌入 ParaView 分析,减少落盘数据量(属进阶用法)。
- 进程诊断工具:如 Process ID Scalars 过滤器可显示各处理器生成/拥有的数据块,用于验证并行配置是否生效。
计算特点与性能瓶颈
- 内存容量是第一边界:数据 + 各过滤器中间结果必须装进(聚合)内存。单机场景下"工作站内存 ≥ 结果文件大小 ×(1.5—3 倍)"是实用的起步估算,链式过滤器越深、复制越多,余量越大。
- CPU 并行靠 MPI 多进程:过滤、抽取、统计类操作随进程数近似分摊;但进程数受限于内存复制开销与单机核数,单机通常 8—16 个 MPI 进程是合理区间。
- GPU 的角色是渲染而非通用加速:ParaView 的主体计算在 CPU 上;GPU 用于最终图像渲染与交互帧率。大型表面渲染、体渲染场景才明显受益,多数切片/等值面操作并不吃 GPU。
- I/O 敏感:读取器质量决定 I/O 效率;单机场景项目盘应为高带宽 NVMe,避免把数十 GB 结果放在机械盘或慢速网络上读取。
- 交互体验依赖单线程 + 显卡驱动:界面响应与视口操作对单线程性能与 OpenGL 驱动稳定性敏感。
典型应用场景
- 单机大模型 CFD 后处理:打开 20—100 GB 的瞬态 CFD 结果(如 OpenFOAM、Fluent 导出数据),做切片、流线、等值面与动画输出——内存容量决定能否打开,NVMe 决定读取速度。
- 参数研究批量出图:用 pvbatch/Python 脚本对多工况结果无人值守批量生成图像与统计表。
- 工作站内嵌并行 pvserver:单机以 MPI 模式启动 pvserver 处理单一大数据集,客户端同机连接。
- 远程渲染:工作站作为 pvserver 供笔记本客户端连接,数据不出机房(该模式下 GPU/CPU 与内存配比可参考高校集群实践,如按每 45 GB 内存配 1 核/1 GPU 的配额思路规划)。
UltraLAB 硬件配置建议
| 配置档位 | 入门(<10 GB 结果文件) | 主流(10—60 GB 结果) | 高性能(60—200 GB 结果/批处理中心) |
|---|---|---|---|
| CPU 选型思路 | 8—12 核,高主频 | 16—24 核,高主频,支持 8—16 个 MPI 进程并行过滤 | 32 核级,多进程并行 + 多任务排队 |
| 内存 | 64 GB | 128—192 GB(≥ 结果文件 2—3 倍) | 256—512 GB,ECC,面向聚合内存边界规划 |
| GPU 与显存 | 入门专业图形卡 | 中端专业图形卡(大体数据表面渲染、动画) | 高端专业图形卡或按需渲染卡;体渲染/大场景交互再上调显存 |
| 系统盘/项目盘/数据盘 | 1 TB NVMe;2 TB 数据盘 | 2 TB NVMe 项目盘独立;4—8 TB 数据盘 | 2×2 TB NVMe;8 TB 以上数据盘或高速 NAS |
| 散热/电源/扩展性/稳定性 | 风冷塔式,≥850 W | 强风道塔式,≥1200 W | 高塔/机架,冗余电源,长时间渲染稳定性优先 |
| 适用场景 | 常规 CAE 后处理教学与校核 | 研发级 CFD/CAE 大模型后处理 | 多用户共享的可视化服务器/批量出图节点 |
推荐理由与边界:ParaView 的核心公式是"内存 ≥ 数据 + 中间结果",预算优先级为内存 > 项目盘带宽 > CPU 核数 > 显卡。GPU 只负责渲染,除非做体渲染或超大场景交互,不必为 ParaView 单独追求高端计算卡;若需 MPI 并行版本,官方二进制不满足,需要编译或容器化部署,运维成本应计入决策。若数据持续增长到单机内存无法承载,应转向集群 pvserver 或 Catalyst 原位可视化,而非无限升级单机。
软件清单
| 软件 | 角色 | 必需/可选 |
|---|---|---|
| ParaView(桌面版) | 可视化客户端 | 必需 |
| pvserver / pvbatch(MPI 构建) | 并行服务器/批处理 | 可选(大数据必需) |
| MPI 实现(OpenMPI/MPICH) | 并行运行环境 | 可选(并行必需) |
| Python + pvpython | 脚本化与自动化 | 建议 |
| OSPRay / NVIDIA IndeX 插件 | CPU/GPU 高质量渲染后端 | 可选 |
| ParaView Catalyst | 原位可视化库 | 可选 |
常见问题
1. 为什么 20 GB 的 CFD 结果文件在 32 GB 内存的机器上打不开?
ParaView 除了装下原始数据,还要为每个过滤器的输出留内存;虽然部分输出按引用共享,但切片、计算变量、三角化表面等操作会生成新数组。经验上内存至少为文件大小的 2—3 倍才稳妥,20 GB 数据建议 64 GB 内存起步。
2. 单机用 pvserver 比直接打开桌面版强在哪?
pvserver 以 MPI 多进程并行执行过滤器,把数据分片到各进程处理,大过滤器链耗时近似按进程数分摊;同时 pvserver 会话的内存管理更清晰。数据小于几 GB 时差别不大,超过 10 GB 后优势明显。
3. 需要为 ParaView 买高端 GPU 吗?
多数后处理操作(切片、等值面、统计)在 CPU 上完成,GPU 只负责最终渲染。中端专业卡足以应对大多数表面渲染;只有大规模体渲染、实时光线追踪或超大场景交互才值得上高端卡。
4. 结果文件放机械盘行吗?
可以打开但体验差:读取器需要把数据搬进内存,机械盘的随机与持续带宽都会让"打开文件"和"切换时间步"变成分钟级等待。项目盘用 NVMe 是 ParaView 大模型场景性价比最高的单项投入之一。
5. 官方下载的 ParaView 为什么不能跑 MPI 并行?
Kitware 预编译二进制面向单机桌面使用;并行需要 PARAVIEW_USE_MPI=ON 的构建(或发行版的 paraview-mpi 包、容器镜像)。集群用户通常使用管理员预装的并行版本,工作站用户可自行编译或用 Spack/Docker 部署。
总结与选型建议
ParaView 后处理的选型公式是"内存装下数据,NVMe 喂饱读取,CPU 进程并行过滤,GPU 只管渲染"。主流研发场景(10—60 GB 结果文件)建议 16—24 核 + 128—192 GB 内存 + 独立 NVMe 项目盘 + 中端专业显卡;超过 100 GB 的数据集按"内存 ≥ 数据 2—3 倍"直接规划 256 GB 以上。并行版本需要 MPI 构建,提前规划部署方式;当单机内存装不下数据时,转向集群 pvserver 或原位可视化才是正确路径。
参考来源
- DeMarle D (Kitware). Big Data Analysis with ParaView(ATPESC 培训讲义). https://wordpress.cels.anl.gov/atpesc/wp-content/uploads/sites/96/2015/03/DOEPV11-demarle-aug6-330.pdf
- ParaView 官方文档. https://docs.paraview.org/en/latest/
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



