






【导语】 在汽车电子、AI服务器、航空航天等高端制造领域,系统级EMC(电磁兼容)仿真已成为产品研发的核心关卡。然而,面对千万级网格规模、多工具协同壁垒、S参数物理合规性管控等行业痛点,传统"人工+脚本"的仿真模式已触及效率天花板。本文深度解析基于Transformer多模态因果推理架构的智能EMC仿真Agent,揭示其核心技术原理、计算特征及UltraLAB图形工作站硬件配置方案,为科研单位与高端制造企业提供从算法到硬件的全栈参考。
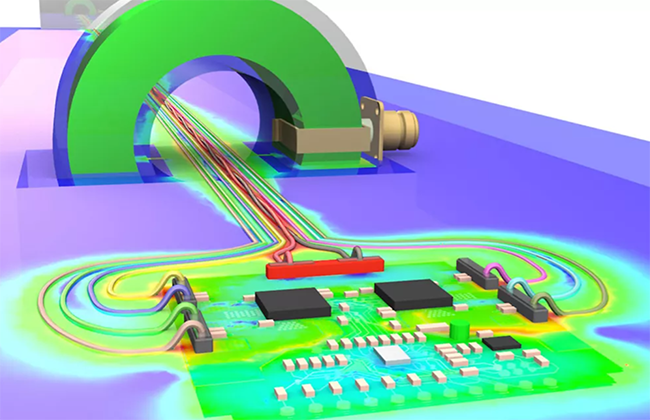
一、范式革命:从"人工试错"到"AI自主决策"
传统EMC仿真面临五大结构性痛点:多工具协同脱节(操作环节超20个,失误率>35%)、S参数非物理畸变(80%仿真偏差根源)、算力与精度不可调和、超标根因定位依赖10年经验、自动化脚本无进化能力。
智序电磁方案的核心突破,在于构建了"Transformer多模态统一表征-因果推理-自主决策-闭环进化"的专属智能框架。这不再是简单的脚本自动化,而是让AI成为具备"感知-决策-执行-学习"能力的仿真专家Agent:
-
多模态感知:融合几何(CAD/PCB)、电路(网表/SPICE)、规则(Datasheet/标准)、数据(S参数/场分布)的统一向量表征
-
因果推理引擎:实现"超标频点→辐射源→耦合路径→优化方案"的全链路根因定位
-
物理合规性管控:将无源性、因果性、互易性三大黄金准则嵌入建模-网格-求解-后处理全流程
二、核心技术架构:六层智能体系
2.1 Transformer核心决策引擎(技术中枢)
方案构建了5个专项微调Transformer模块,每个均嵌入EMC领域先验知识:
| 专项模块 | 核心算法能力 | 解决的传统痛点 |
|---|---|---|
| 全流程调度Transformer | 任务动态编排、异常自动修复、收敛性判定 | 固定流程脚本无法处理分支与异常 |
| 多工具协同Transformer | 7款工具API语义学习、跨格式数据自动转换 | 人工切换工具、格式转换错误 |
| S参数合规管控Transformer | 三大物理准则预判-校验-修正闭环 | 事后校验导致模型畸变、实测偏差大 |
| 收敛性优化Transformer | 网格质量-精度参数-收敛概率映射模型 | 经验设置导致算力崩溃或精度不足 |
| EMC因果推理Transformer | 多模态因果图构建、根因定位与优化生成 | 依赖专家经验、定位周期长 |
2.2 S参数全流程物理合规性管控(原创性核心)
这是方案的强制性创新模块,区别于传统事后校验:
-
互易性管控:建模阶段自动校验结构对称性,分布式并行校验全频段Sij与Sji偏差(<0.1dB),失效时执行无损对称化重构
-
无源性管控:基于希尔伯特变换与特征值分解,预判网格畸变影响,执行矩阵正则化修正(特征值≥0)
-
因果性管控:IFFT时域冲激响应验证(t<0区域<-40dB),频带扩展与均匀重采样消除超前响应
算法特征:采用分布式并行校验架构,将多端口S参数矩阵拆分至不同CPU节点并行计算,校验效率提升90%以上。
2.3 分布式记忆与知识进化系统
-
长期记忆:基于Milvus向量数据库存储EMC标准、案例库、优化方案,支持语义检索
-
短期记忆:Redis分布式缓存存储任务中间状态,支持Transformer上下文回溯
-
增量微调:基于历史仿真数据持续优化模型,实现"越用越智能"的正向循环
三、计算特点分析:多模态·分布式·高并发
3.1 计算密集型与内存密集型的双重特征
系统级EMC仿真呈现"双高"计算特征:
-
高频度矩阵运算:S参数校验涉及大规模复数矩阵的特征值分解、SVD、希尔伯特变换,计算复杂度O(n³)
-
超大规模网格:整车/整机级仿真网格规模达千万级,网格剖分与场求解需TB级内存支撑
-
多模态数据吞吐:几何模型(GB级)+ 频域数据(百MHz~GHz宽频扫描)+ 时域波形(高速信号)的混合处理
3.2 分布式并行架构设计
方案采用"任务级+数据级"双层并行:
-
流程并行:7个核心环节(建模→网格→S参数→求解→网表→后处理→优化)的流水线并行
-
域分解并行:
-
几何域:整机按功能模块(主板/电源/接口/线缆)分配至多节点并行建模
-
频域:宽频扫描任务拆分为子频段,分配至不同GPU/CPU节点并行求解
-
端口域:多端口S参数校验的分布式矩阵计算
-
3.3 Transformer推理的异构计算需求
-
模型推理:EMC专用Transformer(百亿级参数)的实时推理需GPU加速(TensorRT优化)
-
工具调用:Function Call模块的API序列生成需低延迟CPU响应
-
向量检索:Milvus数据库的 Embedding 检索需GPU加速(ANN近似最近邻算法)
四、软件生态系统与工具链
方案无缝对接7款主流仿真工具,构建全链路工具链:
表格
| 功能环节 | 核心软件 | 版本要求 | AI Agent交互方式 |
|---|---|---|---|
| 3D电磁仿真 | Ansys HFSS / CST Studio Suite | 2025+ | Python API + 脚本自动生成 |
| 电路仿真 | Cadence Sigrity / Keysight ADS / Synopsys HSPICE | 2025+ | 网表自动导入/结果提取 |
| 版图解析 | Cadence Allegro / Mentor Xpedition / Altium Designer | 最新版 | 格式转换中间件 |
| 数值计算 | MATLAB | R2025a | 矩阵运算、特征值求解、希尔伯特变换 |
| 几何处理 | Python (PyVista/Meshio) | 3.10+ | 几何特征提取、网格质量分析 |
| 数据管理 | Milvus + Redis + Lustre | 最新稳定版 | 向量存储、分布式缓存、并行文件系统 |
| 容器编排 | Kubernetes + Docker | 1.28+ | 任务容器化部署、资源动态调度 |
关键算法库依赖:
-
矩阵运算:NumPy/SciPy(CPU)、CuPy/CUDA(GPU加速)
-
网格处理:Gmsh、MeshIO(网格剖分与质量优化)
-
机器学习:PyTorch/TensorRT(Transformer推理)、Transformers(HuggingFace生态)
五、UltraLAB硬件配置方案推荐
针对Transformer智能EMC Agent的多模态数据处理、分布式并行计算、超大内存占用特征,推荐以下UltraLAB图形工作站/服务器配置方案:
配置一:智能建模与S参数校验工作站(单机旗舰级)
定位:适用于中小型系统(单板/模块级)EMC仿真,承担建模、S参数校验、网表生成等任务
| 组件 | 推荐规格 | 技术理由 |
|---|---|---|
| CPU | Intel Xeon W9-3595X (60核/120线程, 4.8GHz) 或 2× AMD EPYC 9754 (128核/256线程) | 高频多核应对几何建模与矩阵特征值计算;AMD方案适合超大规模并行S参数校验 |
| GPU | 2× NVIDIA RTX 6000 Ada (48GB显存) 或 2× RTX 4090 (24GB) | Transformer推理加速(FP16/INT8)、CUDA矩阵运算、Milvus向量检索GPU加速 |
| 内存 | 512GB DDR5-4800 ECC (8×64GB) | 千万级网格模型加载、S参数矩阵(100×100端口×1000频点)内存占用约200GB+ |
| 存储 |
系统盘:2TB NVMe Gen4 SSD 数据盘:8TB NVMe SSD (企业级U.2) 缓存盘:4TB NVMe SSD (Lustre客户端缓存) |
高速IO满足分布式存储访问;本地大容量缓存频繁访问的模型库与知识库 |
| 网络 | Dual 25GbE SFP28 (Mellanox ConnectX-4) | 连接Lustre分布式存储,保障多节点数据一致性 |
| 显示器 | 27英寸 4K IPS (色彩校准) | 场分布可视化、多窗口并行监控 |
UltraLAB型号推荐:UltraLAB AX430(Xeon W工作站)或 UltraLAB EA660(双路EPYC服务器级工作站)
配置二:分布式仿真计算节点(集群计算节点)
定位:系统级(整车/整机)大规模EMC仿真的分布式求解,支持Ansys HFSS/CST的GPU加速求解
| 组件 | 推荐规格 | 技术理由 |
|---|---|---|
| CPU | 2× Intel Xeon Platinum 8592+ (64核/128线程, 3.9GHz) | 高频优化单线程性能,提升网格剖分与后处理效率 |
| GPU | 4× or 8× NVIDIA A100/H100 (80GB显存, NVLink互联) | 大规模频域求解器GPU加速;多卡NVLink保障显存聚合与P2P带宽 |
| 内存 | 1TB DDR5-4800 ECC (16×64GB) | 匹配8卡GPU显存容量(640GB),避免CPU-GPU数据传输瓶颈 |
| 存储 |
本地:4TB NVMe Gen4 SSD (系统+缓存) 网络:Lustre客户端 (200Gbps IB) |
无本地大容量存储,依赖Lustre分布式文件系统统一数据共享 |
| 网络 | Mellanox ConnectX-6 (200Gbps InfiniBand HDR) + Dual 25GbE | IB用于MPI并行通信;25GbE用于管理面与存储访问 |
UltraLAB型号推荐:UltraLAB GX668(4/8路GPU服务器)或 UltraLAB GX660M(液冷静音GPU工作站,适合实验室环境)
配置三:知识库与向量检索专用节点
定位:Milvus向量数据库服务器,存储EMC领域知识库、历史案例、S参数模型库
表格
| 组件 | 推荐规格 | 技术理由 |
|---|---|---|
| CPU | 1× AMD EPYC 9354 (32核) 或 Intel Xeon W7-3465X (28核) | 多线程处理高并发向量检索请求 |
| GPU | 1× NVIDIA A30 (24GB) 或 RTX A6000 | GPU加速ANN索引构建与查询 |
| 内存 | 256GB DDR5-4800 ECC | 向量数据常驻内存,保障毫秒级检索延迟 |
| 存储 |
系统:1TB NVMe 数据:16TB NVMe SSD (RAID 0, 4×4TB) |
高IOPS支撑十亿级向量的随机读取 |
配置四:全流程开发测试工作站(算法工程师专用)
定位:Transformer模型微调、Agent流程开发、单节点功能验证
| 组件 | 推荐规格 |
|---|---|
| CPU | Intel Core i9-14900K (24核, 6.0GHz) 或 AMD Ryzen 9 9950X |
| GPU | 1× RTX 4090 (24GB) + 1× RTX 4080 (16GB)(双卡非SLI,独立任务) |
| 内存 | 128GB DDR5-6000 |
| 存储 | 2TB NVMe (系统) + 4TB NVMe (数据集) |
| 特性 | 静音设计,适合办公室环境;高频CPU加速Python脚本调试 |
六、应用价值与性能提升
基于上述软硬件配置,智序电磁Agent可实现:
-
效率革命:整车级EMC仿真周期从14天→18小时(缩短90%),网格剖分效率提升75%
-
精度保障:仿真与实测偏差从8dB→1.5dB,S参数物理合规性100%达标
-
一次过检率:从行业平均30%提升至85%以上,大幅降低研发返工成本
-
知识沉淀:自动构建企业专属EMC知识库,解决专家经验断层难题
七、结语:面向未来的智能电磁仿真基础设施
基于Transformer的EMC智能仿真Agent,不仅是算法的升级,更是研发范式的重构。它要求硬件基础设施从"单机高配"转向"分布式异构协同",从"通用计算"转向"AI+CAE融合算力"。
UltraLAB作为定制图形工作站与服务器解决方案提供商,针对此类"多模态数据+大模型推理+分布式CAE求解"的混合负载场景,提供从单机工作站到GPU集群的全栈硬件支撑,助力科研院所与高端制造企业抢占"AI+电磁仿真"的技术制高点。
【关于UltraLAB】
UltraLAB是西安坤隆计算机科技有限公司旗下定制图形工作站品牌,专注于CAE/CFD/电磁仿真/人工智能等领域的异构计算硬件解决方案,提供从边缘计算到集群算力的定制化部署服务。
UltraLAB是西安坤隆计算机科技有限公司旗下定制图形工作站品牌,专注于CAE/CFD/电磁仿真/人工智能等领域的异构计算硬件解决方案,提供从边缘计算到集群算力的定制化部署服务。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:xasun001



