






——通信系统滤波·耦合·非线性全链路算力解析
引言:当双工器成为5G/6G通信的"频率守门员"
在5G NR与即将到来的6G时代,频谱资源日益拥挤,双工器(Diplexer/Duplexer)作为同时处理发射(Tx)与接收(Rx)信号的关键组件,其性能直接决定通信系统的灵敏度与隔离度。基站滤波器需抑制邻道干扰>60dB,手机SAW/BAW双工器需在毫瓦级功耗下实现收发隔离>55dB,卫星通信微波双工器需在极端温度下保持频率稳定性——这些指标的背后,是电磁场精确求解、多物理场耦合、系统级非线性分析的复杂工程。
Ansys HFSS 作为三维全波电磁仿真的黄金标准,与 Keysight ADS 作为射频/微波系统级设计的工业标杆,构成了"器件物理精确提取 + 系统级行为级验证"的双工器设计完整工具链。然而,从腔体滤波器的多模谐振到微带双工器的耦合矩阵优化,从温度漂移的应力-电磁耦合到功率放大器的互调失真——每一项都对硬件算力提出了内存容量、频点并行、非线性迭代、多物理场协同的多重考验。
一、微波双工器的技术全景:从滤波器拓扑到系统级集成
1.1 双工器核心架构与仿真对象
| 双工器类型 | 核心技术 | 频率范围 | 关键物理效应 | 仿真重点 |
|---|---|---|---|---|
| 腔体滤波器 | 同轴/波导谐振腔、耦合窗 | 300MHz-6GHz | 高Q值、多模杂散、温漂 | 本征模、S参数、功率容量 |
| 介质滤波器 | 陶瓷介质谐振器(DR) | 800MHz-3GHz | 介电损耗、温度系数τf | 介电各向异性、热-电磁耦合 |
| SAW/BAW | 声表面波/体声波谐振 | 600MHz-3.5GHz | 压电效应、机电耦合系数Kt² | 固-声-电多物理场 |
| 微带/悬置线 | 半波长谐振器、耦合间隙 | 1-40GHz | 辐射损耗、色散、寄生通带 | 全波提取、布局优化 |
| LTCC/IPD | 低温共烧陶瓷、集成无源器件 | 1-10GHz | 层间耦合、通孔寄生、工艺偏差 | 多层电磁提取、统计优化 |
1.2 双工器核心指标与仿真挑战
频率选择性:
-
插入损耗 IL < 1.5dB(通带内)
-
回波损耗 RL > 15dB(通带内)
-
带外抑制 Rejection > 60dB @ f₀±100MHz
隔离与串扰:
-
Tx-Rx隔离 Isolation > 55dB
-
近端串扰 NEXT < -50dB
-
远端串扰 FEXT < -50dB
功率与线性度:
-
功率容量 P_max > 43dBm(基站)
-
无源互调 PIM < -153dBc(两载波+43dBm)
-
温漂系数 Δf/f < 3ppm/°C(卫星通信)
二、HFSS 核心算法深度解析:从本征模到全波S参数
2.1 有限元法(FEM)——三维全波提取的黄金标准
2.1.1 频域矢量波动方程
控制方程: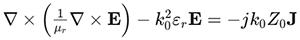
HFSS专用技术:
-
自适应网格细化:基于后验误差估计,自动加密场强集中区(边缘、拐角、耦合间隙)
-
无限元/完美匹配层(PML):辐射边界与吸收边界处理,吸收率>99.9%
-
端口求解器:波导端口(Wave Port)自动计算本征模,集总端口(Lumped Port)用于微带线
2.1.2 本征模求解器(Eigenmode)
数学问题:求解无耗腔体的谐振频率与场分布
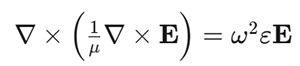
双工器应用:
-
腔体滤波器谐振频率初算
-
多模杂散抑制分析(识别高次模)
-
耦合系数k提取(Mij = f₀² × kij / BW)
计算特点:
-
仅需计算少量特征值(<20阶),但矩阵为广义特征值问题
-
稀疏矩阵直接求解器(MUMPS/PARDISO),内存需求O(N^1.5)
-
高Q值腔体条件数极差,需谱变换(Spectral Transformation)
2.1.3 驱动模求解器(Driven Modal)
数学问题:给定端口激励,求解S参数与场分布
核心算法:
-
端口本征模分析:计算波导端口的传播常数与模式场
-
全波FEM求解:建立整个结构的稀疏矩阵,施加端口边界条件
-
S参数提取:通过端口电压/电流计算反射/传输系数
双工器应用:
-
完整双工器S参数提取(S11, S21, S31)
-
多端口网络级联(Tx滤波器 + 天线开关 + Rx滤波器)
-
功率容量分析(电场击穿阈值)
计算瓶颈:
-
扫频分析:每个频点需重新组装/分解矩阵,计算量线性增长
-
密集频点:窄带滤波器(BW<1%)需1000+频点确保插值精度
-
多端口:N端口S参数矩阵维度N×N,端口间耦合需全矩阵计算
2.2 积分方程求解器(IE Region)——开放结构的高效选择
核心思想:仅对金属表面离散,通过格林函数建立积分方程
优势:
-
未知量数减少10-100倍(适合微带/共面波导等平面结构)
-
天然处理辐射边界,无需PML
-
适合PCB/封装基板等分层介质结构
计算瓶颈:
-
稠密矩阵:传统O(N²),快速多极子(FMM)降至O(N log N)
-
分层介质格林函数计算复杂,近场区需特殊处理
双工器应用:微带双工器、LTCC多层结构、天线-滤波器共址分析。
2.3 瞬态求解器(Transient)——TDR与眼图分析
算法原理:时域有限元法,直接求解
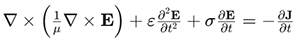
双工器应用:
-
TDR阻抗分析(识别阻抗不连续点)
-
窄脉冲响应(评估群延迟波动)
-
非线性器件瞬态响应(需与电路协同)
计算特点:显式/隐式混合时间积分,CFL条件限制Δt < Δx/(c√3),精细结构需极小步长。
三、ADS 核心算法深度解析:从电路级到系统级
3.1 谐波平衡仿真(Harmonic Balance)——大信号稳态分析
3.1.1 数学原理
假设电路处于周期稳态,将时域信号表示为Fourier级数:
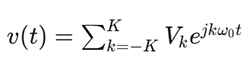
在频域求解非线性代数方程组:
F(V)=Ilinear(V)+Inonlinear(V)−Isource=0
核心算法:
-
Newton-Raphson迭代:每次迭代求解Jacobian矩阵
-
Krylov子空间加速:GMRES/BiCGSTAB处理大型Jacobian
-
混频产物自动计算:多音激励时自动包含所有交调频率
3.1.2 双工器系统级应用
功率放大器+双工器联合仿真:
-
PA非线性(AM-AM/AM-PM失真)→ 互调产物泄漏至Rx频段
-
双工器隔离度不足 → Tx噪声基底抬高Rx噪声系数
-
谐波平衡同时求解PA非线性与双工器线性网络
计算强度:
-
单音激励,5次谐波:1000个频域未知量,Newton迭代5-8次
-
双音互调(IMD3),7次谐波:5000个未知量,迭代10-15次
-
完整收发链路(PA+双工器+LNA+混频器):20000+未知量,内存需求50-100GB
3.2 包络仿真(Envelope)——宽带调制信号
核心思想:分离载波与包络,载波用谐波平衡处理,包络用时域慢变方程描述
双工器应用:
-
5G NR 100MHz宽带信号通过双工器后的EVM恶化
-
群延迟波动导致的符号间干扰(ISI)
-
数字预失真(DPD)与双工器记忆效应的联合优化
计算特点:载波-包络带宽比>1000,计算效率比纯时域仿真快100倍。
3.3 电路-电磁协同仿真
ADS + HFSS 联合流程:
plain
HFSS 提取双工器S参数(Touchstone格式,DC-6GHz,1000频点)
    ↓
ADS Data Access Component 导入S参数
    ↓
ADS电路仿真:PA → S参数双工器 → LNA
    ↓
谐波平衡/包络仿真:评估系统级IMD、噪声、ACPR
协同挑战:
-
S参数因果性:需通过Vector Fitting或Hilbert变换确保无源性
-
端口阻抗变换:50Ω系统与双工器实际阻抗(可能非50Ω)的匹配
-
温度效应:HFSS提取多温度S参数,ADS通过插值实现温度扫描
四、双工器设计关键场景:从滤波器拓扑到系统验证
4.1 腔体双工器设计
4.1.1 耦合矩阵综合
设计流程:
-
指标→耦合矩阵:根据通带BW、回波、隔离要求,综合N×N耦合矩阵M
-
拓扑实现:将耦合矩阵映射为物理结构(同轴腔、波导窗、交叉耦合)
-
HFSS优化:参数化建模,目标驱动优化(Goal Driven Optimization)
HFSS建模要点:
-
同轴腔:金属圆柱+调谐螺钉,边界条件为完美E壁
-
耦合窗: iris/窗口尺寸决定磁耦合系数k
-
输入/输出:同轴探针耦合,端口阻抗50Ω
计算强度:
-
单腔本征模:10万网格,2-3分钟
-
6腔双工器全波:200万网格,1000频点,64核并行,24-36小时
-
参数化优化(50变量,100迭代):总耗时1-2周
4.1.2 功率容量与无源互调(PIM)
物理机制:高功率下金属接触非线性(氧化层、微放电)产生互调产物
仿真方法:
-
线性近似:HFSS提取电场分布,估算峰值功率密度
-
非线性分析:ADS引入非线性电阻/电容模型,谐波平衡计算IMD3
计算特点:PIM仿真需考虑材料表面粗糙度、接触电阻等微观参数,HFSS网格需加密至亚毫米级。
4.2 SAW/BAW双工器设计
4.2.1 多物理场耦合挑战
SAW/BAW涉及固-声-电三场耦合:
-
电场:压电材料(AlN、PZT)的介电与压电效应
-
声场:弹性波传播(Rayleigh波、Love波、体波)
-
结构:薄膜应力、电极质量负载
仿真工具:
-
Ansys Mechanical + Piezo模块:固-电耦合,计算谐振频率与机电耦合系数Kt²
-
COMSOL Multiphysics:全耦合固-声-电,支持频域与瞬态
-
HFSS:电磁提取(忽略机械效应,适用于电极与封装寄生)
4.2.2 Mason等效电路模型
ADS建模:
plain
        C₀(静态电容)
           ||
    ┌──────┴──────┐
    │      L₁     │(动态电感,代表质量)
    │      C₁     │(动态电容,代表弹性)
    │      R₁     │(动态电阻,代表损耗)
    └─────────────┘
           ||
          GND
计算特点:Mason模型为集总参数,计算极快(毫秒级),但精度有限;全波仿真(HFSS/COMSOL)精度高但耗时巨大。工程实践中采用电路模型快速迭代 + 全波验证关键设计点。
4.3 微带/LTCC双工器设计
4.3.1 多层结构电磁提取
HFSS建模策略:
-
层叠结构:介质层(LTCC生瓷带,厚度50-100μm)+ 金属层(银浆,厚度10-20μm)
-
通孔模型:圆柱通孔(直径100μm)或电镀通孔,需考虑镀层厚度与粗糙度
-
端口:微带线集总端口,参考地平面
计算强度:
-
10层LTCC双工器:500万网格,1000频点,64核并行,36-48小时
-
参数化扫描(层厚偏差±10%):50设计点,总耗时2-3周
4.3.2 工艺偏差统计优化
蒙特卡洛分析:考虑层厚、线宽、介电常数的正态分布,评估良率。
ADS + optiSLang 联合优化:
-
变量:层厚h、线宽w、耦合间隙s、介电常数εr
-
目标:IL<1.5dB, RL>15dB, Isolation>55dB
-
约束:工艺能力(Cpk>1.33)
计算强度:1000次蒙特卡洛,每次HFSS提取+ADS评估,总耗时数周至数月。
五、软件工具链:HFSS + ADS 双工器设计生态
5.1 核心求解器矩阵
| 设计阶段 | 工具 | 核心算法 | 双工器专用功能 |
|---|---|---|---|
| 电磁提取 | HFSS | FEM(自适应、本征模、驱动模) | 多端口S参数、温度相关材料、PML辐射边界 |
| 电磁提取 | HFSS IE Region | 积分方程(MoM+FMM) | 微带/共面波导、PCB分层介质 |
| 电路设计 | ADS | Harmonic Balance、Envelope、Transient | 非线性器件、调制信号、系统级ACPR |
| 滤波器综合 | ADS Filter DesignGuide | 耦合矩阵综合、原型变换 | Chebyshev、Elliptic、Bessel拓扑 |
| 优化设计 | optiSLang | DOE、响应面、遗传算法、鲁棒性 | 多目标优化、统计偏差分析 |
| 电热协同 | HFSS + Icepak | FEM电磁 + FVM热 | 功率容量、温漂、热应力 |
| 多物理场 | HFSS + Mechanical | 电磁-结构耦合 | 压电效应、声表面波、应力频移 |
5.2 数据交互与自动化
| 接口类型 | 数据格式 | 工具链路 | 关键参数 |
|---|---|---|---|
| HFSS → ADS | Touchstone (.sNp) | Data Access Component | S参数、端口阻抗、参考频率 |
| ADS → HFSS | 参数化几何 (.py/.vbs) | Scripting API | 优化变量、约束条件 |
| 温度映射 | 温度场 (.csv) | External Data | 材料属性ε(T), μ(T), σ(T) |
| 优化驱动 | 目标函数 | optiSLang + HFSS/ADS | S参数目标、良率约束 |
六、硬件配置推荐:匹配双工器仿真的算力需求
6.1 算法-硬件映射分析
| 仿真任务 | 核心算法 | 计算特征 | 硬件瓶颈 | 优化方向 |
|---|---|---|---|---|
| HFSS本征模 | 广义特征值(Lanczos) | 少量特征值、矩阵条件数差 | 内存容量、单核性能 | 大内存ECC、高主频CPU |
| HFSS驱动模单频 | FEM直接求解 | 稀疏矩阵分解、复对称 | 内存带宽、单核性能 | 8通道DDR5、AVX-512 |
| HFSS扫频 | 频点重复求解 | 频点独立、embarrassingly parallel | CPU核数、License数 | 多路CPU、集群并行 |
| HFSS瞬态 | 时域有限元 | 显式/隐式混合、CFL限制 | GPU显存、CUDA核心 | NVIDIA A100/H100 |
| ADS谐波平衡 | Newton-Raphson + Krylov | 非线性迭代、Jacobian稠密 | 单核性能、内存容量 | 高主频CPU、大内存 |
| ADS包络 | 多速率混合 | 载波HB+包络ODE | 内存带宽、多核并行 | 多核CPU、大内存 |
| 蒙特卡洛优化 | 参数化DOE | 大量独立案例 | CPU核数、集群调度 | HPC集群、Slurm |
| 多物理场 | 电磁-热-结构耦合 | 多场迭代、数据交换密集 | 网络带宽、I/O | InfiniBand、Lustre |
6.2 分级配置方案
方案一:滤波器工程师桌面级(单频点/窄带设计)
适用场景:单腔/双腔滤波器初算、微带线阻抗验证、ADS电路级快速迭代、教学研究
UltraLAB A330 配置:
-
CPU:Intel Core i9-14900K(24核32线程,睿频6.0GHz)
-
优势:高主频加速HFSS自适应网格收敛与ADS Newton迭代,24核并行处理多频点
-
-
内存:128GB DDR5-5600 ECC(4×32GB)
-
依据:HFSS 200万网格约需60GB,ADS谐波平衡大信号需40GB
-
-
显卡:NVIDIA RTX 4070 Ti SUPER(16GB GDDR6X)
-
用途:HFSS后处理场可视化、ADS电路图渲染、小型瞬态GPU加速
-
-
存储:2TB NVMe Gen4 SSD + 4TB HDD
-
用途:SSD存放活跃项目,HDD存档S参数库与优化历史
-
-
软件:Ansys Electronics Desktop(HFSS)+ Keysight ADS
性能预期:
-
HFSS单腔本征模(10万网格):24核并行,5-8分钟
-
HFSS 4腔滤波器S参数(100万网格,100频点):24核并行,4-6小时
-
ADS谐波平衡(PA+双工器,5次谐波):24核并行,2-3小时
-
ADS包络仿真(100MHz 5G NR):24核并行,1-2小时
方案二:射频系统专业级(双工器全波+系统验证)
适用场景:6腔腔体双工器、LTCC多层双工器、基站滤波器功率容量、收发链路系统级仿真
UltraLAB GT430P 配置:
-
CPU:Intel Xeon W9-3495X(56核112线程,睿频4.8GHz)
-
优势:56核并行处理HFSS 1000频点扫频,AVX-512加速FEM矩阵运算
-
-
内存:512GB DDR5-4800 ECC(8×64GB)
-
依据:HFSS 500万网格需300GB,ADS大信号系统级仿真需200GB
-
-
显卡:NVIDIA RTX A6000(48GB GDDR6 ECC)
-
用途:超大规模网格可视化(腔体内部场分布)、HFSS GPU加速选项
-
-
存储:4TB NVMe Gen4 SSD(RAID 0,双盘,读速14GB/s)+ 16TB HDD
-
用途:高速读写大型S参数文件(单文件10GB+)与优化数据库
-
-
网络:Dual 10GbE
-
用途:License服务器、设计数据同步
-
-
软件:Ansys Electronics Enterprise + Keysight ADS + optiSLang
性能预期:
-
HFSS 6腔双工器(500万网格,1000频点):56核并行,24-36小时
-
HFSS 10层LTCC双工器(500万网格,1000频点):56核并行,36-48小时
-
ADS收发链路谐波平衡(PA+双工器+LNA,7次谐波):56核并行,8-12小时
-
ADS包络仿真(100MHz 5G NR,1000符号):56核并行,4-6小时
-
蒙特卡洛优化(100迭代):56核并行,总耗时3-5天
方案三:企业级HPC集群(大规模DOE+多物理场)
适用场景:5G Massive MIMO滤波器阵列、卫星通信多工器、SAW/BAW多物理场验证、AI辅助设计
UltraLAB CA660集群节点(每节点):
-
CPU:双路 AMD EPYC 9654(96核/路,共192核384线程,基频2.4GHz,Boost 3.7GHz)
-
优势:192核极致并行,同时运行16-32个HFSS频点或ADS设计点;大L3缓存(384MB)加速稀疏矩阵局部性
-
-
内存:2TB DDR5-4800 ECC(16×128GB)
-
依据:HFSS 2000万网格(大型波导双工器)需1.2TB,多物理场耦合预留
-
-
加速器:4× NVIDIA H100 NVL(94GB HBM3 per GPU,NVLink互联)
-
用途:
-
HFSS瞬态求解器GPU加速(TDR/窄脉冲分析)
-
ADS大信号系统级GPU加速(Tensor Core加速矩阵运算)
-
AI代理模型训练(神经网络替代部分HFSS提取)
-
-
-
存储:8TB NVMe Gen5 SSD(RAID 0,读速28GB/s)+ Lustre并行文件系统
-
用途:海量S参数/眼图数据(单项目1TB+)高速读写
-
-
网络:NVIDIA InfiniBand NDR 400Gb/s
-
用途:分布式HFSS扫频、多节点ADS协同、License共享
-
-
软件:Ansys Enterprise + Keysight ADS + optiSLang + Slurm调度
预估价格:单节点55-65万元,4节点集群220-260万元
性能预期:
-
HFSS大型波导双工器(2000万网格,2000频点):192核并行,72-96小时
-
HFSS参数化DOE(100设计点):4节点并行,总耗时3-4天
-
ADS 5G NR全链路系统级仿真(100MHz,10000符号):4节点并行,12-18小时
-
蒙特卡洛良率分析(1000次):4节点并行,总耗时1-2周
方案四:超频极致性能工作站(快速迭代+大信号非线性)
适用场景:PA+双工器联合优化、互调失真精细分析、快速设计迭代、竞赛/项目攻坚
UltraLAB OC-Xeon 定制配置:
-
CPU:AMD 锐龙pro 9985WX(64核,全核超频至4.5GHz,液冷散热)
-
优势:超频后ADS谐波平衡Newton迭代收敛提速35%,HFSS自适应网格加密更快收敛
-
-
散热:双360mm冷排+双水泵+PTM7950相变导热
-
技术:确保满载7×24小时稳定,CPU温度<75°C
-
-
内存:1TB DDR5-5600 ECC(8×128GB)
-
显卡:NVIDIA RTX 6000 Ada(48GB)
-
特殊配置:低延迟内存优化(CL32)、超频级主板(24相供电)
性能预期:
-
HFSS 4腔滤波器(200万网格,500频点):超频后12-16小时(对比默频18-24小时)
-
ADS PA+双工器谐波平衡(7次谐波,大信号):超频后6-8小时(对比默频10-14小时)
-
ADS包络仿真(200MHz 5G NR):超频后3-4小时
七、UltraLAB 技术优势:为微波双工器仿真深度定制
7.1 电磁求解器级优化
AVX-512 FEM加速:HFSS的稀疏矩阵运算经AVX-512优化,浮点吞吐量提升2倍,自适应网格迭代与频点扫描提速15%。
频点并行调度:针对HFSS扫频的embarrassingly parallel特性,优化Slurm作业调度,支持单License多节点并行,最大化License利用率。
GPU瞬态加速:与Ansys合作验证HFSS Transient的CUDA路径,H100在TDR/窄脉冲分析中提供5-10倍加速。
7.2 ADS大信号优化
高主频Newton加速:ADS谐波平衡的Jacobian矩阵分解对单核性能极度敏感,超频至4.5GHz后迭代收敛提速30-40%。
大内存谐波平衡:支持10000+频域未知量的大型系统级仿真(Massive MIMO阵列),内存容量不再是瓶颈。
7.3 可靠性设计
ECC全覆盖:从桌面级到企业级,全系ECC内存+显存(H100),杜绝电磁仿真中的单比特错误——在HFSS S参数提取中,0.01dB的误差可能导致滤波器通带边缘误判;在ADS谐波平衡中,0.1%的电压误差可能导致IMD3失真翻倍。
液冷静音方案:针对射频工程师办公环境,提供<35dB静音水冷方案,兼顾性能与工作环境。
八、结语:算力即带宽,精度即隔离度
在5G向6G演进的时代,频谱资源日益珍贵,双工器作为频率域的"守门员",其性能直接决定通信系统的容量与质量。从腔体滤波器的多模谐振到SAW的声表面波,从HFSS的三维全波提取到ADS的系统级非线性分析,每一步设计优化都需要算力的支撑。
UltraLAB深耕微波射频仿真硬件领域,深谙双工器设计的计算瓶颈——从HFSS的自适应网格迭代,到ADS的谐波平衡Newton求解,再到多物理场的耦合协同,我们提供从桌面到数据中心的全栈式算力基础设施。
当您的竞争对手还在等待单频点收敛时,UltraLAB用户已完成第三轮全频段优化迭代。
关于 UltraLAB
UltraLAB是西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,专注于微波射频仿真、CAE多物理场、科学计算等领域的算力基础设施研发。我们提供基于Intel Xeon、AMD EPYC及NVIDIA H100/B200的定制化工作站与服务器方案,支持CPU超频、液冷散热、ECC内存、多GPU NVLink互联等企业级特性,服务于国内众多通信设备、射频器件、卫星载荷研发机构。
本文技术参数基于公开资料与行业实践整理,具体配置请根据实际双工器类型、频率范围、软件授权类型及预算咨询UltraLAB技术顾问。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



