






从靶点发现到候选分子,从蛋白结构预测到细胞与基因治疗,AI 正在进入创新生物药研发的关键环节。但真正决定研发效率的,不只是模型,而是算法、数据、实验验证与算力能否形成闭环。
本文面向创新药企业、Biotech、CRO/CDMO、高校与医院科研平台,系统梳理创新生物药的重点项目、核心算法、计算特点、AI 推理应用与 UltraLAB 硬件选型,帮助团队把“买一台 GPU 服务器”升级为可验证、可扩展、可复现的研发基础设施建设。
先给结论:多组学靶点发现首先看 CPU、内存与存储;蛋白结构预测和生成式抗体设计重点看 GPU 显存及模型吞吐;分子动力学既看 GPU 也看精度与软件适配;多人研发平台则必须同时解决任务调度、数据安全、环境复现和备份。
本文目录
- 创新生物药有哪些重点项目
- 从靶点到候选药物:核心算法与计算特点
- AI 推理在研发流程中的真实价值
- 典型应用场景与算力需求
- UltraLAB 硬件配置怎么选
- 软件清单与平台环境
- 常见硬件配置问题与排查
- 采购与验收清单
一页看懂:创新生物药各环节需要什么算力?
| 研发环节 | 典型输入 | 核心计算 | 首要硬件 | GPU 必要性 |
|---|---|---|---|---|
| 多组学靶点发现 | WGS、RNA-seq、单细胞、蛋白组、临床表型 | 比对、差异分析、网络与因果推断 | CPU、大内存、NVMe | 传统流程通常不需要 |
| 蛋白结构预测 | 序列、多序列比对、复合物信息 | 深度神经网络与张量计算 | GPU 显存、CPU、系统内存 | 通常需要 |
| 抗体/蛋白生成设计 | 序列、结构、约束条件 | 蛋白语言模型、扩散模型、序列优化 | GPU 显存与吞吐 | 建议配置 |
| 抗体可开发性评估 | 候选序列与结构 | 聚集、疏水性、电荷、免疫原性风险预测 | CPU + GPU | 视模型而定 |
| 分子对接与虚拟筛选 | 蛋白口袋、配体或肽库 | 构象搜索、评分、重排 | CPU/GPU、NVMe | 取决于软件 |
| 分子动力学 | 蛋白、抗体、膜体系、溶剂 | 数值积分、非键相互作用 | GPU、CPU、高速互联 | 通常建议 |
| 细胞与基因治疗设计 | 向导 RNA、载体、TCR、单细胞数据 | 脱靶预测、序列设计、细胞状态建模 | CPU、大内存、GPU | 深度模型建议 |
| 核酸药物设计 | siRNA/ASO/mRNA 序列与靶标 | 二级结构、杂交、脱靶与稳定性预测 | CPU、内存;AI 模型用 GPU | 可选到建议 |
| 工艺与质量数据分析 | 光谱、图像、发酵/培养时序 | 异常检测、软测量、视觉与多变量建模 | CPU、GPU、可靠存储 | 按任务配置 |
| 科研知识库与研发助手 | 文献、专利、实验记录、SOP | RAG、向量检索、重排与生成 | GPU 显存、NVMe、内存 | 本地生成建议 |
选型口诀:组学看 CPU 和内存,结构生成看显存,动力学看 GPU 与软件,多人平台看调度,研发数据必须看安全与备份。
一、创新生物药有哪些重点项目?七条技术主线
创新生物药并不是单一的“抗体药研发”。它覆盖从生物大分子、活体细胞到核酸和递送系统的多种技术路线。不同路线的计算任务差异很大,不能用同一套硬件模板简单覆盖。
1. 单抗、双抗与多特异性抗体
重点项目:新靶点抗体发现、双特异性/多特异性抗体、抗体人源化、亲和力成熟、Fc 工程、免疫原性风险控制和可开发性优化。
计算任务:抗体序列分析、种系基因注释、CDR 建模、抗原—抗体复合物预测、界面分析、候选序列生成与多目标排序。
核心难点:高亲和力不等于好药物。表达量、聚集、黏度、稳定性、非特异性结合和免疫原性等性质需要共同评价,最终仍须实验验证。
2. ADC 与抗体偶联药物
重点项目:新靶点 ADC、连接子与载荷优化、位点特异性偶联、双载荷或新机制偶联药物。
计算任务:抗原表达与内吞相关数据分析、抗体选择性评估、连接子/载荷性质计算、偶联构象分析、药代与暴露相关建模。
**核心难点:**ADC 是抗体、连接子、载荷和偶联方式的系统组合。单独优化某一部分,并不必然改善整体治疗窗。
3. 重组蛋白、酶与多肽药物
重点项目:长效蛋白、酶替代疗法、工程化细胞因子、抗菌肽、环肽及新型结合蛋白。
计算任务:结构与功能预测、稳定性设计、酶口袋与底物通道分析、自由能计算、序列—功能建模和定向进化数据学习。
核心难点:蛋白设计通常是“活性—稳定性—表达—安全性”的多目标优化,需要生成模型、物理计算和湿实验迭代配合。
4. 细胞治疗
**重点项目:**CAR-T、TCR-T、TIL、NK 细胞、通用型细胞治疗及干细胞衍生治疗。
计算任务:受体序列设计、靶抗原选择、TCR/pMHC 识别分析、单细胞状态与耗竭特征研究、细胞亚群追踪、培养工艺数据分析。
核心难点:除了分子识别,还要理解细胞状态、持久性、异质性、制造一致性和临床相关风险,不能仅靠结构预测完成设计。
5. 基因治疗与基因编辑
**重点项目:**AAV 等载体基因治疗、CRISPR 编辑、碱基编辑、先导编辑及体内递送。
计算任务:向导 RNA 设计、在靶/脱靶预测、载体序列与包装相关分析、组织表达数据挖掘、编辑结果测序分析和群体变异注释。
核心难点:序列效率、组织特异性、免疫反应、脱靶和递送是相互关联的问题,需要计算、实验与质量体系协同。
6. 核酸药物与疫苗
**重点项目:**siRNA、ASO、mRNA、自扩增 RNA、环状 RNA、核酸适配体及新型疫苗。
计算任务:靶区域选择、二级结构与可及性预测、序列优化、脱靶分析、翻译相关特征建模、递送材料筛选和免疫原性相关风险评估。
核心难点:序列活性并不等同于体内有效性,化学修饰、递送、组织分布和稳定性共同决定研发结果。
7. AI 原生研发平台与自动化实验闭环
重点项目:生物基础模型、生成式蛋白设计、主动学习、Bayesian Optimization、自动化实验和研发知识库。
计算任务:模型训练/微调、批量推理、不确定性估计、实验优先级排序、向量检索、数据版本管理和模型监控。
**核心难点:**AI 的价值不在于一次生成多少候选,而在于每轮实验能否减少无效搜索、回写高质量数据并提升下一轮命中率。
对研发平台的真正要求,是把“多组学证据—分子设计—模拟评价—实验验证—数据回流”连成可复现流程,而不是堆叠互不连通的软件。
二、从靶点到候选药物:核心算法与计算特点
2.1 靶点发现:统计证据、网络证据与因果证据
相关算法:
- 序列比对、变异检测、差异表达和通路富集;
- WGCNA、蛋白互作网络、图嵌入与图神经网络;
- 单细胞聚类、细胞通讯、轨迹推断和空间解卷积;
- 孟德尔随机化、因果推断、多组学因子分析;
- 机器学习分类、生存分析与疾病分型。
计算特点:上游测序分析以 CPU、内存和存储为主;单细胞整合容易出现高内存峰值;图模型和深度表征学习可使用 GPU。靶点优先级应综合人类遗传学、疾病相关性、组织表达、安全性和可成药性,避免只按模型分数排序。
2.2 结构预测:从单体走向复合物与相互作用
相关算法:多序列比对、模板检索、Evoformer/Transformer、注意力机制、几何不变/等变网络、结构模块与置信度评估。
计算特点:
- MSA 构建、数据库检索和特征预处理可能消耗大量 CPU、内存及 I/O;
- 神经网络推理主要依赖 GPU,序列长度、复合物大小、采样数量和批量会影响显存与耗时;
- 多候选、多构象预测更适合批量流水线,而不是只看单条序列演示;
- 预测结构是一种计算假设,不能自动证明结合模式或功能。
2.3 生成式抗体与蛋白设计:序列、结构和约束共同驱动
相关算法:蛋白语言模型、掩码语言建模、自回归生成、扩散模型、逆折叠、能量引导采样、强化学习和多目标优化。
计算特点:批量生成和重评分属于典型 GPU 负载;显存决定模型、序列长度和批量的可行范围,吞吐决定每轮可评估的候选数量。若将生成、结构预测、对接和可开发性过滤串联,还需避免 GPU 等待 CPU 预处理或存储读取。
2.4 分子对接、自由能与分子动力学
相关算法:构象搜索、评分函数、蒙特卡洛采样、分子动力学数值积分、增强采样、MM/PB(GB)SA、自由能微扰和伞形采样。
计算特点:
- 大规模对接可分任务并行,CPU 与 GPU 均有可用实现;
- 分子动力学通常是长时间持续计算,GPU 性能、精度模式、体系规模和软件版本都影响速度;
- 轨迹文件增长快,需要高速活跃存储与独立归档空间;
- 计算结果对力场、质子化、溶剂和采样充分性敏感,不能只比较硬件跑分。
2.5 细胞、基因与核酸设计:小序列也可能对应大数据
**相关算法:**k-mer 与近似匹配、RNA 二级结构动态规划、热力学杂交模型、深度学习脱靶预测、序列到活性模型、单细胞生成模型。
计算特点:单个序列计算可能不大,但全基因组脱靶搜索、大规模候选扫描、多条件组合和单细胞数据整合会放大 CPU、内存和存储需求。深度模型推理可利用 GPU,传统热力学和搜索流程则通常更依赖 CPU。
2.6 主动学习:让 GPU 与实验资源都用在更值得验证的候选上
相关算法:高斯过程、随机森林、集成模型、贝叶斯优化、不确定性采样、预期改进和多目标帕累托优化。
计算特点:模型本身未必需要大 GPU,但需要可靠的数据管理、特征管线和版本追踪。主动学习的收益依赖实验数据质量、标签一致性和目标函数设计,不能把“闭环”简单理解为自动运行脚本。
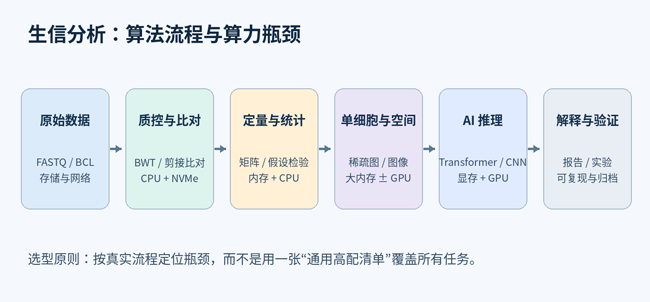
图 1:创新生物药 AI 研发闭环。算力服务于候选设计与实验迭代,而不是替代生物学验证。
三、AI 推理在创新生物药中的真实应用
3.1 批量结构与界面推理
适用于抗原—抗体、蛋白—配体、蛋白—多肽及多分子复合物的候选结构分析。工程重点不是“能否运行一次”,而是模型加载、数据库缓存、失败重试、批量队列、结果索引和置信度记录是否完整。
3.2 候选抗体与蛋白的生成—过滤—重排序
可将生成模型、逆折叠、结构预测和性质模型组合为候选漏斗:
目标约束 → 候选生成 → 序列唯一性/合理性过滤 → 结构与界面评价 → 可开发性预测 → 多样性选择 → 实验验证。
推理平台应保存模型版本、随机种子、输入约束和过滤阈值,确保候选能够追溯。
3.3 单细胞与空间组学基础模型
可辅助细胞嵌入、注释、扰动响应分析、疾病相关细胞状态识别和空间区域研究。此类项目常同时需要大系统内存和 GPU 显存:数据预处理可能吃内存,模型推理吃显存,不能只升级其中一项。
3.4 数字病理与细胞图像分析
适用于组织分型、细胞核分割、靶标表达辅助分析和细胞培养图像监控。全切片或高通量图像推理需要 CPU 解码、存储读取与 GPU 推理协同,单纯增加 GPU 不一定提高端到端吞吐。
3.5 研发知识库 RAG 与本地科研助手
可连接公开文献、专利、内部实验报告、SOP 和项目文档,用于证据检索、实验记录摘要和研发问答。涉及未公开管线时,应优先考虑本地推理、权限隔离、文档级访问控制、日志和防泄漏策略。
| AI 推理任务 | 关键配置指标 | 常见误区 |
|---|---|---|
| 蛋白结构批量预测 | 显存、GPU 吞吐、CPU/MSA、数据库缓存 | 只测单条短序列 |
| 生成式蛋白/抗体设计 | 显存、批量生成速度、后处理流水线 | 只统计生成数量,不看有效候选率 |
| 单细胞基础模型 | 系统内存、GPU 显存、数据预处理 | 忽略大规模矩阵副本 |
| 病理图像推理 | GPU、CPU 解码、存储吞吐 | 只看 GPU 利用率 |
| 本地研发大模型 | 显存、上下文、量化、并发 | 按模型文件大小估算显存 |
| RAG 知识库 | 检索质量、向量库、权限与模型推理 | 把 RAG 当作无需治理的聊天工具 |
**重要边界:**AI 推理可提高搜索和排序效率,但不能替代药效、药代、毒理、免疫原性、工艺和临床验证,也不应把预测置信度直接解释为研发成功概率。
四、典型应用场景:不同团队如何定义配置目标?
4.1 抗体发现团队
目标是缩短候选序列设计、结构分析和性质筛选的迭代时间。建议采用“GPU 推理工作站 + 大内存 + 高速 NVMe + 实验数据回写”的方案,重点测试真实抗原—抗体项目的批量吞吐。
4.2 细胞与基因治疗团队
上游靶点与载体设计依赖生信 CPU 流程,单细胞分析需要大内存,脱靶和细胞状态模型可使用 GPU。配置应优先保证数据链路完整与样本追溯,而非只投资模型训练。
4.3 核酸药物团队
序列扫描、二级结构和全基因组脱靶搜索适合 CPU 并行;若使用深度活性预测或递送材料模型,再配置相应 GPU。核酸候选组合量大时,应重点评估批量任务调度和结果数据库。
4.4 CRO/CDMO 与多项目研发平台
重点是多租户隔离、项目交付、软件版本复现、资源配额和数据安全。建议将 CPU 生信、GPU 推理、共享存储和备份分层建设,避免不同项目争抢资源或共用不受控的软件环境。
4.5 工艺开发与质量研究
细胞培养、纯化、光谱和视觉检测可引入时序预测、异常检测和多变量模型。若涉及受监管流程,应同步考虑审计追踪、权限、电子记录和变更控制,AI 模型不能绕过质量体系直接修改生产决策。
五、UltraLAB 硬件配置怎么选?四类平台覆盖不同研发阶段
以下为配置级别与选型区间建议,不是固定产品型号或性能承诺。最终方案应依据当期硬件平台、软件许可证、模型版本和真实项目测试确定。
5.1 方案 A:多组学与靶点发现工作站
适合:疾病机制、靶点筛选、WGS/WES、Bulk RNA-seq、单细胞、蛋白组与常规研发统计。
| 部件 | 建议配置思路 | 选择理由 |
|---|---|---|
| CPU | 高主频、多核心工作站级处理器 | 兼顾比对、定量与交互式统计 |
| 内存 | 128–512 GB ECC,按单细胞/多组学规模扩展 | 容纳索引、稀疏矩阵与中间对象 |
| GPU | 可选,按深度模型需求配置 | 传统组学并非必须,基础模型可受益 |
| 暂存盘 | 独立高耐久 NVMe SSD | 承担解压、排序、比对和临时文件 |
| 数据存储 | 大容量可靠存储 + 独立备份 | 保存原始数据、结果和参考数据库 |
| 网络 | 10GbE 起步,按共享存储升级 | 提升测序数据与项目文件传输效率 |
5.2 方案 B:蛋白结构预测与生成设计 GPU 工作站
适合:蛋白/抗体结构预测、生成式设计、逆折叠、界面分析和中批量候选筛选。
- GPU:先按最大模型、复合物规模、采样数和批量确定显存,再比较推理吞吐;需要并发或多模型串联时评估多卡或大显存方案。
- CPU:配置足量核心和 PCIe 通道,承担 MSA、特征处理、结构后处理与任务调度。
- 内存:建议为数据库检索、预处理、多任务缓存和系统服务留足空间,复杂项目可配置 256 GB–1 TB 或更高。
- NVMe:设置模型/数据库高速缓存区与项目活跃区,避免多任务反复读取慢速容量盘。
- 可靠性:采用适合长期满载的供电、散热和监控,记录驱动、框架与模型版本。
5.3 方案 C:分子模拟与 AI 融合计算服务器
适合:分子动力学、增强采样、自由能计算、高通量生成—预测—筛选流水线。
| 关键项 | 选型重点 | 验收方式 |
|---|---|---|
| GPU | 软件支持、显存、持续算力与多卡扩展 | 用真实体系测量 ns/day 或项目吞吐 |
| CPU | MD 预处理、分析、对接和任务并行 | 检查预处理是否让 GPU 空等 |
| 系统内存 | 大体系、轨迹分析和并发任务 | 记录峰值与交换情况 |
| 存储 | 高速活跃区、轨迹容量区、独立归档 | 测试持续写入与项目恢复 |
| 调度 | CPU/GPU/内存配额与优先级 | 多人并发和失败重跑测试 |
5.4 方案 D:企业级 AI 生物药研发平台
**适合:**Biotech 多管线团队、药企研发部门、CRO/CDMO 和公共技术平台。
建议采用分层架构:
- 数据层:原始组学、结构、序列、图像、实验结果与文档统一编目;
- CPU 计算层:生信流程、数据库搜索、统计分析和预处理;
- GPU 推理层:结构、生成、图模型、病理和本地大模型;
- **流程层:**Nextflow/Snakemake、容器、任务队列和模型版本管理;
- 知识层:项目数据库、向量检索、ELN/LIMS 接口与权限控制;
- 保障层:监控、日志、快照、备份、恢复演练与审计。
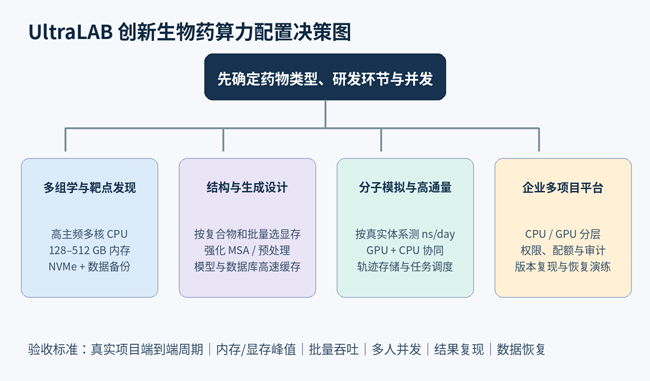
图 2:UltraLAB 创新生物药算力选型路径。先识别研发负载,再确定 GPU、CPU、内存和存储组合。
5.5 存储、安全与备份:研发平台的隐性生产力
- 原始数据、参考数据库、模型、候选结果和实验验证数据建议分层管理。
- RAID 提升可用性或性能,不能替代备份;重要项目应有独立副本和恢复演练。
- 模型文件、容器镜像和公共数据库可集中缓存,减少重复下载和版本漂移。
- 未公开管线、患者数据和合作方资料应实施最小权限、项目隔离和访问审计。
- 容量估算应包含原始数据、中间文件、轨迹、模型输出、版本副本和年度增长,而非只看当前数据集。
六、软件清单:从生信流程到 AI 推理与数据治理
| 软件层级 | 常见组件示例 | 主要用途 |
|---|---|---|
| 操作系统 | Ubuntu LTS、Rocky Linux 等 | 工作站与服务器基础环境 |
| 调度与流程 | Slurm、Nextflow、Snakemake、Airflow(按场景) | 资源调度、流水线与任务追踪 |
| 环境管理 | Conda/Mamba、Apptainer、Docker(按安全策略) | 依赖隔离与版本复现 |
| 通用生信 | BWA、SAMtools、BCFtools、GATK、FASTQ 工具 | 变异、比对和文件处理 |
| 转录与单细胞 | STAR、Salmon、DESeq2、Seurat、Scanpy、Cell Ranger | 表达、细胞状态和靶点证据 |
| 空间与多组学 | Squidpy、Giotto、MOFA+、mixOmics、WGCNA | 空间分析与跨组学整合 |
| 抗体序列分析 | IgBLAST、ANARCI 及编号/种系分析工具 | V(D)J、CDR 与序列标准化 |
| 结构与生成模型 | AlphaFold 类流程、蛋白语言模型、逆折叠/扩散模型 | 结构预测与候选生成 |
| 分子模拟 | GROMACS、AMBER、OpenMM、NAMD(按许可与适配) | MD、增强采样与轨迹分析 |
| 对接与分析 | AutoDock 类工具、PyMOL、ChimeraX、MDAnalysis | 构象搜索、可视化与后处理 |
| 核酸与基因编辑 | ViennaRNA、Cas-OFFinder 类工具及定制模型 | 二级结构、向导与脱靶分析 |
| AI 框架 | PyTorch、CUDA 工具链、ONNX Runtime(按模型) | 训练、微调与推理 |
| 机器学习 | scikit-learn、XGBoost、R/Bioconductor | 性质预测、统计与可开发性模型 |
| 知识与数据 | PostgreSQL、对象存储、向量数据库、Git/DVC | 项目数据、检索和版本管理 |
| 研发协作 | ELN/LIMS 接口、Jupyter、RStudio Server | 实验记录、交互分析和协作 |
| 运维安全 | 监控告警、日志审计、备份与访问控制 | 稳定性、安全与恢复 |
上述为常见软件生态示例,不表示所有工具均可直接组合。正式部署应核对模型权重及软件许可证、操作系统、驱动、CUDA、依赖库与数据使用条款,并通过容器或环境锁定保证可追溯。
七、常见问题:AI 生物药硬件配置与性能排查
Q1:创新生物药研发是不是必须先买多台高端 GPU 服务器?
不是。若当前主要工作是多组学、靶点挖掘和常规生信,CPU、大内存与 NVMe 可能更重要。只有结构预测、生成模型、分子模拟或本地大模型形成稳定负载后,GPU 投资才更容易转化为实际吞吐。
Q2:蛋白结构预测速度慢,一定是 GPU 不够强吗?
不一定。MSA、数据库检索、模板处理和存储读取可能占据大量时间。应分别记录预处理、GPU 推理和后处理耗时,再决定升级 GPU、CPU、内存还是数据库缓存盘。
Q3:模型能加载,为什么增大复合物或批量后显存溢出?
显存不仅保存模型参数,还保存中间激活、注意力相关数据、运行时缓存和批量输入。复合物规模、序列长度、采样数量和并发都会改变峰值,应按真实任务压测。
Q4:多 GPU 是否一定能让结构预测或分子动力学成倍加速?
不一定。加速取决于软件是否支持多卡、任务能否拆分、通信开销和流水线结构。有时多张卡分别运行独立任务,比单任务跨卡更容易提高总吞吐。
Q5:生成式抗体平台生成候选很多,为什么项目仍推进缓慢?
候选数量不是有效产出的充分条件。过滤标准、结构评价、可开发性、实验通量和数据回流都可能成为瓶颈。应统计从生成到实验验证的端到端周期与各轮有效率。
Q6:单细胞项目内存不足,增加 GPU 显存有作用吗?
对传统 Seurat/Scanpy 预处理通常作用有限。应优先检查稀疏矩阵、对象副本、整合方法和并发,必要时扩展系统内存;使用深度模型时再单独评估 GPU。
Q7:分子动力学该看 GPU 跑分还是实际 ns/day?
应看真实体系、力场、精度、时间步长和软件版本下的 ns/day,同时考虑轨迹写入与后续分析。不同体系的通用跑分不能直接代表项目性能。
Q8:GPU 利用率不高,但任务队列仍很慢,如何排查?
检查 CPU 数据预处理、数据库检索、磁盘等待、任务启动开销和小批量推理。可通过批量处理、数据库本地缓存、预处理并行和任务队列减少 GPU 空等。
Q9:本地大模型用于研发问答,显存怎么估算?
需综合模型参数精度、量化方式、上下文长度、KV Cache、并发和运行时开销,不能只按模型下载文件大小估算。最终应使用目标文档长度和并发数测试。
Q10:为什么 NVMe 很快,多项目运行时仍然卡顿?
可能是多任务争用同一暂存盘、内存不足触发交换、CPU 预处理拥堵或容量盘随机访问过多。应分开系统、数据库、活跃项目和归档存储,并设置资源配额。
Q11:RAID 能否满足研发数据安全要求?
RAID 不能防止误删除、勒索软件、文件损坏或所有故障。研发数据还需要独立备份、访问控制、版本管理和恢复验证;涉及合规场景时还需匹配相应质量体系。
Q12:UltraLAB 平台采购后如何验收?
使用真实项目固定模型与软件版本,记录端到端周期、预处理与推理耗时、CPU/内存/GPU 峰值、磁盘占用、并发吞吐、故障恢复和结果可复现性,而非只做短时跑分。
八、采购前请准备这 12 项参数
- 药物类型:抗体、ADC、蛋白/多肽、细胞、基因、核酸或疫苗;
- 研发阶段:靶点发现、候选设计、临床前、工艺或质量研究;
- 核心流程:结构预测、生成设计、MD、多组学、单细胞或 RAG;
- 模型信息:名称、版本、精度、许可证及是否支持多卡;
- 数据规模:序列/复合物大小、样本数、细胞数、图像和轨迹体量;
- 任务批量:每轮候选数、采样数、每日项目数与失败重跑比例;
- 交付目标:单轮迭代周期、每日吞吐与可接受排队时间;
- 用户规模:并发用户、项目隔离和资源优先级;
- 数据治理:保密级别、权限、审计、保留周期与备份要求;
- 网络条件:公共数据库、对象存储、实验设备和计算节点链路;
- **扩展计划:**GPU、内存、PCIe、盘位与共享存储扩展;
- 验收项目:一套可复现的真实流程及现有性能基线。
UltraLAB 配置建议:提供上述参数和代表性项目,可将“需要多高配置”转化为可验证的 CPU、内存、GPU 显存、NVMe、共享存储与任务调度组合。优先消除真实瓶颈,再保留扩展余量,让算力投入服务于候选质量、迭代速度与项目交付。
结语:AI 生物药的竞争力,是研发闭环而不是单点跑分
创新生物药研发正在从单一序列筛选走向多组学证据、结构预测、生成设计、物理模拟和实验验证的协同。不同环节对应不同算力:CPU 生信、大内存组学、GPU 推理、持续分子模拟与可靠数据平台缺一不可,但也没有必要一次性堆满所有资源。
对专业团队而言,更合理的 UltraLAB 方案应实现:靶点证据可追溯、候选设计可复现、AI 推理高吞吐、多人项目可隔离、实验数据能回流、研发资产可恢复。这才是算力真正转化为研发效率的路径。
参考与使用说明
- 北京市科学技术委员会、中关村科技园区管理委员会:《关于征集2025年度医药健康领域储备项目的通知》,其中创新药研发方向涵盖细胞与基因治疗、抗体药、ADC、多肽和核酸类等项目。
- 本文为计算平台选型指南,不构成药物研发、临床、投资或固定硬件性能承诺;具体路线应结合实验验证、法规、质量体系和真实项目测试确定。
- AI 生成及预测结果属于研发假设,不应直接用于临床决策,也不能替代药效、药代、毒理、免疫原性和工艺验证。
主题标签:#创新生物药 #AI制药 #抗体设计 #ADC #细胞与基因治疗 #核酸药物 #蛋白结构预测 #AI推理 #UltraLAB


