






摘要:STAR(Spliced Transcripts Alignment to a Reference)是 RNA-seq 数据分析事实上的标准比对器,以"用内存换速度"著称:论文实测其比对速度比 TopHat2 等同期工具快约 50 倍,代价是人类基因组索引常驻约 27GB 内存。本文解析这一权衡机制及其对工作站内存、CPU 与存储配置的直接推导。
适用读者:转录组学、单细胞组学、肿瘤基因组学方向的生物信息工程师;为核心实验室(core facility)规划测序数据分析平台的运维负责人。
资料背景与核心观点
本文参考以下公开资料:
- STAR 原始论文:Dobin A. et al., "STAR: ultrafast universal RNA-seq aligner", Bioinformatics 2013(PMC3530905,被引逾 6 万次)。关键事实:STAR 采用未压缩后缀数组(suffix array)+ 种子搜索策略实现剪接感知比对;在人类基因组实验数据上,12 线程下比对速度达 549.9 百万读段对/小时,而 TopHat2 仅 10.1、GSNAP 2.8——速度快约 50 倍;代价是约 27GB 内存常驻(后缀数组索引),且内存占用基本不随线程数增长(索引被所有线程共享);提供稀疏后缀数组选项,可将人类基因组内存降至 16GB 以下,代价是约 25% 的速度损失。
- STAR 官方 GitHub 仓库与手册(alexdobin/STAR)。提供基因组索引生成(--runMode genomeGenerate)、比对(含 2-pass 模式)、定量(--quantMode)与 chimeric 检测等完整功能;持续维护。
核心观点:
- STAR 是典型的内存换时间案例:索引常驻内存,线程共享,多线程不增加内存;这直接决定了工作站"内存先行"的配置逻辑。
- 比对本身是 CPU 密集 + 随机内存访问负载,GPU 无用武之地;速度提升靠线程数(论文显示 6→12 线程近线性提升)与内存带宽。
- 下游流程(排序、去重、定量)同样是 I/O 大户:FASTQ 输入、BAM 输出与排序中间文件要求 NVMe 级存储。
主要功能模块与核心算法
基因组索引生成(genomeGenerate)
从 FASTA + GTF 注释构建后缀数组索引。人类基因组(约 3Gb)索引文件数十 GB,构建过程本身需要约 30GB+ 内存与可观 CPU 时间;索引只需构建一次,之后常驻/加载复用。
比对核心(seed search + extension)
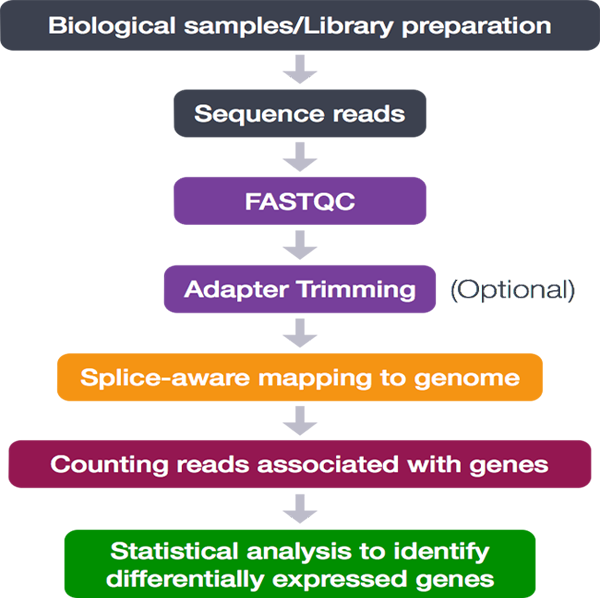
- 最大可映射前缀(MMP)种子搜索:在 suffix array 中查找读段的最长精确匹配种子,对种子进行聚类、拼接与延伸,天然感知剪接位点(跨越内含子)。
- 打分与输出:按错配/空位罚分输出 SAM/BAM;支持多比对位点处理与剪接 junction 定量输出(SJ.out.tab)。
- 2-pass 模式:第一遍发现新剪接位点,第二遍用增强索引重比对,提高新 junction 检出灵敏度。
定量与融合检测
--quantMode GeneCounts 在比对同时输出基因计数(等效 HTSeq-count);--chimSegment 检测融合转录本。STARsolo 模式直接输出单细胞表达矩阵。
计算特点与性能瓶颈
计算/内存密集特征
- 内存为第一硬约束:人类基因组约 27GB(稀疏索引 <16GB),更大基因组(小麦 ~16Gb)或高多倍体可轻松超 100GB。索引常驻,多任务并发时内存按实例数叠加(除非使用共享内存加载模式 --genomeLoad LoadAndKeep)。
- CPU:比对为整数/字符运算密集的内存随机访问负载,线程扩展良好(官方与社区经验 8—16 线程甜点区)。
串并行特征
- 单样本内部多线程并行;多样本更可取的是"每样本 8—12 线程 × 多实例并发"。
- 无 GPU 支持,无 MPI 跨节点模式——纯单机负载,这正是工作站(而非集群)适合它的原因。
I/O 与多任务特点
- 输入 gzip 压缩 FASTQ(解压吃 CPU)、输出 BAM 经 samtools 排序(内存与磁盘双密集);一个 30× 的 RNA-seq 样本全流程 I/O 可达百 GB 级。NVMe 项目盘相对 HDD 可明显缩短排序与去重时间。
- 典型 core facility 场景:一次下机 20—50 样本,排队并发处理,内存需求 = 实例数 × (索引+每实例开销)。
瓶颈排序
内存容量(索引+并发)> CPU 线程数与内存带宽 > NVMe I/O > 网络。
典型应用场景
- 常规 bulk RNA-seq:人类/小鼠样本,每样本 20—50M reads,8—12 线程 10—30 分钟级完成;核心实验室按并发实例数规划内存。
- 低起始量/全长转录组:2-pass 模式提高新剪接位点检出,双遍比对,时间×2。
- STARsolo 单细胞预处理:替代 Cell Ranger 的开源路线,内存画像类似,吞吐更高。
- 非模式生物:大基因组(植物、多倍体)索引构建内存是首要瓶颈,需按基因组大小×经验系数预估(官方手册给出基因组大小与内存的关系参数)。
UltraLAB 硬件配置建议
分档配置表
| 项目 | 入门配置(单研究者/小样本量) | 主流配置(课题组/核心实验室) | 高性能配置(测序平台配套) |
|---|---|---|---|
| CPU 选型思路 | 16 核高主频桌面/入门工作站 CPU | 32—48 核(至强 W / EPYC 单路),支持 3—4 个比对实例并发 | 64—96 核(EPYC 双路/单路高规格),按"12 线程 × N 样本并发"规划 |
| 内存 | 64—128GB(人/小鼠单实例+下游) | 256GB ECC(4 实例 × ~35GB + 排序余量) | 512GB—1TB ECC(8+ 实例并发或大基因组索引) |
| GPU 与显存 | 不需要(纯 CPU 负载) | 不需要 | 不需要;若同机跑深度学习变异检测等再另配 |
| 系统盘 | 1TB NVMe SSD | 1TB NVMe SSD | 1—2TB NVMe SSD |
| 项目盘 | 2TB NVMe SSD(FASTQ/BAM 热数据) | 4TB NVMe SSD | 4—8TB NVMe SSD RAID |
| 数据盘 | 8TB HDD | 16TB HDD/RAID | 32TB+ RAID/NAS 归档原始下机数据 |
| 散热/电源/扩展 | 风冷,750W | 风冷,1000W | 机架/塔式高规格,1600W 冗余 |
| 适用场景 | 月数十样本、人/小鼠 | 月数百样本、多物种 | 测序仪直连、批量自动化流水线 |
推荐理由与升级方向
- 内存按"并发实例 × 索引大小"规划:人类索引约 27GB/实例(或用 LoadAndKeep 共享加载摊薄),留出排序(samtools sort 默认每线程 768MB 级)与下游 R/Python 分析余量。
- CPU 甜点区 8—16 线程/实例:盲目给单样本 32 线程收益递减,不如拆成多实例并发,核心利用率更高。
- 升级路径:先加内存(最直接提升并发),其次扩 NVMe 容量;GPU 仅在引入深度学习工具(如 DeepVariant)时才有意义。
- 大基因组提醒:植物/多倍体基因组索引构建内存可能远超人类,采购前用官方手册参数按基因组大小核算。
软件清单
| 类别 | 软件 | 作用 | 必需性 |
|---|---|---|---|
| 比对器 | STAR(含 STARsolo) | RNA-seq 剪接感知比对 | 必需 |
| 索引与格式 | samtools、HTSlib | BAM 排序/索引/去重 | 必需 |
| 质控 | FastQC、MultiQC、fastp | 下机数据质控与修剪 | 推荐 |
| 定量 | STAR --quantMode / featureCounts / Salmon | 基因/转录本定量 | 必需(三选一或组合) |
| 下游分析 | R/Bioconductor(DESeq2、edgeR)、Python(scanpy) | 差异表达与统计 | 推荐 |
| 流程管理 | Snakemake / Nextflow、Conda/Bioconda | 流水线与依赖管理 | 推荐 |
| 可视化 | IGV、RStudio | 比对浏览与分析环境 | 可选 |
常见问题(FAQ)
Q1:STAR 一定要用 32GB 以上内存吗?
做人类/小鼠基因组比对,是——论文给出的索引常驻约 27GB,整机建议 64GB 起步。稀疏后缀数组可压到 16GB 以下但慢约 25%;模式小基因组(酵母、斑马鱼)需求相应更低。
Q2:GPU 能加速 STAR 吗?
不能。STAR 是纯 CPU + 内存随机访问负载,没有 GPU 实现。把预算投给内存容量与线程数。
Q3:线程数给多少最划算?
官方基准显示 6→12 线程近线性;社区经验 8—16 线程/实例为甜点区,更高线程受 I/O 与实现开销限制。多样本并发优于单样本堆线程。
Q4:机械硬盘能跑吗?
比对阶段主要吃内存与 CPU,HDD 也能跑;但 samtools 排序、去重与多样本并发时 NVMe 的优势明显。建议至少项目盘用 NVMe,冷数据放 HDD。
Q5:和 HISAT2 怎么取舍?
HISAT2 内存占用小得多(数 GB 级),适合内存受限环境;STAR 速度与剪接检出能力更强,是核心实验室主流选择。内存够就选 STAR,不够再考虑 HISAT2。
总结与选型建议
STAR 工作站的核心逻辑是"内存按索引×并发配、线程按 8—16/实例配、存储热冷分层、不配 GPU"。入门档 16 核 + 128GB + 2TB NVMe 覆盖个人转录组研究;核心实验室 32—48 核 + 256GB 支持 3—4 样本并发;测序平台级按 12 线程×N 样本核算 CPU 与内存。采购前以典型样本(FASTQ 规模、基因组版本)做端到端基准验证最可靠。
边界与核实事项
- 论文基准基于 2012 年硬件,绝对速度仅供相对比较;现代 CPU 上绝对值更高,但"内存约 27GB、快约 50 倍"的相对结论仍然成立。
- 非模式生物内存需求请按 STAR 手册中基因组大小相关参数核算。
- STAR 采用 GPLv3 许可,可自由用于学术与商业分析。
参考来源
- Dobin A. et al., "STAR: ultrafast universal RNA-seq aligner", Bioinformatics 2013(PMC 全文)— https://pmc.ncbi.nlm.nih.gov/articles/PMC3530905/
- STAR 官方 GitHub 仓库与手册 — https://github.com/alexdobin/STAR
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



