






摘要:Cell Ranger 官方系统要求页面给出了清晰的分级硬件指标:最低 8 核 CPU 与 64 GB 内存,推荐 64 核与 128 GB;处理约 100 万细胞级大型数据集时官方表格要求 32 核 CPU、512 GB 内存与 2 TB 磁盘。本地模式默认使用全部可用核心与 90% 可用内存。这意味着单细胞分析工作站的核心矛盾是内存容量与 CPU 核心数,GPU 几乎不参与。
适用读者:单细胞转录组/多组学科研人员、生物信息工程师、测序数据本地化分析平台建设者。
一、资料背景与核心观点
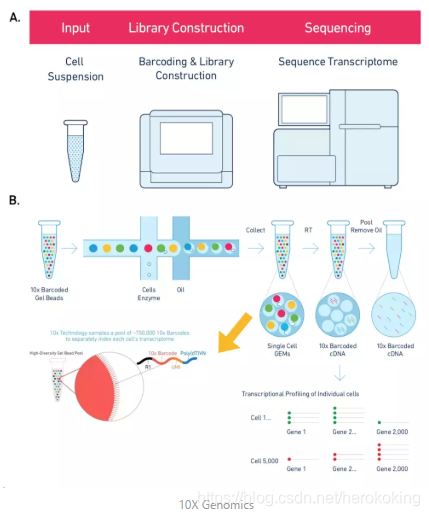
- 资料名称:Cell Ranger System Requirements(含数据集规模分级表与 EC2 实测性能表)
- 发布机构:10x Genomics 官方支持站点
- 原文链接:https://www.10xgenomics.com/support/software/cell-ranger/downloads/cr-system-requirements
官方页面核心观点:
- 最低要求:8 核 Intel/AMD CPU(需支持 AVX 指令集,未来要求 AVX2)、64 GB 内存、1.5 TB 可用磁盘;推荐 64 核、128 GB。
- 存储介质建议:为获得最佳性能推荐 NVMe/SSD,优于机械硬盘。
- 数据集分级表(保证运行时间小于 2 天):2 万细胞级小数据集 8 核/64 GB/0.5 TB;32 万细胞级中数据集 8 核/64 GB/1 TB;100 万细胞级大数据集(Flex v2,GEX+AB+CRISPR,500 特征)需 32 核/512 GB/2 TB。
-
资源占用模式:本地模式(
--jobmode=local)默认使用全部可用核心与 90% 可用内存,可用--localcores/--localmem限制;官方实测表(Cell Ranger v10.1)显示 100 万细胞数据集存储高水位约 1.6 TB。
二、主要功能模块与核心算法
- FASTQ 预处理与比对:基于 STAR 算法的剪接比对将 reads 定位到参考基因组——CPU 密集、内存密集。
- 细胞条码校正与 UMI 计数:纠错、去重与基因-细胞矩阵构建。
- 特征条形码/CRISPR/VDJ 等扩展分析:多组学模块叠加增加内存与计算。
- 聚类与降维:内置 PCA、t-SNE/UMAP 与聚类,用于快速质控预览。
- 调度与并行:基于 Martian 框架的流水线管理,本地模式自动占用整机资源;支持 Slurm 集群模式处理大数据集。
三、计算特点与性能瓶颈
| 维度 | 特征分析 |
|---|---|
| 计算特征 | 比对与计数为主,CPU 密集且高度并行;官方实测显示核心数增加可显著缩短墙钟时间(收益随规模递减) |
| 并行方式 | 单机多线程并行;集群模式(Slurm)用于超大数据集;无 GPU 加速环节 |
| 内存需求 | 官方推荐 128 GB 起步,大数据集 512 GB;默认占用 90% 内存,内存不足直接失败 |
| 存储需求 | 原始 FASTQ、中间文件与输出并存,官方高水位实测大数据集约 1.6 TB;NVMe 对整体时长有可感知影响 |
| I/O 特点 | 大规模顺序读写为主,中间文件多;机械盘会成为瓶颈 |
| 多任务特征 |
多样本并行跑多条流水线时,内存需求按并发数成倍增加,需用 --localcores/--localmem 切分资源
|
四、典型应用场景
- 科研方向:单细胞转录组(3'/5'/Flex)、免疫组库(VDJ)、空间转录组(Space Ranger)与多组学(Multiome/ARC)。
- 数据规模:单样本数千细胞(数 GB FASTQ)到百万细胞级队列(数百 GB—TB 级)。
- 工作流程:测序下机 FASTQ → cellranger count/multi → Loupe Browser 质控 → 下游 R/Python 分析(Seurat/Scanpy)。
- 时效要求:官方以“2 天内完成”为分级基准;课题组合并队列或临床样本时效要求更高时需上调配置。
五、UltraLAB 硬件配置建议
说明:单细胞流水线的选型顺序为“内存 ≥ 官方分级表 → CPU 核心数 ≥ 推荐值 → NVMe 容量 ≥ 高水位的 2 倍”。GPU 不在 Cell Ranger 计算路径中。
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 存储(系统/项目/数据) | 散热/电源/扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门级 | 16 核级 CPU(支持 AVX2) | 128 GB | 无需计算 GPU;亮机/核显即可 | 1 TB NVMe 系统盘 + 2 TB NVMe 数据盘 | 静音塔式,750 W | 2 万—10 万细胞级样本、单样本串行 |
| 主流级 | 32–48 核 CPU | 256–512 GB ECC | 无强制 GPU 需求 | 1 TB NVMe 系统 + 4 TB NVMe 数据盘 + HDD 归档 | 强风道,1000–1200 W | 数十万细胞多样本并行、VDJ/多组学 |
| 高性能级 | 64 核级高核心数 CPU,多内存通道 | 512 GB–1 TB ECC | 无强制 GPU 需求 | 2 TB NVMe 系统 + 8 TB+ NVMe 热数据 + 大容量归档 | 机架式、冗余电源、持续满载散热 | 百万细胞级数据集、多用户共享、大队列时效性分析 |
升级方向:内存不足导致失败/降速时优先扩内存至官方分级表以上;样本排队严重先加核心并合理设置 --localcores/--localmem 并发切分;磁盘高水位逼近容量上限时优先扩 NVMe 数据盘。
六、软件清单
| 类别 | 软件 | 说明 | 必需/可选 |
|---|---|---|---|
| 分析流水线 | Cell Ranger(count/multi/vdj 等) | 官方免费软件,需 Linux | 必需 |
| 参考数据 | 官方 reference(人/小鼠基因组等) | 随版本下载,数十 GB | 必需 |
| 运行环境 | 64 位 CentOS/RHEL 8 或 Ubuntu 20.04 等(见官方 OS 支持页) | ulimit 需按官方建议调高 | 必需 |
| 编程工具 | R(Seurat)、Python(Scanpy) | 下游分析与统计 | 可选 |
| 可视化/后处理 | Loupe Browser、CellBender 等 | 矩阵检查与去噪 | 可选 |
| 集群调度 | Slurm(集群模式) | 超大数据集 | 可选 |
七、常见问题(FAQ)
Q1:Cell Ranger 需要 GPU 吗?
不需要。其比对、计数与降维全部为 CPU 负载,官方系统要求中没有任何 GPU 指标;预算应全部投向 CPU、内存与 NVMe。
Q2:64 GB 内存能跑多大的数据?
官方分级表中小/中数据集(至 32 万细胞级)以 64 GB 为基线;100 万细胞级要求 512 GB。由于本地模式默认占用 90% 内存,内存不足不是“变慢”而是直接失败,务必按最大数据集规划。
Q3:为什么官方同时给出核心数和内存的推荐值?
两者需匹配扩展:核心数决定比对/计数的并行吞吐,内存决定可容纳的数据规模与中间结果;只加核不加内存,或反之,都会让另一部分成为瓶颈。
Q4:同一台机器能同时跑多个样本吗?
可以,但要为每条流水线用 --localcores/--localmem 显式划分资源;否则默认模式会各自争抢 90% 内存与全部核心,导致互相拖垮。
Q5:磁盘为什么要留 2 倍于高水位的余量?
官方实测大数据集存储高水位约 1.6 TB;中间文件、重跑与多样本并存会叠加占用,数据盘建议按高水位的 2 倍规划并另配归档盘。
八、总结与选型建议
Cell Ranger 是典型的“大内存 + 多核 CPU + NVMe”负载:按官方分级表确定内存基线(小样本 64–128 GB,百万细胞 512 GB 级),核心数按推荐值(64 核级)配置,数据盘按官方实测高水位(约 1.6 TB)的 2 倍规划。GPU 不参与计算,无需配置。UltraLAB 图形工作站的高内存配置档可覆盖从单样本到百万细胞级队列的本地化分析;更大规模或多用户高并发可考虑 Slurm 集群模式。以上数字均引自 10x Genomics 官方页面,不同文库类型与测序深度会影响实际需求,请结合官方分级表与自身样本量复核。
边界说明:官方实测性能表基于特定 EC2 实例与 PBMC 数据集(Cell Ranger v10.1),仅用于传达规模-资源关系,不代表任意数据集的承诺时长;ulimit 调整与 OS 版本要求请以官方支持页面当期说明为准。
参考来源
- 10x Genomics Support: Cell Ranger System Requirements — https://www.10xgenomics.com/support/software/cell-ranger/downloads/cr-system-requirements
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



