






摘要:本文解读 Cheng 等发表于 Nature Methods 的 hifiasm 论文(2021)及其开源实现,梳理其针对 PacBio HiFi 高准确长读长"跳过纠错、直接建图"的相位组装图算法与单倍型分辨能力,分析组装负载的内存、线程与 I/O 特征,给出 UltraLAB 图形工作站的入门、主流、高性能分档选型建议。
适用读者:基因组学与生物信息学研究人员、动植物基因组计划团队、医学遗传与群体基因组学课题组。
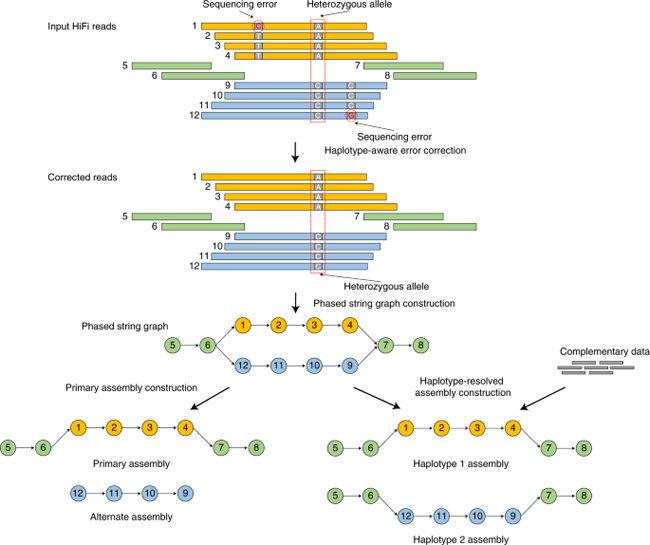
一、资料背景与核心观点
- 资料名称 1:《Haplotype-resolved de novo assembly using phased assembly graphs with hifiasm》(Cheng, Concepcion, Feng, Zhang, Li,Nature Methods 18, 170–175,2021)
- 资料名称 2:hifiasm 开源代码库(chhylp123/hifiasm)
- 发布机构:哈佛大学 Dana-Farber 癌症研究所等(论文作者单位)
- 原文链接:https://www.nature.com/articles/s41592-020-01056-5 ;https://github.com/chhylp123/hifiasm
核心观点:PacBio HiFi 读长本身已达约 99.8% 以上准确度,hifiasm 因此跳过传统长读长组装器耗时的全对全纠错步骤,直接在原始 HiFi 读长上构建相位组装图(phased assembly graph),一次运行同时输出单倍型分辨的 primary/alternate contig。论文证明其在保持高质量的同时显著快于需要先纠错的流程;后续版本(Hi-C 集成、trio 模式、hifiasm-meta 宏基因组)进一步扩展了数据类型整合能力。对硬件的含义是:计算从"纠错密集型"转为"图构建与整理的大内存型"。
二、主要功能模块与核心算法
- 全对全读长比对与重叠检测:基于 minimizer 的高效重叠计算(多线程)。
- 相位组装图构建:在读长重叠图上保留单倍型相位信息,利用杂合位点把两套单倍型分开。
- 图清理与 contig 生成:气泡弹出、tip 修剪,输出 primary 与 alternate 两套 contig。
- 分型模式:trio-binning(亲本 k-mer)、Hi-C 集成(染色质互作信号辅助定相)、双 UL(ultra-long)整合等。
- 衍生版本:hifiasm-meta(宏基因组 HiFi 组装,Nature Methods 2022)。
- 多线程实现:C 语言实现,主要阶段支持多线程;无 GPU 版本(原文未提供 GPU 加速支持)。
三、计算特点与性能瓶颈
- 内存:组装图的顶点/边与读长索引驻留内存,内存是第一约束——基因组越大、杂合度越高、覆盖越深,峰值内存越大。二倍体大基因组(如人类 30× HiFi)属于百 GB 级内存负载;多倍体植物、高杂合海洋物种可到数百 GB 乃至 TB 级。
- 线程扩展:重叠计算与图处理阶段多线程扩展良好,但存在串行段(图遍历整理),Amdahl 效应使 32—64 线程后收益趋缓;高主频同样重要。
- GPU:无官方 GPU 加速路径,纯 CPU 负载。
- I/O:输入为压缩 FASTQ(数十至数百 GB),读写压力中等;中间结果与图文件写出较大,NVMe 有助于缩短 I/O 等待。
- 任务特征:单样本组装为"一个大内存单作业";群体基因组学场景则是"多个中内存作业并发",后者更适合按槽位切分整机资源。
四、典型应用场景
- 真核生物参考基因组从头组装:30—50× HiFi 覆盖,染色体级 contig 输出。
- 单倍型分辨组装:杂合个体的两套单倍型分离,服务等位基因特异性研究。
- 群体基因组学:数十至数百样本的批量组装流水线。
- 宏基因组 HiFi 组装:hifiasm-meta 解析群落中高丰度菌株。
- 基因组计划支撑:与 Hi-C、ONT ultra-long 数据联合实现 T2T 级组装(与 Verkko 等工具链组合)。
五、UltraLAB 硬件配置建议
hifiasm 为纯 CPU 大内存负载;以下分档按"基因组规模 × 并发样本数"推导,内存估算需以实际物种杂合度与覆盖度标定。
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/项目盘/数据盘 | 散热/电源/扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门(小基因组) | 16—24 核高主频 CPU | 128—256 GB ECC | 不需要(可选亮机卡) | 1 TB NVMe 系统盘 + 2 TB NVMe 项目盘 | 塔式静音,≥1000 W | 微生物、小型真核基因组、方法学习 |
| 主流(二倍体大基因组) | 32—64 核,主频与核数均衡 | 512 GB—1 TB ECC,通道满配 | 不需要 | 2 TB NVMe 系统盘 + 4—8 TB NVMe 项目盘 + NAS 归档 | 强化散热,≥1200 W | 人类/哺乳动物规模基因组、trio 与 Hi-C 分型 |
| 高性能(高杂合/群体批量) | 双路 64 核级或 96 核单路 | 1—2 TB ECC | 不需要 | 2 TB NVMe 系统盘 + NVMe RAID 项目盘 + 大容量 NAS | 机架式、冗余电源 | 多倍体植物、高杂合物种、群体级多样本并发 |
推荐理由与升级方向:预算分配优先级为内存容量 > CPU 核数与主频 > NVMe 存储,GPU 不参与。升级路径:先按最大基因组标定内存,再为群体批量场景增加核数与内存槽位;测序下机数据经高速网络进入项目盘,避免中间数据挤占系统盘。
六、软件清单
| 类别 | 名称 | 必需/可选 | 说明 |
|---|---|---|---|
| 组装器 | hifiasm(含 Hi-C/trio 模式)、hifiasm-meta | 必需 | 开源 |
| 比对 | minimap2 | 推荐 | 评估与辅助比对 |
| 支架 | YaHS、3D-DNA(Hi-C 挂载) | 可选 | 染色体级支架 |
| 质控 | Merqury、BUSCO、QUAST | 推荐 | QV 与完整性评估 |
| 去冗余 | purge_dups | 可选 | haplotig 清理 |
| 数据 | PacBio HiFi(必要时 Hi-C/ONT UL) | 必需 | 输入数据 |
| 环境 | conda/bioconda | 必需 | 依赖管理 |
七、常见问题与硬件分析
Q1:组装人类基因组需要多大内存?
公开社区经验中,30× 左右 HiFi 的人类基因组组装峰值内存通常在百 GB 量级;杂合度更高的二倍体动植物、多倍体基因组会显著放大。稳妥做法:按"基因组大小 × 覆盖度 × 杂合度系数"查社区基准,再留 50% 余量;512 GB 是二倍体大基因组的常见起点。
Q2:线程开到多少合适?
主要阶段多线程扩展良好,但图整理存在串行段,32—64 线程后边际收益下降。与其单任务堆 96 线程,不如 2—3 个样本并发(群体场景),总吞吐更高。
Q3:为什么 hifiasm 不需要 GPU?
其核心是字符串/图算法(minimizer 索引、重叠图遍历),属于不规则内存访问,并非 GPU 擅长的规则稠密计算;官方未提供 GPU 路径。硬件投资应全部投向 CPU、内存与存储。
Q4:Hi-C 模式对硬件有额外要求吗?
Hi-C 集成会增加读长比对外加图分区的内存与耗时,建议在主流档位基础上增加内存余量;Hi-C 数据本身还需独立的比对预处理(CPU 多线程)。
Q5:能否用 swap 补足内存?
技术上可行但速度不可接受——图算法是随机内存访问,换页会使运行时间从小时级变成不可控。内存必须一次配足,这是该负载不可妥协的硬件项。
八、总结与选型建议
hifiasm 代表了一类典型生物信息负载:算法越聪明,硬件越"偏科"——跳过纠错省下了算力,却把压力集中到内存容量。选型三原则:一是内存按最大目标基因组的一次到位配置(swap 不可作为替代);二是 CPU 走"高主频 + 32—64 核均衡"路线,群体批量场景用并发而非堆线程;三是无需 GPU,把预算全部给内存与 NVMe。采购前建议用近缘物种的公开 HiFi 数据做 1 次端到端试组装,实测峰值内存后再定最终配置。
参考来源
- Cheng H., Concepcion G.T., Feng X., Zhang H., Li H. Haplotype-resolved de novo assembly using phased assembly graphs with hifiasm. Nature Methods 18, 170–175 (2021). https://www.nature.com/articles/s41592-020-01056-5
- hifiasm 开源代码库(含 Hi-C/trio/meta 模式说明). https://github.com/chhylp123/hifiasm
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



