摘要:ASTRA Toolbox 是断层成像算法开发的标准件:正/反投影 CUDA 加速,FDK 解析重建与 SIRT/CGLS 迭代重建开箱即用,MATLAB/Python 双接口。CT 重建的硬件账很直接——显存决定能重建多大的体积,GPU 算力决定迭代重建要多快,官方甚至内置了显存不足时的自动切分。本文把这笔账算清楚。
关键词:ASTRA Toolbox、CT重建、工业CT、断层成像、FDK、SIRT、CGLS、锥束CT、GPU重建、UltraLAB工作站
- 一、摘要与适用读者
- 二、资料背景与核心观点
- 三、主要功能模块与核心算法
- 四、计算特点与性能瓶颈
- 五、典型应用场景
- 六、UltraLAB 硬件配置建议
- 七、软件清单
- 八、常见问题(FAQ)
- 九、可执行总结
一、摘要与适用读者
1.1 这篇资料解决了什么问题
ASTRA Toolbox 官方文档定义了这套高性能 GPU 断层成像原语库:支持 2D 平行束/扇形束与 3D 平行束/锥束几何,源-探测器位置完全灵活,提供 FBP、FDK、SIRT、SART、CGLS 等算法,正/反投影 CUDA 加速并可从 Python/MATLAB 直接调用以搭建自定义算法;2.x 版本还支持显存不足时自动切分数据与多 GPU。
对工业 CT 与显微 CT 用户,核心决策是显存:重建体积、投影数据与中间量都要驻留显存,4096³ 级体积对显存的需求直接决定机型档位。本文给出按体积规模分档的配置。
1.2 适用读者
- 工业 CT 检测(铸件、复材、增材制造件)与显微 CT 科研团队;
- 做有限角、稀疏角、大视野拼接等非常规扫描重建算法开发的研究者;
- 为 CT 设备配套重建工作站的集成商与实验室。
二、资料背景与核心观点
2.1 资料来源
| 资料 | 类型 | 机构/出处 | 链接 |
|---|---|---|---|
| The ASTRA Toolbox 官方文档(2.5.0) | 官方文档 | CWI / University of Antwerp | https://astra-toolbox.com/ |
| The ASTRA Toolbox: A platform for advanced algorithm development in electron tomography(Ultramicroscopy 2015) | 论文 | CWI、安特卫普大学等 | https://doi.org/10.1016/j.ultramic.2015.05.002 |
| Fast and Flexible X-ray Tomography Using the ASTRA Toolbox(Optics Express 2016) | 论文 | CWI、安特卫普大学等 | https://doi.org/10.1364/OE.24.025129 |
2.2 核心观点
- ASTRA 把断层重建抽象为线性系统 Wx = p,提供 GPU 加速的正投影(FP)与反投影(BP)原语,解析与迭代算法都建立在其上;
- 3D CUDA 算法族包括 FP3D_CUDA、BP3D_CUDA、FDK_CUDA、SIRT3D_CUDA、CGLS3D_CUDA,覆盖从快速解析到高精度迭代的全谱系;
- 2.x 版本官方明确支持:数据超过显存时自动切分、同时使用多 GPU、与 NumPy/PyTorch/CuPy/JAX 的零拷贝数据交换;
- 迭代算法(SIRT/CGLS)每轮都要一次正投影加一次反投影,计算量比 FDK 高一到两个数量级——这是 GPU 算力投入的核心理由。
三、主要功能模块与核心算法
3.1 正投影与反投影原语
正投影沿射线对体积做线积分生成投影数据,反投影把投影数据沿射线铺回体积。ASTRA 用 CUDA 实现这两步并支持探测器/体素超采样,几何参数完全自由——这让螺旋、层析、机器人任意轨迹等非常规扫描也能建模。
3.2 FDK 解析重建
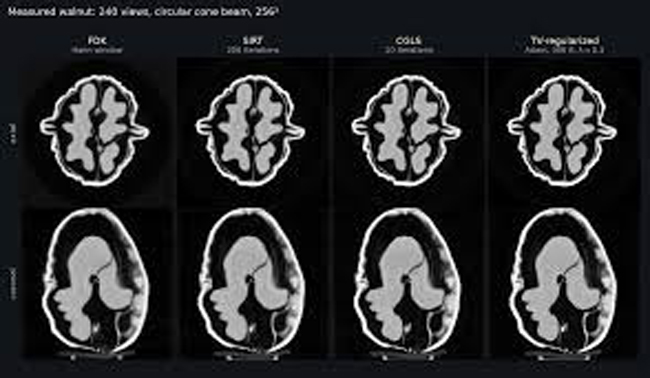
FDK(Feldkamp-Davis-Kress)是圆轨迹锥束 CT 的标准解析算法:投影加权、斜坡滤波(ram-lak 等)、锥角反投影,一次通过即得体积。速度快、显存占用主要是一份投影加一份体积,是产线检测的主力算法。
3.3 SIRT 与 CGLS 迭代重建
SIRT(同步迭代重建)每次迭代用全体投影同时更新体积,可加非负等约束,抗噪与有限角表现好;CGLS(共轭梯度最小二乘)收敛通常更快但无显式约束。迭代算法每轮 = 一次 FP + 一次 BP,几十到上百轮的总耗时直接正比于 GPU 吞吐。
3.4 数据切分与多 GPU
官方文档说明:数据放不下显存时可自动切分重建,也可多 GPU 并行;与 PyTorch 零拷贝对接使“重建 + 深度学习后处理”(伪影去除、超分)管线可在同一显存空间完成。
四、计算特点与性能瓶颈
4.1 计算负载画像
重建负载 = 显存容量题 + GPU 吞吐题。显存估算:单精度体积 N³ × 4 字节,4096³ 即约 256GB——远超单卡,必须切块;2048³ 约 32GB,恰好是大显存单卡的分水岭。算力端:FDK 一遍过,SIRT/CGLS 几十上百遍,迭代算法的时间几乎全花在 FP/BP 上,GPU 浮点与显存带宽双高才有意义。CPU 与系统内存负责投影数据载入与切分调度,I/O 不可太弱。
4.2 硬件瓶颈分析
| 环节 | 主要瓶颈 | 配置含义 |
|---|---|---|
| FDK 解析重建 | GPU 显存(体积+投影) | 2048³ 级建议 24GB 以上显存 |
| SIRT/CGLS 迭代 | GPU 吞吐 × 迭代轮数 | 算力与显存带宽直接决定每轮耗时 |
| 超大体积(≥4096³) | 自动切分调度、系统内存、NVMe | 系统内存 ≥ 体积数倍,NVMe 暂存切片 |
| 多 GPU 并行 | GPU 数与数据划分 | 多卡按探测器行或体积分块提速 |
| 重建+深度学习后处理 | 显存余量 | 零拷贝管线要求显存同时容纳体积与模型 |
五、典型应用场景
- 工业无损检测:铸件气孔、复材分层、增材制造内部缺陷的 FDK 快速重建;
- 科研显微 CT:骨、岩心、材料样品的高分辨率迭代重建;
- 非常规扫描:有限角、稀疏角、大视野拼接的自定义算法开发;
- 重建+AI 管线:迭代重建与深度学习伪影校正、超分辨率一体化。
六、UltraLAB 硬件配置建议
6.1 分档配置与公开参考价
以下配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际以厂商确认为准。
| 档位 | 机型 | CPU / 内存 | GPU | 存储 | 公开参考价 | 适配场景 |
|---|---|---|---|---|---|---|
| 入门教学型 | A350 15064-MBX | Intel Ultra5 265K 20核 / 64GB DDR5 | RTX 5060Ti 16GB | 4TB NVMe + 8TB SATA | ¥36,000 | 1024³ 级体积、算法教学与原型开发 |
| 主流大显存型 | A350 15396-MCT | Intel Ultra-270Kplus 24核 / 96GB DDR5 | RTX 5090D 32GB(水冷) | 4TB NVMe + 8TB SATA | ¥89,990 | 2048³ 级体积 FDK/迭代重建,产线检测 |
| 高频大内存型 | AR350 148192-MCT | AMD 锐龙 9950X3D 16核5.7GHz / 192GB DDR5 | RTX 4090 48GB(水冷) | 4TB NVMe + 8TB SATA | ¥99,990 | 大体积迭代重建 + 深度学习后处理一体化 |
6.2 选型说明与边界
- ASTRA 官方未给出固定硬件清单;上表按“显存 ≈ 体积 + 投影 + 中间量”的工程估算条件化配置,请以目标体积做一次显存预算核算;
- 4096³ 级体积超出单卡显存,依赖官方自动切分,此时系统内存与 NVMe 速度成为关键,建议 256GB 内存起步并与厂商确认定制配置;
- ASTRA CUDA 版本与 GPU 架构需匹配,官方文档提示 CUDA 13 包不再支持 GTX 9/10 系列老卡——新机无此问题,利旧设备需核对;
- 多 GPU 并行的收益取决于几何与划分方式,建议用自有投影数据实测后再定多卡方案。
七、软件清单
| 软件 | 角色 | 许可 | 获取方式 |
|---|---|---|---|
| ASTRA Toolbox | GPU 重建原语与算法 | 开源(GPL v3) | https://astra-toolbox.com |
| TomoPy(可选) | 同步辐射/平行束重建 | 开源(BSD) | https://tomopy.readthedocs.io |
| CIL(可选) | 迭代重建框架(可调用 ASTRA) | 开源 | https://ccpi.ac.uk/cil/ |
| PyTorch / CuPy | 深度学习后处理 | 开源 | https://pytorch.org |
| ImageJ / Fiji、Dragonfly 等 | 三维可视化与分析 | 开源/商业 | https://fiji.sc |
| DXchange / h5py | 投影数据 I/O | 开源 | https://github.com/data-exchange/dxchange |
八、常见问题(FAQ)
11.1 重建到底需要多大显存?
快速估算:单精度体积 N³×4 字节 + 投影数据 + 若干中间缓冲。2048³ 约 32GB 级、1024³ 约 4GB 级。显存不足时官方支持自动切分,代价是 I/O 与调度开销——能单卡放下就尽量单卡放下。
11.2 FDK 和迭代重建怎么选?
产线全角度扫描用 FDK:一遍过、分钟级;有限角、稀疏角、低剂量或金属伪影敏感场景用 SIRT/CGLS:质量更好但耗时高一到两个数量级。工程上常用 FDK 做初值、迭代做精修的混合策略。
11.3 多 GPU 一定更快吗?
官方支持多 GPU,但收益取决于数据划分与几何:投影按行块划分时扩展较好,体积分块涉及 halo 交换。单机 2–4 卡通常有实际收益,建议实测划分策略。
11.4 重建工作站要不要专业卡?
重建以单精度为主,消费级 RTX 显存大、性价比高,是常见选择;专业卡的价值在 ECC 与长时稳定。若重建结果直接用于安全关键判定,再评估专业卡与冗余校验流程。
九、可执行总结
- 先用官方 Python 示例(shepp_logan + FDK/SIRT_CUDA)跑通管线,确认 CUDA 环境;
- 1024³ 级选 A350 15064-MBX;2048³ 级产线重建选 32GB 显存的 A350 15396-MCT;
- 大体积迭代 + AI 后处理选 48GB 显存、192GB 内存的 AR350 148192-MCT;
- ≥4096³ 项目先做显存与切分预算,实测后再定内存与多卡扩展方案。
附:CT 重建环境注意事项
- CUDA 版本与 ASTRA 包版本严格对应,优先 conda 官方渠道安装;
- 投影原始数据量大,采集端到重建端的万兆网络或本机盘是必要的;
- 迭代参数(轮数、约束、松弛)要随样品建立内部规范,避免各自为政。
参考资料
- ASTRA Toolbox 官方文档:https://astra-toolbox.com/
- The ASTRA Toolbox: A platform for advanced algorithm development in electron tomography(Ultramicroscopy):https://doi.org/10.1016/j.ultramic.2015.05.002
- Fast and Flexible X-ray Tomography Using the ASTRA Toolbox(Optics Express):https://doi.org/10.1364/OE.24.025129
- UltraLAB图形工作站基准配置表2026v3(用户提供):#
免责声明:本文所引用的论文、文档与厂商资料均来自公开渠道,链接以撰稿时可访问的版本为准;文中 UltraLAB 机型配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际成交配置、价格、库存与交货周期请以厂商最新确认为准。软件版本、GPU 加速支持范围与许可证条款可能随版本更新发生变化,部署前请核对官方最新文档。