摘要:GraphCast 在 Science 论文中用图神经网络把全球 10 天中期预报压缩到一分钟内完成,并在 1380 个验证目标中 90% 以上优于 ECMWF 的 HRES。它已开源权重与代码,本地推理一张大显存 GPU 即可,而再训练与区域微调则是另一量级的工程。本文讲清其算法结构与三级算力需求。
关键词:GraphCast、AI气象预报、图神经网络、GNN、DeepMind、ECMWF、ERA5、数值天气预报、UltraLAB工作站
- 一、摘要与适用读者
- 二、资料背景与核心观点
- 三、主要功能模块与核心算法
- 四、计算特点与性能瓶颈
- 五、典型应用场景
- 六、UltraLAB 硬件配置建议
- 七、软件清单
- 八、常见问题(FAQ)
- 九、可执行总结
一、摘要与适用读者
1.1 这篇资料解决了什么问题
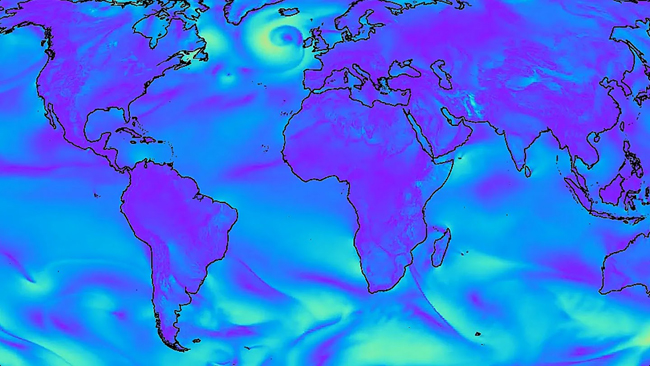
GraphCast 论文提出一种基于图神经网络的自回归全球中期天气预报模型:输入当前与 6 小时前两帧全球大气状态,输出 6 小时后的状态,滚动 40 步得到 10 天预报。论文报告其在 1380 个验证目标上 90% 以上优于 ECMWF HRES,且单次 10 天预报在 Cloud TPU v4 上不足 60 秒。
论文同时诚实地给出代价:模型在 32 块 TPU v4 上训练约四周。对本地团队,合理的定位是推理、评估与有限微调,而非从零复现训练。本文按这三级需求给出配置。
1.2 适用读者
- 气象、海洋、环境方向做 AI 预报方法研究的团队;
- 新能源功率预测、航空气象、农业气象等需要快速集合式预报的产业用户;
- 希望本地部署开源气象大模型做二次开发的技术团队。
二、资料背景与核心观点
2.1 资料来源
| 资料 | 类型 | 机构/出处 | 链接 |
|---|---|---|---|
| Learning skillful medium-range global weather forecasting(Science 2023) | 论文 | Google DeepMind | https://arxiv.org/abs/2212.12794 |
| GraphCast 开源代码与权重(GitHub) | 开源项目 | Google DeepMind | https://github.com/google-deepmind/graphcast |
| DeepMind 官方博客:GraphCast | 厂商技术文章 | Google DeepMind | https://deepmind.google/discover/blog/graphcast-ai-model-for-faster-and-more-accurate-global-weather-forecasting/ |
2.2 核心观点
- 模型在 0.25° 经纬网格(721×1440)上预报 5 个地面变量与 6 个大气变量 × 37 个气压层,空间分辨率约赤道 25 公里;
- 核心是编码器-处理器-解码器结构:把经纬网格映射到多尺度二十面体网格(multi-mesh),用 16 层 GNN 消息传递同时捕捉局地与行星尺度动力学,再映射回经纬网格;
- 训练用 ERA5 再分析 1979–2017 年数据,自回归课程训练最终展开 12 步(3 天),AdamW + bfloat16 + 梯度检查点;
- 推理高效但训练昂贵:论文给出的 10 天 60 秒是 TPU v4 推理数字;训练级别的算力(数十块 TPU 数周)超出单机范畴,本地应聚焦推理与小规模微调。
三、主要功能模块与核心算法
3.1 多尺度网格与消息传递
GraphCast 用逐级细化的二十面体网格(M0 到 M6,最细约 4 万节点)避免经纬网格的两极畸变;处理器在最长边(跨尺度 shortcut)与最细网格边上做消息传递,一次迭代同时完成局地对流与行星波尺度的信息交换——这是它在长预报时效上稳定的关键结构。
3.2 自回归预报
模型单步只预报 6 小时,10 天预报靠把预测喂回输入滚动 40 步。误差会逐步累积,因此训练时也按自回归展开计算损失(backpropagation-through-time),官方实现支持展开步数配置,展开越多显存占用越大。
3.3 变量与归一化
输入包含地表变量、气压层变量与静态场(地形、海陆掩膜、太阳辐射等)共 227 个通道级信息,全部归一化;输出为相对上一状态的残差增量。这套归一化约定是复现与微调时最容易踩坑的细节。
3.4 推理部署形态
开源实现基于 JAX/Haiku:加载官方权重后,单步推理的核心是几次稀疏图消息传递与大张量矩阵乘。0.25° 模型在 24–40GB 级显存可运行推理(具体取决于精度与展开设置),降分辨率版本(1°、0.25° 小模型)门槛更低。
四、计算特点与性能瓶颈
4.1 计算负载画像
推理端:3670 万参数本身不大,但激活值随网格规模可观,0.25° 全分辨率推理需要 24GB 级显存更稳妥;I/O 端要快速读取 ERA5 大体积数据。微调端:自回归展开把显存需求成倍放大,需要 48GB 级显存与梯度检查点;从零训练属集群级任务,单机不现实。
4.2 硬件瓶颈分析
| 环节 | 主要瓶颈 | 配置含义 |
|---|---|---|
| 0.25° 推理 | GPU 显存(24GB 级) | 单卡大显存机型即可稳定运行 |
| ERA5 数据读取 | NVMe 吞吐与容量 | 再分析数据以 TB 计,本地缓存盘要够大 |
| 区域微调/蒸馏 | 显存(48GB 级)+ 算力 | 多卡或大显存单卡 + 梯度检查点 |
| 集合预报批量推理 | GPU 数与任务并发 | 多成员并发跑,吞吐线性 |
| 从零训练 | 集群级算力 | 数十 TPU/GPU 数周,不建议单机规划 |
五、典型应用场景
- 科研评估:与 HRES、盘古、FourCastNet 等做同期对比与个例复盘;
- 产业预报服务:风光功率、航运、农业的快速中期预报与集合生成;
- 方法研究:区域高分辨率降尺度、变量扩展与微调实验;
- 教学演示:AI 预报与传统 NWP 的对比课程案例。
六、UltraLAB 硬件配置建议
6.1 分档配置与公开参考价
以下配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际以厂商确认为准。
| 档位 | 机型 | CPU / 内存 | GPU | 存储 | 公开参考价 | 适配场景 |
|---|---|---|---|---|---|---|
| 推理评估型 | A350 153128-MCT | Intel Ultra9 265K 20核 / 128GB DDR5 | RTX 5090Dv2 24GB | 4TB NVMe + 8TB SATA | ¥76,000 | 0.25° 官方权重推理、对比评估与教学 |
| 微调研究型 | AE430 135256-MC2T | AMD 霄龙 75F3 32核 / 256GB DDR4 | 2×RTX 4090 48GB(水冷) | 4TB NVMe + 20TB SATA | ¥155,000 | 区域微调、集合批量推理、变量扩展实验 |
| 团队算力型 | GA650M 235512-MC2D | 2×AMD 霄龙 75F3 / 512GB DDR5 | 2×RTX Pro 5000 72GB | 4TB NVMe + 20TB SATA | ¥279,000 | 大展开步微调、多团队并发、生产级推理服务 |
6.2 选型说明与边界
- DeepMind 官方发布代码与权重但未给出本地硬件清单;上表按 JAX 推理/微调的显存规律条件化配置,实际显存占用随精度、展开步数与版本变化,请先小规模试跑;
- 官方代码基于 JAX,对 GPU 的支持依赖 CUDA/cuDNN 版本匹配,部署前核对官方 requirements;
- ERA5 数据通过 ECMWF CDS 获取,下载带宽与本地缓存(建议 ≥8TB)是常被低估的瓶颈;
- 推理速度数字来自论文的 TPU v4 环境,GPU 上的实际耗时请以本地实测为准,不做直接等效承诺。
七、软件清单
| 软件 | 角色 | 许可 | 获取方式 |
|---|---|---|---|
| GraphCast(官方仓库) | 模型代码与权重 | 开源(Apache-2.0,权重另有条款) | https://github.com/google-deepmind/graphcast |
| JAX / Haiku | 计算框架 | 开源(Apache-2.0) | https://github.com/google/jax |
| xarray / netCDF4 | 气象数据处理 | 开源 | https://xarray.dev |
| CDS API(ERA5) | 再分析数据获取 | ECMWF 条款 | https://cds.climate.copernicus.eu |
| WeatherBench 2 | 评估基准 | 开源 | https://sites.research.google/weatherbench/ |
| Cartopy / Matplotlib | 气象可视化 | 开源 | https://scitools.org.uk/cartopy/ |
八、常见问题(FAQ)
8.1 本地能复现 GraphCast 训练吗?
从零训练不现实:论文使用 32 块 TPU v4 约四周。本地合理目标是加载官方权重做推理、评估与小规模微调;想训练自己的全球模型,需要集群级预算或改用降分辨率/区域模型做方法验证。
8.2 推理到底要多大显存?
官方未给出硬性数字,社区经验是 0.25° 模型推理在 24GB 级显存可运行,配合 bfloat16 更从容;1° 与 0.25° 小模型版本门槛更低。微调时自回归展开显著放大显存,建议 48GB 级。
8.3 GraphCast 能替代数值预报吗?
论文定位是“互补与改进”:它在多数 RMSE 目标上领先 HRES,但极端降水、精细局地过程与可解释性仍是短板,且训练数据本身来自传统再分析。业务上建议作为集合成员与快速筛查工具,而非唯一预报来源。
8.4 JAX 环境难配吗?
官方仓库给出 requirements 与 Notebook 示例;关键是 JAX-CUDA 版本与显卡驱动匹配。建议先用 CPU 或低分辨率模型跑通,再切换全分辨率 GPU 推理。
九、可执行总结
- 先用官方 Notebook + 低分辨率权重跑通推理链路,验证环境与数据通道;
- 评估与教学选 24GB 显存的 A350 153128-MCT,配 8TB 级 ERA5 缓存盘;
- 微调与集合生产选 2×48GB 的 AE430 135256-MC2T;团队级服务选 72GB 专业卡的 GA650M;
- 用 WeatherBench 2 口径做评估,保证与其他模型的数字可对比。
附:AI 气象部署注意事项
- 模型权重与代码的许可条款分开阅读,商用前完成合规审查;
- ERA5 下载速率受限,提前规划数据本地化;
- AI 预报结果应与业务级 NWP 产品交叉验证后再进入决策链。
参考资料
- GraphCast: Learning skillful medium-range global weather forecasting(arXiv:2212.12794):https://arxiv.org/abs/2212.12794
- GraphCast 开源仓库:https://github.com/google-deepmind/graphcast
- Google DeepMind 官方博客:GraphCast:https://deepmind.google/discover/blog/graphcast-ai-model-for-faster-and-more-accurate-global-weather-forecasting/
- UltraLAB图形工作站基准配置表2026v3(用户提供):#
免责声明:本文所引用的论文、文档与厂商资料均来自公开渠道,链接以撰稿时可访问的版本为准;文中 UltraLAB 机型配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际成交配置、价格、库存与交货周期请以厂商最新确认为准。软件版本、GPU 加速支持范围与许可证条款可能随版本更新发生变化,部署前请核对官方最新文档。