摘要:HYSPLIT 是 NOAA 空气资源实验室开发的拉格朗日输送扩散模型,是应急释放、火山灰、核生化扩散与空气质量研究的业务化工具。本文梳理其轨迹、浓度、沉降与集合模块,分析气象驱动数据 I/O 与粒子统计的负载特征,给出从单事件回放到集合业务的 UltraLAB 工作站分档配置。
适用读者:大气环境、核应急、火山灰与公共卫生方向科研人员;环境咨询与应急管理部门的技术团队。
资料背景与核心观点
资料名称:《Improving the atmospheric dispersion forecasts over Washington, D.C. using UrbanNet observations: A study with HYSPLIT model》(ScienceDirect,2026);NOAA ARL HYSPLIT 官方页面(arl.noaa.gov/hysplit)。
发布机构:NOAA Air Resources Laboratory(模型开发与维护方)。
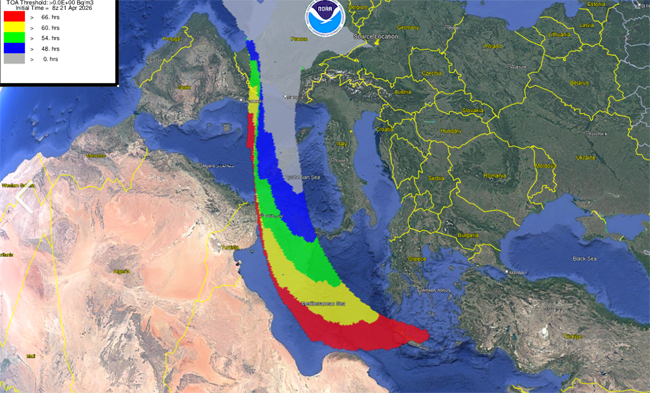
核心观点:论文确认 HYSPLIT 是 NOAA ARL 为满足大气研究界对污染物输送扩散业务化预测工具的迫切需求而开发的拉格朗日粒子/烟团模型,被 NOAA、联邦机构、市政与大学用于应急响应与评估(Stein et al., 2015)。应用模式分正向(已知源,实时预测扩散)与反向(已知受体,溯源定位);研究同时指出应急场景要求模拟"快速且准确",气象输入选择(高分辨率中尺度输出 vs 全球再分析)与边界层垂直分辨率显著影响近地面浓度预测——这决定了工作流的两大成本来源:气象数据获取/存储与集合成员的批量计算。
主要功能模块与核心算法
- 轨迹模块:气块三维轨迹正/反向计算,用于传输路径与源区分析。
- 浓度模块:粒子(puff/粒子混合)扩散、干湿沉降、放射性衰变与化学转化(简化);拉格朗日平流 + 欧拉网格浓度统计的混合方法。
- 沉降与剂量:干沉降速度、湿清除参数化,支持剂量估算。
- 集合预报:气象场扰动、释放参数扰动与多物理方案组合,输出概率性浓度。
- 气象接口:GFS、NAM、WRF-ARW 输出及再分析(GDAS/ERA 类)转换驱动。
- 生态接口:PySPLIT(Python)、R 包,便于批量轨迹与自动化管线(社区实践)。
计算特点与性能瓶颈
- 轻量计算、重 I/O:单次轨迹/扩散计算本身算力需求低;主要成本在气象场读取(数十—数百 GB 再分析/预报数据)与网格化浓度统计。
- 批量与集合是常态:集合成员、多释放高度、多起始时间的组合可达数百次独立运行——任务级并行,吃核心数与调度。
- 粒子数与内存:高分辨率浓度网格 + 大粒子数(10⁵—10⁶)时内存升至数 GB—数十 GB;仍属中等负载。
- GPU 无关:主线无 GPU 加速需求。
- 数据管理是关键:长期研究累积的 WRF/GDAS 驱动数据可达数十 TB,存储分层(热 NVMe + 冷大容量)是主要硬件投资。
典型应用场景
- 核/化学应急回放与演练:事故释放正向扩散 + 反向溯源,分钟—小时级单次运行,工作站即可承担业务值班。
- 火山灰航空安全:多高度释放集合扩散,结合卫星反演源项,批量运行。
- 城市空气质量研究:华盛顿 UrbanNet 类研究——观测约束下改进扩散预报,长期集合回算。
- 传输路径气候学:多年逐日后向轨迹(数千次运行)做聚类分析,典型任务级并行。
UltraLAB 硬件配置建议
HYSPLIT 的硬件公式 = 轻计算 × 大批量 + 大气象数据存储:
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/数据盘 | 适用规模 |
|---|---|---|---|---|---|
| 入门档 | 8—16 核 | 32—64 GB | 不需要 | 500 GB NVMe + 4 TB 数据盘 | 单事件轨迹与扩散、教学 |
| 主流档 | 16—32 核 | 64—128 GB | 不需要 | 1 TB NVMe + 8—16 TB 数据盘(气象库) | 集合预报、批量溯源、区域研究 |
| 高性能档 | 32—64 核 | 128—256 GB | 不需要 | 2 TB NVMe + 32 TB+ 分层存储(NVMe 热 + HDD 冷)+ 万兆网口 | 多年气候学轨迹库、业务化集合平台 |
要点:预算向存储倾斜——气象驱动数据是最大资产;计算端 32 核足以并行数十个集合成员。若与 WRF 耦合自制高分辨率气象场,WRF 部分才是真正的计算大户(需另按中尺度模式配置,参考本系列 WRF 专文)。网络带宽影响气象数据下载效率,业务化场景建议万兆内网 + 高速外网。
软件清单
| 类别 | 软件/工具 | 必需性 | 说明 |
|---|---|---|---|
| 扩散模型 | HYSPLIT(NOAA ARL) | 必需 | 轨迹/浓度/沉降/集合 |
| 气象驱动 | GFS/GDAS、NAM、WRF 输出 + 转换工具 | 必需 | 气象场准备 |
| 批量脚本 | PySPLIT / R 接口 / Shell 队列 | 建议 | 集合与批量运行 |
| 可视化 | HYSPLIT 自带绘图、Python(Cartopy) | 建议 | 轨迹与浓度图 |
| 数据管理 | netCDF/HDF 工具链 | 可选 | 气象库整理 |
常见问题
Q1:HYSPLIT 和欧拉模式(如 CMAQ)怎么分工?
HYSPLIT 是拉格朗日粒子/烟团模型,擅长点源应急、溯源与长距离输送;CMAQ 类欧拉模式擅长区域多源光化学。两者互补,应急场景首选 HYSPLIT 的快速部署。
Q2:单次模拟要多久?
普通轨迹数秒—数分钟;高粒子数浓度模拟数十分钟—数小时。应急时效靠预置气象场与脚本化流程保障,而非堆硬件。
Q3:集合预报要多少计算资源?
成员数 × 单成员成本。27 成员的典型气象扰动集合在 32 核工作站上可小时级完成;瓶颈常在气象场 I/O,建议热数据放 NVMe。
Q4:气象数据需要多大存储?
全球再分析逐年累积可达数十 TB;按研究范围裁剪(子区域 + 必要层次)可降一个数量级。规划 8—32 TB 分层存储是务实起点。
Q5:能与 WRF 直接耦合吗?
支持 WRF-ARW 输出转换驱动,高分辨率中尺度场可显著改善复杂地形近地面浓度;但 WRF 运行本身需要独立的中尺度模式计算资源。
总结与选型建议
HYSPLIT 工作站的本质是"气象数据中心 + 批量轻计算":16—32 核 + 128 GB 内存 + 8—16 TB 分层存储即可支撑从应急回放到集合预报的大多数任务;多年轨迹气候学与业务平台再扩核数与存储。计算预算无需 GPU,存储与网络才是这类环境模拟工作站的主角。
参考来源
- Improving the atmospheric dispersion forecasts over Washington, D.C. using UrbanNet observations: A study with HYSPLIT model. Urban Climate, 2026. https://www.sciencedirect.com/science/article/abs/pii/S2212095524001445
- NOAA ARL. HYSPLIT 官方页面. https://www.arl.noaa.gov/hysplit/
- HYSPLIT 模型综述与业务应用(SimTool 专栏). https://www.simtool.com/article/hysplit-lagrangian-particle-dispersion-modeling-for-atmospheric-transport-analysis/
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800