摘要:物理信息神经网络(PINN)把偏微分方程(PDE)残差直接写入损失函数,用神经网络替代传统网格求解器,正反问题统一求解。本文基于 DeepXDE 的 SIAM Review 论文与官方文档,提炼 PINN、分数阶 PINN(fPINN)、深度算子网络(DeepONet)的算法构成,分析自动微分求高阶导带来的计算图膨胀、GPU 显存占用与采样点规模之间的关系,并给出从算法验证到大规模反问题求解的 UltraLAB 工作站分档配置。
适用读者:从事科学机器学习、计算力学反问题、参数反演与数据同化研究的科研人员;希望在本地部署 PINN/算子学习训练环境的工程师。
资料背景与核心观点
资料名称:DeepXDE: A deep learning library for solving differential equations(Lu Lu, Xuhui Meng, Zhiping Mao, George Em Karniadakis,SIAM Review 63(1), 2021);DeepXDE 官方文档。
发布机构:布朗大学应用数学系(Karniadakis 团队);论文见 arXiv:1907.04502,文档见 deepxde.readthedocs.io。
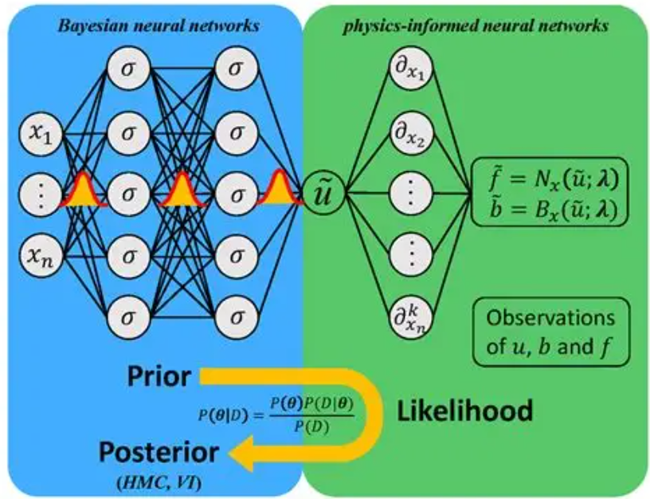
核心观点:PINN 借助自动微分把 PDE、初边值条件嵌入损失函数,无需网格剖分即可求解正问题与反问题,且反问题与正问题的实现难度几乎相同。DeepXDE 在此基础上提出残差自适应加密(RAR)采样方法提升训练效率,并将框架扩展到积分微分方程、分数阶 PDE 与随机 PDE。官方文档显示 DeepXDE 支持 TensorFlow 1.x/2.x、PyTorch、JAX、PaddlePaddle 五种后端,同一套建模代码可切换不同张量计算引擎,这对硬件选型意味着:后端决定 GPU 加速路径,而非库本身。
主要功能模块与核心算法
依据论文与文档,DeepXDE 的功能模块可归纳为:
- PINN 求解器族:正/反 ODE、PDE、积分微分方程(IDE)、分数阶 PDE(fPINN)、随机 PDE(NN-aPC)、带硬约束的 hPINN(用于反设计与拓扑优化);
- 精度改进技术:残差自适应采样(RAR)、梯度增强 PINN(gPINN,额外对 PDE 残差梯度施加约束)、多尺度 Fourier 特征网络;
- 算子学习:DeepONet(学习函数到函数的映射)、POD-DeepONet、MIONet、物理信息 DeepONet、多保真度 DeepONet 与 DeepM&Mnet(多物理多尺度耦合);
- 几何与采样:基于构造实体几何(CSG)的复杂区域描述,随机/网格/自适应配点采样;
- 多后端执行层:TensorFlow、PyTorch、JAX、PaddlePaddle,自动微分与优化器(Adam + L-BFGS 两阶段)由后端提供。
核心算法链路:配点采样 → 前向传播得到场量 → 自动微分计算 PDE 残差(含二阶及以上导数)→ 多损失加权求和 → 梯度下降迭代。反问题把未知参数设为可训练变量,与网络权重同步优化。
计算特点与性能瓶颈
- 计算密集型,且求导放大计算图:PDE 残差需要对网络输出求一阶、二阶甚至更高阶导数,自动微分使反向传播的计算图深度倍增,单位迭代的算力消耗明显高于同规模普通回归网络;通常一个中等 PINN 也需要数万到数十万次迭代。
- GPU 加速条件明确但规模阈值低:全连接网络 + 大批配点属于规则稠密计算,非常适合 GPU;但单层规模小、批维度有限时,单张中端 GPU 即可饱和,多卡收益有限。PINN 训练一般是单 GPU 任务,多卡主要用于批量独立试验(超参搜索、反问题多初值)。
- 显存占用与配点数和求导阶数正相关:fPINN 的分数阶导数需数值积分展开,显存和算力开销显著高于普通 PINN;gPINN 额外保存残差梯度图,显存近似翻倍。实际单任务显存多在 4—16 GB 区间。
- CPU 与内存的角色:数据生成(传统求解器造标签)、采样、结果可视化与 L-BFGS 阶段(全批、单点更新频繁)更依赖 CPU 单核性能与内存容量;JAX 后端在 CPU 上也有不错的 JIT 性能。
- I/O 与多任务:单任务 I/O 轻,但科研常态是几十上百组对比实验,任务级并行要求高主频多核 CPU 来同时调度多个单卡/单进程训练。
典型应用场景
- 计算力学反问题:由稀疏观测反演材料参数、边界通量或损伤位置,PINN 把可测数据与 PDE 约束一并写入损失,正逆统一;模型规模通常为 4—8 层全连接网络、10⁴—10⁶ 配点。
- 流动与传热代理建模:用 DeepONet 学习"边界条件/几何参数 → 流场"的算子映射,训练后可毫秒级预测,服务于设计空间探索;数据集来自 CFD 批量计算,训练为中等规模单卡任务。
- 分数阶反常扩散与粘弹性建模:fPINN 处理分数阶导数,计算代价高于常规 PINN,建议作为显存与算力上限的设计工况。
- 教学与算法验证:二维泊松/伯格斯方程课堂算例,CPU 即可运行,适合入门档。
UltraLAB 硬件配置建议
PINN/DeepONet 的负载以"单 GPU 训练 + 多任务并行试验"为主,选型核心是一张显存充裕的计算卡 + 高主频多核 CPU,而不是堆叠多卡。下表按任务规模分档:
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/数据盘 | 适用规模 |
|---|---|---|---|---|---|
| 入门档 | 8—16 核高主频 CPU(如酷睿 i9/锐龙 9 级别),保证 L-BFGS 与采样效率 | 32—64 GB | 1 张 12—16 GB 显存 GPU(RTX 4060 Ti/4070 Ti SUPER 级别) | 500 GB NVMe 系统盘 + 1 TB 数据盘 | 二维正问题、教学算例、算法复现 |
| 主流档 | 16—32 核工作站 CPU(至强 W 或锐龙 Threadripper 级别),同时跑 2—4 个独立训练 | 64—128 GB | 1—2 张 24 GB 显存 GPU(RTX 4090/5090 级别),分别绑定独立任务 | 1 TB NVMe 系统盘 + 2—4 TB NVMe 数据盘 | 三维正反问题、gPINN/RAR 大规模采样、DeepONet 中等数据集 |
| 高性能档 | 32—64 核单/双路平台,支撑超参搜索与批量反演任务队列 | 128—256 GB | 2 张 24—48 GB 显存 GPU(如 RTX 5090 或 RTX 专业卡级别) | 2 TB NVMe 系统盘 + 4—8 TB NVMe 数据盘(数据集与检查点) | fPINN、多物理 DeepM&Mnet、大规模算子学习与不确定性量化 |
升级方向:显存不足是 PINN 规模化的第一约束(配点数 × 求导阶数),优先升级显存而非卡数;确需多任务吞吐时按"一卡一任务"线性扩展。JAX 后端对显存管理更激进,切换后端前建议核对官方文档的显存占用差异。若后续迁移到神经算子大模型(FNO 类)或集群训练,再考虑多卡 NVLink 与 InfiniBand 组网。
软件清单
| 类别 | 软件/工具 | 必需性 | 说明 |
|---|---|---|---|
| 求解框架 | DeepXDE(PINN/DeepONet 库) | 必需 | 核心建模与训练库 |
| 计算后端 | PyTorch / TensorFlow / JAX / PaddlePaddle(四选一) | 必需 | 决定 GPU 加速路径与显存行为 |
| 运行环境 | Python 3.10+、CUDA/cuDNN(GPU 后端) | 必需 | GPU 训练依赖 |
| 参考求解器 | FEniCSx / deal.II / OpenFOAM(生成标签数据) | 可选 | 算子学习数据集制备 |
| 可视化 | Matplotlib、ParaView | 可选 | 场量后处理与论文绘图 |
常见问题
Q1:PINN 训练需要多大显存?
取决于配点批量、网络宽度与求导阶数。二维正问题 2—4 GB 即可;三维反问题或 gPINN/fPINN 建议 16 GB 起步,24 GB 从容。出现 OOM 时先减配点批量或分域训练,不必急于换卡。
Q2:多 GPU 能加速单个 PINN 吗?
收益有限。PINN 网络小、通信占比高,单卡数据并行拆分批次的扩展性远不如大模型训练。多卡的正确用法是并行跑独立实验(不同初值、超参、反演工况)。
Q3:选 PyTorch 还是 JAX 后端?
PyTorch 生态与调试工具更全;JAX 的 JIT/自动向量化在小模型上常更快且便于函数式组合,但显存分配策略不同。建议以团队熟悉度为先,两者在 DeepXDE 中建模代码一致。
Q4:CPU 核心数重要还是主频重要?
单任务训练瓶颈在 GPU,CPU 主频影响采样、数据装载与 L-BFGS 阶段;多任务并行时核心数开始起作用。主流档 16—32 核兼顾两者,是性价比较高的区间。
Q5:PINN 能替代传统有限元吗?
目前更适合中小规模、反问题与无网格优势场景;大规模正问题的精度和效率仍以成熟数值方法为主。DeepXDE 论文本身也与标准有限元方法做了对比,建议将 PINN 作为补充而非替代。
总结与选型建议
PINN/DeepXDE 的硬件画像清晰:单卡显存决定单任务上限,CPU 高主频多核决定试验吞吐。入门者一张 12—16 GB 显卡即可开展研究;做三维反问题与算子学习的团队建议 24 GB 级单卡起步、64 GB 以上内存;需要批量反演与不确定度量化的实验室按"多卡多任务"扩展,并把预算优先给显存与内存,而非盲目堆卡数。DeepXDE 多后端特性使同一环境可服务 TensorFlow/PyTorch/JAX 三类技术栈,部署时注意 CUDA 版本与后端版本的匹配。
参考来源
- Lu L., Meng X., Mao Z., Karniadakis G. E. DeepXDE: A deep learning library for solving differential equations. SIAM Review, 63(1):208–228, 2021. https://arxiv.org/abs/1907.04502
- DeepXDE 官方文档. https://deepxde.readthedocs.io/en/latest/
- DeepXDE GitHub 仓库(算法列表与后端说明). https://github.com/lululxvi/deepxde
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800