






一句话结论:RTX 5060 Ti 16GB 是 2026 年本地部署大模型的"入门甜点卡"——16GB GDDR7 显存可流畅运行 9B
14B 级量化模型(Qwen3.5-9B、DeepSeek-R1-Distill-14B、Qwen3-14B 等),并通过 CPU+内存混合卸载摸到 27B32B 级模型的门槛,是个人开发者、小微企业和科研团队搭建私有化 AI 的性价比之选。
关键词:RTX 5060 Ti 16GB | 本地大模型 | Ollama | LM Studio | RAG知识库 | UltraLAB图形工作站

本文目录
- RTX 5060 Ti 16GB 核心规格速览
- 16GB显存能跑哪些大模型(实测对照表)
- 五大典型应用场景:从RAG知识库到AIGC绘图
- UltraLAB硬件配置推荐(三档方案)
- 常见问题与硬件配置分析(FAQ)
一、RTX 5060 Ti 16GB 核心规格:为什么它是本地AI的"入门甜点卡"
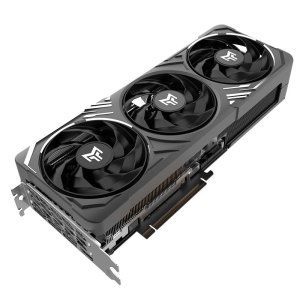
RTX 5060 Ti 基于 NVIDIA Blackwell 架构(GB206核心),相比上一代 RTX 4060 Ti,最大的升级是 GDDR7 显存——带宽从 288 GB/s 提升至 448 GB/s(+55%),而推理速度恰恰主要受显存带宽制约。
| 规格项 | RTX 5060 Ti 16GB | RTX 4060 Ti 16GB | RTX 3060 12GB |
|---|---|---|---|
| 架构 | Blackwell (GB206) | Ada Lovelace | Ampere |
| 显存容量 | 16GB GDDR7 | 16GB GDDR6 | 12GB GDDR6 |
| 显存带宽 | 448 GB/s | 288 GB/s | 360 GB/s |
| TDP 功耗 | 180W | 165W | 170W |
| 8B模型推理速度(Q4) | 约 51~75 tokens/s | 约 34 tokens/s | 约 28 tokens/s |
| 可流畅运行的最大模型 | 14B(Q4量化) | 14B(Q4量化) | 8B(Q4量化) |
为什么推荐 16GB 而不是 8GB 版本? 8GB 显存加载 8B 量化模型后所剩无几,上下文稍长即"爆显存";16GB 版本不仅能从容运行 14B 级模型,还能留出余量运行 RAG 向量检索、长上下文对话和多实例并发,天花板高出一倍。
二、16GB显存到底能跑哪些大模型?
2.1 语言大模型(LLM)兼容对照表
以下模型均可在 RTX 5060 Ti 16GB 上通过 Ollama / LM Studio / llama.cpp 一键部署,量化格式推荐 Q4_K_M / Q8(质量与体积的最佳平衡点):
| 模型 | 参数规模 | 量化格式 | 显存占用 | 推理速度(约) | 适用度 |
|---|---|---|---|---|---|
| Qwen3.5-9B Instruct | 9B | Q8 | ~10.7GB | 29 t/s | ⭐⭐⭐⭐⭐ 中文最强9B |
| Qwen3-14B | 14B | Q4_K_M | ~9-10GB | 32 t/s | ⭐⭐⭐⭐⭐ 中文写作/推理 |
| DeepSeek-R1-Distill-14B | 14B | Q4_K_M | ~9GB | 30+ t/s | ⭐⭐⭐⭐ 数学/逻辑推理 |
| Qwen3-Coder-14B | 14B | Q4_K_M | ~9GB | 30+ t/s | ⭐⭐⭐⭐ 代码补全 |
| Gemma3-12B | 12B | Q4_K_M | ~8GB | 35+ t/s | ⭐⭐⭐⭐ 英文/多模态 |
| Phi-4 / Phi-4-mini | 14B/3.8B | Q4_K_M | 9GB/3GB | 30/80+ t/s | ⭐⭐⭐ 轻量推理 |
| Llama-3.1-8B | 8B | Q4_K_M | ~6GB | 50+ t/s | ⭐⭐⭐⭐ 英文场景 |
| Mistral-Small-24B | 24B | Q4_K_M | ~15GB | 15-20 t/s | ⭐⭐⭐ 需精调参数 |
| GPT-OSS-20B (MoE) | 20B(3.6B激活) | Q4 | ~12GB | 49 t/s | ⭐⭐⭐⭐ MoE架构速度快 |
2.2 进阶玩法:CPU+内存混合卸载跑 27B~35B 模型
借助 llama.cpp / LM Studio 的 GPU Layers 分层卸载技术,将大部分层放入 16GB 显存、剩余层放入系统内存(建议 64GB+),可运行更大模型:
| 模型 | 量化后体积 | 卸载策略 | 生成速度 | 体验评价 |
|---|---|---|---|---|
| Qwen3.6-27B | ~15GB | 41/43层入GPU | 15-25 t/s | 流畅可用 |
| Qwen3.5-35B-A3B (MoE) | ~22GB | 部分层卸载CPU | 42 t/s | MoE架构惊喜 |
| Gemma4-26B | ~17GB | 少量层卸载CPU | 56 t/s | 英文/代码出色 |
2.3 多模态与垂直模型
| 类型 | 代表模型 | 显存需求 | 说明 |
|---|---|---|---|
| 视觉语言模型 | Qwen3-VL-8B、Gemma3-12B多模态 | 8-12GB | 图片理解、文档OCR、图表解析 |
| 语音合成TTS | Qwen3-TTS、CosyVoice | 12-16GB | 音色克隆、有声内容生产 |
| 图像生成 | SDXL、SD 3.5 | 8-12GB | 全精度流畅运行 |
| 图像生成(进阶) | FLUX.1-dev | FP8/NF4量化 | 需开启模型顺序卸载 |
| 视频生成 | LTX Video | 12-16GB | 短视频片段生成 |
| Embedding/Rerank | BGE-M3、Qwen3-Reranker-8B | 4-15GB | RAG知识库检索增强 |

三、RTX 5060 Ti 16GB 能做哪些实际应用?
3.1 企业私有RAG知识库 ⭐ 最热门场景
- 做什么:合同/技术手册/论文的本地问答系统,数据不出内网
- 技术栈:Qwen3.5-9B + BGE-M3 Embedding + RAGFlow/Dify/AnythingLLM
- 规模:支持百万字级文档库,5-10人小团队并发使用
- 典型客户:律所、设计院、制造企业、医院科室
3.2 代码大模型助手
- 做什么:本地代码补全、代码审查、单元测试生成,源代码不出公司
- 技术栈:Qwen3-Coder-14B / DeepSeek-Coder + Continue.dev 插件 + VSCode
- 效果:日常 CRUD、脚本编写、SQL 生成完全胜任,替代部分云端 Copilot 订阅
3.3 智能写作与办公自动化
- 做什么:公文写作、翻译润色、会议纪要、招投标文件初稿
- 技术栈:Qwen3-14B(中文写作最优)+ OpenWebUI 图形界面
- 优势:涉密单位离线可用,无内容上传合规风险
3.4 AIGC图像生成与LoRA微调
- 文生图:SDXL 全精度秒级出图(约6 it/s),FLUX.1-dev FP8量化可运行
- LoRA训练:16GB显存配合梯度检查点 + 8-bit Adam,可训练人物/画风LoRA,接商单回本
- 工具链:ComfyUI / Stable Diffusion WebUI,CUDA生态完整
3.5 语音合成与数字人前端
- 做什么:Qwen3-TTS 音色克隆、有声书制作、短视频配音
- 注意:TTS + LLM 双模型同时驻留时,16GB显存需错峰调度
边界提醒:70B 级模型(Q4需35-40GB显存)、全参数微调、高并发生产环境(vLLM百级并发)超出单卡16GB能力范围,需升级 RTX PRO 6000 96GB 或多卡集群——UltraLAB可提供对应方案。
四、UltraLAB硬件配置推荐:让16GB显存发挥120%的实力
本地大模型的性能瓶颈是"显存决定能不能跑,带宽决定跑多快,内存决定能卸载多少"。UltraLAB 针对 RTX 5060 Ti 16GB 推出三档定制工作站,全部预装 Ollama/LM Studio + 常用模型,开箱即用:
方案A:入门AI体验型(预算约1.2~1.5万)
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | Intel Core Ultra 7 265K / AMD R7 9700X | 8核高频,推理预处理与向量检索足够 |
| 内存 | 64GB DDR5 6000MHz | 满足27B模型混合卸载的最低要求 |
| GPU | RTX 5060 Ti 16GB | 本文主角,GDDR7高带宽 |
| 存储 | 2TB NVMe PCIe 4.0 SSD | 模型仓库(单模型5-15GB)+知识库 |
| 电源 | 750W 金牌 | 180W显卡+平台余量充足 |
| 系统 | Windows 11 + WSL2 / Ubuntu 22.04 | 双系统按需切换 |
方案B:进阶RAG开发型(预算约2~2.5万)⭐ 推荐
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD R9 9950X (16核32线程) | 多核并行处理文档解析、Embedding批量计算 |
| 内存 | 128GB DDR5 6000MHz | 35B级MoE模型卸载+多模型同驻 |
| GPU | RTX 5060 Ti 16GB | 主力推理卡 |
| 存储 | 4TB NVMe + 8TB HDD | 模型库+企业文档仓库分离 |
| 散热 | 240一体式水冷 | 7×24小时推理服务稳定运行 |
| 电源 | 850W 金牌全模组 | 预留升级第二块显卡空间 |
| 预装 | Ollama + RAGFlow + OpenWebUI + 客户指定模型 | 开机即用 |
方案C:小型团队服务器型(预算约4~6万)
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005系列 / Xeon w7 | 多路内存通道,支撑多卡扩展 |
| 内存 | 256GB DDR5 ECC | 纠错内存保障7×24稳定 |
| GPU | RTX 5060 Ti 16GB ×2 或升级 RTX 5090 32GB | 双卡并联32GB显存池,或一步到位 |
| 存储 | 2×4TB NVMe RAID1 + NAS对接 | 数据冗余 |
| 电源 | 1600W 铂金 | 多卡供电保障 |
| 部署 | vLLM 生产级推理框架 + 负载均衡 | 支持20-50人并发 |

五、常见问题与硬件配置分析(FAQ)
Q1:RTX 5060 Ti 8GB 和 16GB 差价不大,为什么必须选16GB?
A:8GB 跑 8B 量化模型已在临界值,上下文开到 4K 以上就会溢出到硬盘交换,速度腰斩(40-60%损失);14B 模型直接无法加载。16GB 是 2026 年本地 LLM 的"实用分界线",多花几百元换来两倍的模型天花板。
Q2:跑大模型,CPU 重要吗?需要买顶级 CPU 吗?
A:纯 GPU 推理时 CPU 占用很低,8核主流型号即可。但两种场景例外:① 混合卸载跑 27B+ 模型时,CPU 参与计算,建议 16 核;② RAG 知识库的文档解析、Embedding 批量编码是 CPU 密集型任务。UltraLAB 方案B的 9950X 正是为此配置。
Q3:系统内存 32GB 够吗?
A:只跑 14B 以下纯 GPU 模型,32GB 够用。但只要想尝试 27B/35B 模型的 CPU 卸载玩法,64GB 是底线,128GB 才从容——这是比显卡更容易被忽视的瓶颈。
Q4:Windows 还是 Linux 跑大模型更好?
A:Linux(Ubuntu)性能比 Windows 高约 10%-15%,且 vLLM 等生产框架仅支持 Linux。个人体验用 Windows + Ollama/LM Studio 最省事;团队部署服务建议 Ubuntu。UltraLAB 支持双系统预装。
Q5:5060 Ti 16GB 和 5070 12GB 怎么选?
A:跑大模型选 5060 Ti 16GB——12GB 显存装不下 14B 模型的舒适配置,5070 的算力优势发挥不出来。5070 更适合只玩 7B-9B 模型且追求速度的用户。显存容量 > 算力是本地 LLM 的铁律。
Q6:能上 70B 大模型吗?
A:单卡 16GB 无法实用化运行 70B(Q4需35-40GB显存),即便 CPU 全卸载也仅 6-9 t/s,体验不佳。70B 级需求建议 UltraLAB 的 RTX PRO 6000 96GB 单卡方案或多卡集群。
Q7:可以做模型微调吗?
A:可以。LoRA/QLoRA 微调 8B 以下模型(如用 Unsloth 框架)在 16GB 显存内可行;图像模型(SDXL LoRA)训练也完全支持。全参数微调则需 48GB+ 显存方案。
Q8:功耗和散热压力如何?可以 7×24 开机吗?
A:RTX 5060 Ti TDP 仅 180W,整机满载约 350W,UltraLAB 标配水冷 + 风道优化机箱,支持 7×24 小时不间断推理服务,年电费约 2000 元内(按0.7元/度)。
结语:16GB显存,私有化AI的最佳入场券
RTX 5060 Ti 16GB 以千元级显卡的价格,覆盖了 90% 个人与小微团队的本地 AI 需求:9B-14B 模型流畅推理、RAG 知识库、代码助手、AIGC 绘图、语音合成。配合 UltraLAB 定制工作站的"大内存+高速存储+稳定散热"体系化设计,让这张甜点卡发挥出超越同级的实用价值。
关于 UltraLAB :
西安坤隆计算机科技有限公司,专注定制图形工作站与 AI 计算方案,服务科学仿真、EDA、AIGC 与大模型本地化部署场景,提供从单卡工作站到 GPU 集群的全栈硬件与预装交付。


