






title: "24GB显卡怎么选?RTX 4090 vs RTX 5090D v2 vs RTX Pro 4000 大模型部署全对比与UltraLAB配置推荐"
description: "同为24GB显存,RTX 4090、RTX 5090D v2、RTX Pro 4000 Blackwell三张卡跑大模型有何差异?本文从显存带宽、推理速度、可运行模型规模、ECC纠错、功耗形态等维度全面对比,覆盖RAG知识库、代码助手、AIGC等应用场景,附UltraLAB工作站三档配置推荐与常见问题解答。"
keywords: "RTX 4090, RTX 5090D v2, RTX Pro 4000 Blackwell, 24GB显卡, 本地大模型部署, 32B模型, Qwen3, DeepSeek, AI工作站配置, UltraLAB, XASUN"
author: "UltraLAB / XASUN 西安坤隆计算机科技有限公司"
date: "2026-07-21"
lang: "zh-CN"
24GB显卡怎么选?RTX 4090 / RTX 5090D v2 / RTX Pro 4000 大模型部署全对比
一句话结论:三张卡都是 24GB 显存,能跑的模型规模完全相同(32B Q4 量化是天花板)——真正的差异在于跑多快、跑多稳、占多少空间。追求极致速度选 5090D v2(1344 GB/s 带宽),追求性价比选 4090,追求 7×24 稳定、ECC 纠错和高密度部署选 RTX Pro 4000。
关键词:RTX 4090 | RTX 5090D v2 | RTX Pro 4000 | 24GB显存 | 本地大模型 | UltraLAB图形工作站

本文目录
- 三张24GB显卡规格对比:同样的显存,不同的性格
- 24GB显存能跑哪些大模型(通用能力 + 三卡速度差异)
- 五大应用场景落地分析
- 三卡优缺点深度对比与选型决策
- UltraLAB硬件配置推荐(对应三卡的三档方案)
- 常见问题与硬件配置分析(FAQ)
一、三张24GB显卡规格对比:同样的显存,不同的性格
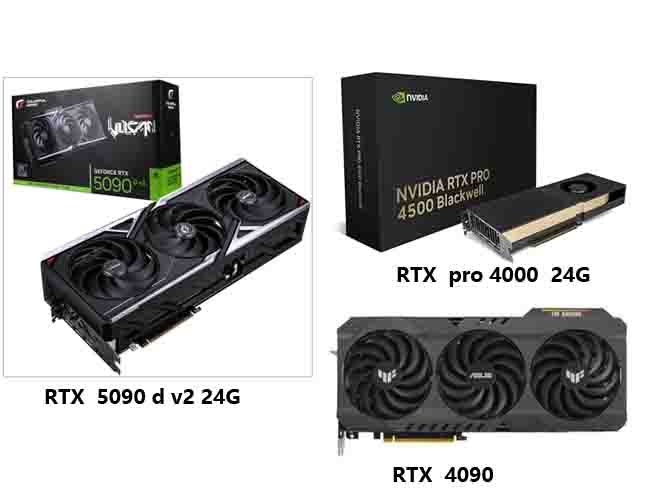
本地大模型推理的铁律是"显存容量决定能不能跑,显存带宽决定跑多快"。三张卡容量相同,带宽和定位却差异巨大:
| 规格项 | RTX 4090 | RTX 5090D v2 | RTX Pro 4000 Blackwell |
|---|---|---|---|
| 架构 | Ada Lovelace | Blackwell (GB202) | Blackwell (GB203) |
| 显存 | 24GB GDDR6X | 24GB GDDR7 | 24GB GDDR7 ECC |
| 显存位宽 / 带宽 | 384-bit / 1008 GB/s | 384-bit / 1344 GB/s | 192-bit / 672 GB/s |
| CUDA 核心 | 16384 | 21760 | 8960 |
| AI算力 (FP4/FP8 TOPS) | 约1321 (FP8) | 2375 | 1290 |
| 新精度格式 | 不支持FP4 | 支持FP4/FP8 | 支持FP4/FP8 |
| TDP 功耗 | 450W | 575W | 140W |
| 散热形态 | 三风扇 3.5槽 | 三风扇 3.5+槽 | 单槽涡轮 |
| ECC 纠错 | ❌ | ❌ | ✅ |
| ISV 专业认证 | ❌ | ❌ | ✅(工业设计/仿真软件全认证) |
| 质保 | 消费级质保 | 消费级质保 | 3年专业质保 |
| 2026年参考价 | 约1.1~1.3万(已停产,渠道货) | 约1.6万(国行特供) | 约1.1~1.2万 |
规格解读:5090D v2 相比 5090D 的 32GB 被砍到 24GB(512-bit→384-bit),但带宽仍有 1344 GB/s,是三卡中最快的;RTX Pro 4000 带宽只有 672 GB/s,纯推理速度垫底,但它是唯一带 ECC 纠错、单槽 140W、可 7×24 满负荷运行的专业卡——速度换稳定。
二、24GB显存能跑哪些大模型?
2.1 三卡共同可运行的模型(显存容量相同,兼容性一致)
| 模型 | 参数规模 | 量化格式 | 显存占用 | 体验评价 |
|---|---|---|---|---|
| Qwen3-14B (FP8) | 14B | FP8 | ~14GB | ⭐⭐⭐⭐⭐ 24GB甜点配置,128K上下文无忧 |
| Qwen3.5-9B (Q8) | 9B | Q8 | ~11GB | ⭐⭐⭐⭐⭐ 留出余量跑RAG多任务 |
| Qwen3-30B-A3B (MoE) | 30B(激活3B) | Q4 | ~19-20GB | ⭐⭐⭐⭐⭐ 能力接近70B级Dense,MoE架构速度快 |
| Qwen3-32B / DeepSeek-R1-32B | 32B | Q4_K_M | ~20-22GB | ⭐⭐⭐⭐ 24GB的天花板,需关闭多余程序 |
| Gemma 4 26B | 26B | Q4 | ~16GB | ⭐⭐⭐⭐ 英文/代码出色 |
| Qwen3-Coder-14B | 14B | Q4/FP8 | 9-14GB | ⭐⭐⭐⭐ 本地代码助手 |
| QwQ-32B 推理模型 | 32B | Q4 | ~20GB | ⭐⭐⭐⭐ 数学/逻辑深度推理 |
| Qwen3-VL-30B 多模态 | 30B | Q4 | ~18GB | ⭐⭐⭐⭐ 图像理解+文档解析 |
| GPT-OSS-120B (MoE) | 120B(激活5.1B) | MXFP4 | 需CPU卸载 | ⭐⭐⭐ 128GB内存配合可体验 |
2.2 三卡推理速度实测对比(tokens/s,越高越快)
| 模型规模 | RTX 4090 | RTX 5090D v2 | RTX Pro 4000 |
|---|---|---|---|
| 8B Q4 | ~104 t/s | ~150 t/s | ~55 t/s |
| 14B Q4/FP8 | ~60-80 t/s | ~100 t/s | ~35 t/s |
| 30B-A3B MoE Q4 | ~50 t/s | ~70 t/s | ~28 t/s |
| 32B Q4 | ~32 t/s | ~45 t/s | ~18 t/s |
结论:5090D v2 全面领先 4090 约 40%+(带宽优势 + FP4 新精度格式);RTX Pro 4000 速度约为 4090 的一半——但请注意,18~28 t/s 依然远超人类阅读速度,单人交互使用完全流畅,它的价值不在速度而在稳定与密度。
2.3 多模态与垂直模型(三卡均可运行)
| 类型 | 代表模型 | 显存需求 | 说明 |
|---|---|---|---|
| 图像生成 | SDXL、SD 3.5、FLUX.1-dev | 12-24GB | FLUX全精度可跑,出图速度5090D v2最快 |
| 视频生成 | Wan 2.1/2.2、LTX Video | 16-24GB | 24GB是文生视频的舒适线 |
| 语音TTS | Qwen3-TTS、CosyVoice 2 | 8-16GB | 可与14B LLM同卡共存 |
| RAG检索 | BGE-M3、Qwen3-Reranker | 2-8GB | 与主模型共享24GB无压力 |
| LoRA微调 | 8B级LLM、SDXL/FLUX LoRA | 16-24GB | QLoRA/Unsloth框架支持 |

三、五大应用场景:三卡各适合谁?
3.1 企业私有RAG知识库
- 做什么:百万字级合同/手册/论文的本地问答,数据不出内网
- 技术栈:Qwen3-14B-FP8 或 Qwen3-30B-A3B + BGE-M3 + RAGFlow/Dify
- 选型建议:10人以下选 4090 或 5090D v2 单卡;7×24 小时对外服务选 RTX Pro 4000(ECC 保障长时运行数据不出错)
3.2 代码大模型助手
- 技术栈:Qwen3-Coder-14B + Continue.dev + VSCode
- 选型建议:研发部门 20 人以内共享一台 5090D v2 工作站(100 t/s 单路、多路并发仍有富余)
3.3 AIGC图像/视频生成
- 做什么:FLUX 文生图、Wan 文生视频、产品效果图、LoRA 模型训练
- 选型建议:创作型选 5090D v2(带宽即出图速度);渲染农场/批量生成选 RTX Pro 4000 多卡——单槽 140W,一机可插 4~6 张,密度是游戏卡的 3 倍
3.4 智能体 Agent 与深度推理
- 做什么:QwQ-32B、DeepSeek-R1-32B 思维链推理,多步任务自动拆解
- 选型建议:32B Q4 占用 20-22GB 显存,三卡都能跑,5090D v2 的 45 t/s 让长思维链等待时间最短
3.5 仿真+AI复合工作流(RTX Pro 4000 独家场景)
- 做什么:白天跑 ANSYS/SolidWorks/Creo 专业设计(ISV 认证),下班后变身大模型服务器
- 选型建议:只有 RTX Pro 4000 拥有 ISV 专业软件认证,游戏卡跑专业软件无官方驱动支持——一卡两用,是设计院/工程公司性价比最高的选择
四、三卡优缺点深度对比与选型决策
| 维度 | RTX 4090 | RTX 5090D v2 | RTX Pro 4000 |
|---|---|---|---|
| 核心优势 | 成熟度最高,生态教程最多;二手/渠道价低 | 速度最快;FP4精度格式战未来;国行正规保修 | ECC纠错;单槽140W;7×24稳定;ISV认证;3年质保 |
| 主要短板 | 已停产无新卡,渠道水深;GDDR6X高功耗发热;无FP4 | 价格比4090贵30%+;575W功耗对电源散热要求高;无ECC | 推理速度最慢(约为5090D v2的40%);不适合追求极速的个人玩家 |
| 供电/散热门槛 | 850W电源起步,机箱需4槽空间 | 1000W电源起步,建议水冷机箱 | 600W电源即可,任何标准机箱兼容 |
| 多卡扩展 | 3.5槽厚度,单机最多2张 | 3.5+槽,单机最多2张 |
单槽设计,单机4 |
| 适合人群 | 预算有限的个人开发者、AI爱好者 | 追求速度的发烧友、中小团队主力推理机 | 企业级部署、设计院一机两用、高密度推理节点 |
选型决策树
- 预算 ≤1.3万、纯个人玩 → RTX 4090(注意甄别渠道)
- 预算充足、要最快推理速度 → RTX 5090D v2
- 企业生产环境 / 需要7×24运行 / 一机还要跑专业软件 → RTX Pro 4000
- 需要 48GB+ 显存跑 70B 模型 → 三张都不选,看 UltraLAB 的 RTX Pro 6000 96GB 方案
五、UltraLAB硬件配置推荐:对应三卡的三档方案
方案A:个人AI工作站(RTX 4090,预算约2~2.5万)
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD R9 9950X(16核32线程) | RAG文档解析+混合卸载多核支持 |
| 内存 | 96GB DDR5 6000MHz | 支撑GPT-OSS-120B等大模型CPU卸载 |
| GPU | RTX 4090 24GB | 成熟生态,性价比之选 |
| 存储 | 4TB NVMe PCIe 4.0 | 模型仓库(单模型10-22GB)+知识库 |
| 散热 | 360一体式水冷 | 镇压450W显卡+16核CPU双高负载 |
| 电源 | 1000W 金牌全模组 | 450W显卡峰值余量 |
| 预装 | Ollama + OpenWebUI + ComfyUI + 客户指定模型 | 开箱即用 |
方案B:极速推理工作站(RTX 5090D v2,预算约3~3.5万)⭐ 速度之选
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | Intel Core Ultra 9 285K / AMD R9 9950X | 高频+多核兼顾 |
| 内存 | 128GB DDR5 6400MHz | 大模型卸载+多模型同驻 |
| GPU | RTX 5090D v2 24GB | 1344 GB/s带宽,32B模型45 t/s |
| 存储 | 4TB NVMe PCIe 5.0 + 8TB HDD | 模型库+数据仓库分离 |
| 散热 | UltraLAB定制分体/一体水冷 | 575W显卡7×24满负荷温控 |
| 电源 | 1600W 铂金 | 575W显卡+平台瞬时峰值冗余 |
| 预装 | vLLM/Ollama + RAGFlow + Qwen3全家桶 | 开机即服务 |
方案C:企业高密度推理节点(RTX Pro 4000 ×24,预算约512万)⭐ 稳定之选
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005系列 / Xeon w9 | 多PCIe 5.0通道,支撑多卡满速 |
| 内存 | 256GB DDR5 ECC | 与显卡ECC匹配的全链路纠错 |
| GPU | RTX Pro 4000 24GB ×2(可扩展至×4) | 48GB~96GB显存池,可跑70B级模型 |
| 存储 | 2×4TB NVMe RAID1 + 企业级NAS | 数据冗余+团队共享 |
| 散热 | 机架式风道优化(涡轮卡直排) | 单槽涡轮卡天生适合高密度堆叠 |
| 电源 | 2000W 冗余电源 | 多卡7×24不间断保障 |
| 部署 | vLLM生产框架 + 负载均衡 + 监控告警 | 支持50-200人并发 |
多卡彩蛋:4×RTX Pro 4000 = 96GB ECC显存池,可流畅运行 Qwen3-235B 量化版或 70B 全精度模型,整机功耗仅约 1000W——同等显存规模下能耗比远优于游戏卡方案。

六、常见问题与硬件配置分析(FAQ)
Q1:三张卡都是24GB,能跑的模型有区别吗?
A:没有区别。能跑什么模型由显存容量决定,三卡天花板都是 32B Q4 量化(约20-22GB)。区别只在速度:5090D v2 最快(1344 GB/s),4090 次之(1008 GB/s),RTX Pro 4000 最慢(672 GB/s)但依然远超阅读速度。
Q2:RTX Pro 4000 速度慢一半,为什么企业还选它?
A:三个关键词:ECC、单槽、质保。ECC 纠错保障 7×24 连续推理不出现数据错误(金融、医疗场景刚需);单槽 140W 让一台机器插 4~6 张卡组成大显存池;3 年专业质保 + ISV 认证是消费卡没有的。企业算的是"全年无故障总产出",不是峰值速度。
Q3:2026年还值得买 RTX 4090 吗?
A:值得,但要看渠道。4090 已停产,市面多为库存/拆机卡,价格 1.1~1.3 万。它的 1008 GB/s 带宽放到今天依然能打,教程生态最成熟。风险在于无官方保修,建议通过 UltraLAB 整机采购——显卡渠道由我们背书,整机质保兜底。
Q4:5090D v2 的 24GB 比 5090D 的 32GB 少了 8GB,影响大吗?
A:取决于目标模型。32B Q4 及以下的模型两者体验一致(5090D v2 甚至因带宽相近而速度几乎相同);32GB 版本的优势在于能跑 70B Q3 或更长的上下文。如果目标是 32B 以内,5090D v2 是更经济的选择。
Q5:24GB 能跑 70B 大模型吗?
A:单卡无法实用化运行(70B Q4 需 35-40GB)。两个解决方案:① RTX Pro 4000 双卡组 48GB 显存池,70B Q4 可达 15-20 t/s;② 直接上 UltraLAB 的 RTX Pro 6000 96GB 单卡方案,70B FP8 流畅运行。
Q6:跑 32B 模型需要多大的系统内存?
A:纯 GPU 推理时 32B Q4 全量装入 24GB 显存,系统内存 64GB 即可。若需 CPU 卸载跑 GPT-OSS-120B 等超大模型,128GB 是推荐配置。UltraLAB 三档方案均按此标准配置。
Q7:FP4 精度格式(5090D v2 / RTX Pro 4000 支持)有什么用?
A:FP4 是 Blackwell 架构的新精度格式,同模型体积比 FP8 再缩小一半、速度快一倍,且精度损失极小。随着主流框架陆续支持,24GB 显存未来可跑相当于今天 48GB 的模型规模——这是 4090(Ada架构)不具备的"战未来"能力。
Q8:电源和散热怎么配?三卡差异大吗?
A:差异很大。4090(450W)需 1000W 电源 + 良好风道;5090D v2(575W)建议 1600W 电源 + 水冷;RTX Pro 4000(140W 涡轮卡)600W 电源即可,涡轮风扇直排热气,多卡堆叠反而散热最省心。UltraLAB 每台机器出厂前均经 72 小时满负荷烤机测试。
Q9:一台机器能既跑仿真设计又跑大模型吗?
A:可以,但建议选 RTX Pro 4000——它是唯一拥有 ANSYS、SolidWorks、CATIA、Creo 等 ISV 官方认证的卡,游戏卡跑专业软件缺乏官方驱动支持。白天做设计、晚上跑推理,一机两用是设计院性价比最高的方案。
结语:24GB 是甜点,选对卡才是关键
同为 24GB,RTX 4090 胜在性价比与生态,RTX 5090D v2 胜在速度与 FP4 未来,RTX Pro 4000 胜在 ECC、密度与企业级可靠。能跑什么模型三卡相同,跑得多快、多稳、多密,才是你的决策依据。
关于 UltraLAB :
西安坤隆计算机科技有限公司,专注定制图形工作站与 AI 计算方案,服务科学仿真、EDA、AIGC 与大模型本地化部署场景,提供从单卡工作站到多卡集群的全栈硬件与预装交付,出厂 72 小时烤机,整机质保。


