






title: "160~192GB显存方案怎么选?双RTX 6000D 168GB vs 双A100 80GB 160GB vs 双RTX Pro 6000 Max-Q 192GB 大模型部署全对比"
description: "235B巨型MoE高画质与70B全精度舒适区的双卡战场:2×RTX PRO 6000D(168GB)、2×A100 80GB(160GB)、2×RTX PRO 6000 Max-Q(192GB)三方案全面对比。显存带宽、Qwen3-235B Q4/Q6部署、Decode/Prefill速度、NVLink与PCIe多卡效率、训练能力、桌面与机房形态、合规与二手渠道风险,附UltraLAB三档配置推荐与FAQ。"
keywords: "双RTX 6000D, 双A100 80GB, RTX PRO 6000 Max-Q双卡, 192GB显存, Qwen3-235B, 70B FP16, 大模型本地部署, AI服务器配置, UltraLAB, XASUN"
author: "UltraLAB / XASUN 西安坤隆计算机科技有限公司"
date: "2026-07-21"
lang: "zh-CN"
一句话结论:160~192GB 是"Qwen3-235B 高画质 + 70B 全精度从容运行"的旗舰双卡档位——双 RTX Pro 6000 Max-Q(192GB) 容量最大、算力满血、主动散热可放桌面,是毫无争议的性能之王但价格最高;双 RTX 6000D(168GB) 以约 10 万的合规现货价格提供 80% 的推理体验,是纯推理部署的性价比之王;双 A100 80GB(160GB) 凭 4TB/s 聚合带宽与 NVLink 守住老将阵地,Decode 速度依然第一梯队。
关键词:双RTX 6000D | 双A100 80GB | 双RTX Pro 6000 Max-Q | 192GB显存 | Qwen3-235B | 70B全精度 | UltraLAB图形工作站

本文目录
- 三方案规格对比:双卡旗舰的三条路径
- 能跑哪些大模型(235B高画质与70B全精度对照表)
- 五大应用场景落地分析
- 三方案优缺点深度对比与选型决策
- UltraLAB硬件配置推荐(三档方案)
- 常见问题与硬件配置分析(FAQ)
一、三方案规格对比:双卡旗舰的三条路径
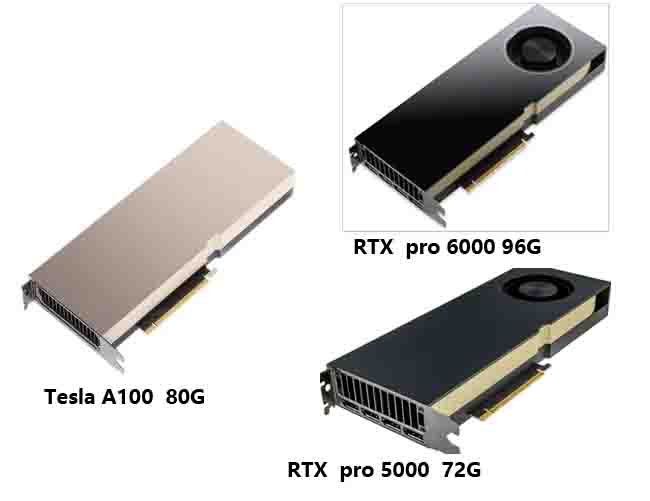
| 规格项 | 2×RTX PRO 6000D(168GB) | 2×A100 80GB(160GB) | 2×RTX PRO 6000 Max-Q(192GB) |
|---|---|---|---|
| 架构 / 年份 | Blackwell / 2025(中国特供) | Ampere / 2021 | Blackwell / 2025 |
| 显存总量 | 168GB GDDR7 ECC | 160GB HBM2e | 192GB GDDR7 ECC |
| 显存带宽 | 1568 GB/s×2(有效约1280/卡) | 2039 GB/s×2 | 1792 GB/s×2 |
| 聚合带宽 | ~3136 GB/s | ~4078 GB/s | ~3584 GB/s |
| CUDA 核心 | 19968×2 = 39936 | 6912×2 = 13824 | 24064×2 = 48128 |
| BF16 张量算力 | 约288 TFLOPS(被阉割至36%) | 624 TFLOPS | 约880 TFLOPS(满血) |
| FP8 / FP4 | ✅ | ❌ | ✅ |
| 卡间互联 | PCIe 5.0 | NVLink 桥接 | PCIe 5.0 |
| MIG 虚拟化 | ✅ | ✅ 14实例 | ✅ 8实例(4×24GB×2) |
| 总功耗 | 1200W(实测峰值约840W) | 600-800W | 600W(能效最优) |
| 散热形态 | 被动×2(需服务器风道) | 被动×2(需服务器风道) | 主动涡轮×2(桌面可用) |
| 国内合规渠道 | ✅ 特供正规现货 | 二手/拆机 | △ 渠道特殊(需甄别) |
| 2026年参考价 | 约10万(两张现货) | 约10~14万(两张二手) | 约16~20万(两张) |
规格解读:三方案恰好构成"合规-情怀-性能"三角。双 6000D 是新架构+合规+低价,但 BF16 算力被限(训练/长 Prefill 弱);双 A100 聚合带宽最高且 NVLink 互联效率最优,输在架构老、无 FP8、二手风险;双 Max-Q 是唯一"无短板"方案:192GB 最大容量 + 满血算力 + 600W 最低功耗 + 唯一桌面可放,代价是价格与渠道门槛。
二、能跑哪些大模型?235B高画质与70B全精度对照表
2.1 三方案模型兼容对照表
| 模型 | 量化/精度 | 显存占用 | 双6000D 168GB | 双A100 160GB | 双Max-Q 192GB |
|---|---|---|---|---|---|
| Qwen3-235B-A22B (MoE) | Q4 | ~130GB | ✅(余38GB KV) | ✅(余30GB KV) | ✅ 从容(余62GB) |
| Qwen3-235B-A22B | Q6 高画质 | ~185GB | ❌ | ❌ | △ 临界(少量卸载) |
| 70B 系列 | FP16 全精度 | ~140GB | ✅(余28GB) | ✅(余20GB) | ✅ 从容(余52GB) |
| 70B 系列 | FP8 双实例并行 | 70GB×2 | ✅ 每卡一实例 | ❌ 无FP8硬件 | ✅ 每卡一实例 |
| GPT-OSS-120B | FP8 | ~120GB | ✅ 从容 | △ 临界 | ✅ 从容 |
| GLM-4.5-Air 106B | Q8 | ~91GB | ✅ | ✅ | ✅ |
| Llama-4-Scout 109B | Q6 | ~88GB | ✅ | ✅ | ✅ |
| 多模型同驻 | 70B FP8 + 32B Q8 + Embedding栈 | ~115GB | ✅ | ✅ | ✅ 更从容 |
| DeepSeek-R1 671B | Q4 | ~380GB | ❌ 需4卡 | ❌ 需6卡 | ❌ 需4卡 |
| 70B LoRA/QLoRA微调 | — | 90-150GB | △(BF16阉割,慢) | ✅ 快 | ✅ 最快 |
| 32B 全参数微调 | — | ~130GB+优化器 | ❌ 不推荐 | ✅ | ✅ 推荐 |
192GB 的三个独占能力:① 235B Q4 后余 62GB KV Cache——支持万级上下文+中等并发,168GB 方案只剩 38GB;② 70B FP16 后余 52GB,可同驻第二个 32B 模型做"主模型+校验模型"双脑架构;③ 235B Q6 高画质摸到门槛(其他两方案完全无缘)。
2.2 推理速度对比(tokens/s,越高越快)
| 场景 | 双6000D 168GB | 双A100 160GB | 双Max-Q 192GB |
|---|---|---|---|
| 70B Q4/Q8 Decode | ~36 t/s | ~40 t/s(NVLink加持) | ~40 t/s |
| 235B Q4 Decode | ~18 t/s | ~22 t/s | ~28 t/s |
| 120B FP8 Decode | ~30 t/s | ❌ 无FP8 | ~38 t/s |
| 长文本 Prefill(16K) | 慢(BF16阉割) | 快 | 最快(满血880 TFLOPS) |
| vLLM 高并发吞吐 | 强(FP8 KV省显存) | 强 | 最强 |
| 训练/微调 | 最慢 | 快 | 最快 |
核心规律:Decode 场景三方案同梯队(35-40 t/s),A100 靠 NVLink 弥补架构劣势;真正的分水岭在 Prefill 与训练——6000D 的 BF16 阉割使其长文档 RAG 体验明显落后,Max-Q 满血算力则全面领跑。纯 Decode 对话选 6000D 最划算;涉及长文档/训练必须 Max-Q 或 A100。
2.3 多模态与垂直模型
| 类型 | 代表模型 | 最佳方案 |
|---|---|---|
| 视频生成 | Wan 2.2 14B 双实例流水线 | 双Max-Q(FP8+大显存) |
| 多模态大模型 | Qwen3-VL-32B 批量高并发 | 双Max-Q / 双6000D |
| 深度研究Agent | 70B FP8 主模型 + 32B 工具模型同驻 | 双Max-Q(192GB独占) |
| 医学影像AI | 大体积3D重建+诊断模型同驻 | 双Max-Q(容量+ECC) |
| 多租户服务 | MIG 8-14实例切分 | 双A100(14实例最细)/ 双Max-Q |

三、五大应用场景:三方案各适合谁?
3.1 Qwen3-235B 私有化部署(本档位核心场景)
- 做什么:国产最强开源 MoE 本地运行,能力对标云端旗舰 API
- 选型建议:纯对话推理选双 6000D(10 万合规现货,18 t/s 够用);要长上下文/高并发/未来扩 Q6 选双 Max-Q(62GB KV 余量);双 A100 居中但无 FP8 红利
3.2 70B 全精度科研与关键业务
- 做什么:医疗/法律/金融场景的 70B FP16,精度零容忍
- 选型建议:双 Max-Q——FP16 后余 52GB 可同驻 Embedding/Reranker 全栈;双 6000D 余量局促;双 A100 无 FP8 KV Cache 压缩能力
3.3 长文档 RAG 与深度研究 Agent
- 做什么:百万字语料 + 16K-128K 长上下文,Prefill 密集
- 选型建议:双 Max-Q 首选(满血 Prefill),双 A100 次选(NVLink+624 TFLOPS),双 6000D 不推荐(16K Prefill 慢 2 倍以上)
3.4 模型微调与领域定制
- 做什么:70B LoRA、32B 全参数 SFT
- 选型建议:双 Max-Q(880 TFLOPS BF16)是唯一推荐;双 A100(624 TFLOPS)为预算备选;双 6000D 训练耗时约 3 倍,仅适合偶尔轻量微调
3.5 桌面旗舰双卡工作站(Max-Q 独家)
- 做什么:工位上跑 235B/70B FP16,不进机房
- 选型建议:双 Max-Q 是唯一解——主动涡轮×2 + 600W 总功耗,塔式工作站即可容纳;双 6000D 与双 A100 均为被动散热必须进机房
四、三方案优缺点深度对比与选型决策
| 维度 | 双6000D 168GB | 双A100 80GB 160GB | 双Max-Q 192GB |
|---|---|---|---|
| 核心优势 | 合规现货+最低价(约10万);新架构FP8/FP4;Decode达Max-Q九成 | 聚合带宽最高4TB/s;NVLink互联;MIG 14实例;BF16算力624 TFLOPS | 全能王:192GB最大+满血算力+600W最低功耗+唯一桌面可用+MIG 8实例 |
| 主要短板 | BF16阉割(训练/长Prefill弱);被动散热;无显示输出;无NVLink | 无FP8/FP4;二手风险×2;架构最老;160GB最小 | 价格最高(16-20万);渠道特殊需甄别;无NVLink |
| 部署位置 | 仅机房 | 仅机房 | 桌面+机房 |
| 训练能力 | 弱 | 强 | 最强 |
| 采购风险 | 低(特供正规) | 高(二手×2) | 中(渠道特殊,认准验证渠道) |
| 适合人群 | 合规优先、纯推理、预算敏感的企业 | 有运维能力、重Decode与多租户的技术团队 | 预算充足、训练+推理+长文档全都要的团队 |
选型决策树
- 一步到位:训练+长文档+桌面形态+最大容量 → 双 RTX Pro 6000 Max-Q(192GB)
- 合规现货、纯推理对话、预算卡死 10 万级 → 双 RTX 6000D(168GB)
- 带宽执念、多租户 MIG、已有 A100 运维经验 → 双 A100 80GB(160GB)
- DeepSeek-671B 目标 → 三方案都不够,看 UltraLAB 的 4×Max-Q(384GB)或 8×H20(1128GB)集群
五、UltraLAB硬件配置推荐:对应三方案的三档配置
方案A:旗舰全能双卡工作站(2×RTX Pro 6000 Max-Q 192GB,预算约22~28万)⭐ 一步到位
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005 / Xeon w9 | 双PCIe 5.0 x16满速通道 |
| 内存 | 384GB DDR5 ECC | 192GB显存的2倍配比,训练/KV余量充足 |
| GPU | RTX Pro 6000 Max-Q 96GB ×2 | 192GB满血,235B Q4达28 t/s,桌面可放 |
| 存储 | 2×4TB NVMe PCIe 5.0 + 16TB HDD | 235B模型130GB秒级加载 |
| 散热 | 高性能塔式风道 | 双主动涡轮直排,600W总功耗静音可控 |
| 电源 | 2000W 铂金 | 双卡+平台冗余 |
| 预装 | vLLM(FP8)+ RAGFlow + Unsloth + Qwen3-235B + DeepSeek-R1-70B | 推理+训练开箱即用 |
| 增值 | 双卡渠道验证 + 72小时烤机 + 整机一年质保 | 特殊渠道风险清零 |
方案B:合规推理双卡节点(2×RTX 6000D 168GB,预算约15~18万)⭐ 性价比首选
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005系列 | 高并发调度 |
| 内存 | 256GB DDR5 ECC | 全链路纠错 |
| GPU | RTX Pro 6000D 84GB ×2 | 合规现货,235B Q4/70B FP16双达标 |
| 存储 | 2×4TB NVMe RAID1 | 模型冗余 |
| 机箱 | 4U机架式风道 | 双被动卡散热保障(实测单卡峰值仅420W) |
| 电源 | 3000W 冗余 | 双卡1200W标称留足余量 |
| 部署 | vLLM(FP8)+ 负载均衡 + 监控告警 | 高并发能效最优 |
方案C:带宽情怀双卡节点(2×A100 80GB 160GB,预算约14~18万)
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005系列(64核) | 数据预处理+调度 |
| 内存 | 512GB DDR5 ECC | 训练数据缓存 |
| GPU | A100 80GB ×2 NVLink桥接 | 4TB/s聚合带宽,Decode第一梯队+MIG 14实例 |
| 存储 | 2×8TB NVMe RAID1 | 数据集+模型库 |
| 机箱 | 4U机架暴力风道 | 双被动卡散热保障 |
| 电源 | 2000W 冗余 | 稳定优先 |
| 增值 | 双卡来源验证 + 逐卡烤机报告 + 整机一年质保 | 二手风险×2全面兜底 |
扩展彩蛋:三方案均可横向扩展——4×Max-Q = 384GB(235B Q8/671B Q4 摸到门槛);4×6000D = 336GB(235B Q4 高并发集群);4×A100 80GB = 320GB(NVLink 全互联)。UltraLAB 支持从双卡起步、按需加卡的渐进投资路径。

六、常见问题与硬件配置分析(FAQ)
Q1:192GB、168GB、160GB 的实际差距体现在哪?
A:两个关键点:① 235B Q4 的 KV Cache 余量——192GB 余 62GB(万级上下文+中并发),168GB 余 38GB,160GB 余 30GB,长上下文体验差距明显;② 235B Q6(185GB)——只有 192GB 摸到门槛。若只跑 235B Q4 标准上下文或 70B 级模型,三方案体验接近,双 6000D 性价比最高。
Q2:双 Max-Q 没有 NVLink,多卡效率会不会很差?
A:对 LLM 推理影响有限。张量并行的通信量在 Decode 阶段较小,PCIe 5.0 x16(64GB/s 双向)足以支撑双卡 70B/235B 推理,实测与 NVLink 方案差距约 5-10%。真正需要 NVLink 的是 4 卡以上大规模并行与训练场景——双卡 Max-Q 的满血算力完全覆盖这个差距。
Q3:双 6000D 跑长文档 RAG 真的不行吗?
A:不是"不行"是"偏慢"。6000D 的 BF16/FP16 算力被限至满血版 36%,16K 上下文 Prefill 耗时约为 Max-Q 的 2.2-2.45 倍——10 万字文档入库分析,Max-Q 等 1 分钟,6000D 等 2.5 分钟。高频长文档场景建议 Max-Q 或 A100;以短问答为主的知识库,6000D 完全够用。
Q4:双 A100 80GB 在 2026 年还有什么独特价值?
A:三个点:① 聚合带宽 4078 GB/s 三方案最高,纯 Decode 速度第一梯队;② NVLink + MIG 14 实例,多租户切分最灵活;③ 成熟的 Ampere 集群运维生态。短板同样明确:无 FP8、二手无保、被动散热。适合有运维能力、重 Decode 与多租户的团队"抄底"。
Q5:三套方案能放普通办公室吗?
A:只有双 Max-Q 可以(主动涡轮×2,600W 总功耗,塔式机箱+1200W 电源即可,噪音低于多数游戏主机)。双 6000D 与双 A100 均为被动散热,必须 4U 机架机箱+设备间——机房成本采购时务必计入。
Q6:想跑 DeepSeek-R1 671B,这三套方案怎么扩?
A:671B Q4 需 380GB+:双卡方案都不够,需扩至 4×Max-Q(384GB,刚好 Q4)、4×6000D(336GB,Q3 压缩)或换赛道直接上 8×H20 141GB(1128GB,FP8 满血)。UltraLAB 建议按"双卡起步验证业务 → 四卡扩产 → 八卡集群"的渐进路径投资。
Q7:70B FP16(140GB)在三种方案上的实际体验差异?
A:都能跑,差异在余量:双 Max-Q 余 52GB(可同驻 32B 校验模型或长上下文),双 6000D 余 28GB(标准上下文),双 A100 余 20GB(上下文建议 8K 内)。FP16 场景通常伴随精度敏感的科研/医疗需求,余量最大的 Max-Q 最稳。
Q8:双 6000D 的 FP4 支持对 235B 部署有什么实际好处?
A:FP4 权重让 235B 从 Q4 的 130GB 进一步压缩至约 100GB 级——168GB 显存留出 68GB KV Cache,并发能力提升近一倍。随着 vLLM/SGLang 的 FP4 支持成熟,6000D 的 168GB 实际可当"230GB 等效容量"用,这是 A100 无法获得的架构红利。
Q9:三方案跑 235B 和 70B 的真实体验排序?
A:235B Q4 Decode:双Max-Q(~28 t/s)> 双A100(~22)> 双6000D(~18)。70B Decode:双A100 ≈ 双Max-Q(~40)> 双6000D(~36)。长文档 Prefill:双Max-Q > 双A100 > 双6000D。训练:双Max-Q > 双A100 ≫ 双6000D。性价比:双6000D 第一。综合推荐:双Max-Q 第一。
结语:双卡旗舰档,买的是"余量"二字
192GB、168GB、160GB 都能跑 235B 与 70B 全精度——真正的差距在 KV Cache 余量、Prefill 算力与部署形态。
纯推理选双 6000D,带宽与多租户选双 A100,一步到位选双 Max-Q——UltraLAB 帮您把双卡投资精确匹配到真实负载。
关于 UltraLAB :
西安坤隆计算机科技有限公司,专注定制图形工作站与 AI 计算方案,提供 RTX PRO 全系双卡/四卡集群(Max-Q/6000D)与 A100 验证货源的全栈交付,出厂 72 小时烤机,整机质保。


