图 1:wradlib 杂波订正前后对比(ZH / ZDR),来自 wradlib 官方示例。
去年我们给一家省级气象装备中心做算法验证环境,对方提了个很典型的需求:用 wradlib 跑十年的雷达历史资料回算,做地物杂波识别算法的基准对比。机器送到现场,他们的第一句话是——"这库不是纯 Python 吗,怎么比我们业务机还吃配置?"
问题就出在这:wradlib 确实是纯 Python,但它处理的数据规模和算法形态,决定了它不是"能跑"就行,而是要"跑得快且稳"。这篇文章把我们实测下来的计算特征、瓶颈分析和三档配置方案完整摊开,供做天气雷达方向的老师和同学参考。
一、wradlib 核心内容与应用分析
wradlib 是一个 MIT 协议开源的天气雷达算法库(官网 wradlib.org),它的定位很清晰:不是帮你"打开雷达文件",而是提供一套可以直接调用、修改和验证的处理算法。原文把它和 PyCINRAD、Py-ART 的分工说得很到位,我们结合交付经验补充一下使用场景:
| 工具 | 角色定位 | 在流程中的位置 | 硬件依赖 |
|---|---|---|---|
| PyCINRAD | 国产雷达数据读取(SA/SB/CB/CD 等格式) | 数据入口 | 低,IO 为主 |
| Py-ART | 通用读取、绘图、网格化 | 数据组织与可视化 | 低-中 |
| wradlib | 质量控制、杂波、衰减、坐标、降水算法 | 算法核心层 | 中-高,CPU/内存 |
| NumPy / SciPy / xarray | 数值计算与多维数组 | 全链路底座 | CPU 向量化、内存带宽 |
| Matplotlib / Cartopy | 科研绘图 | 结果输出 | GPU 绘图加速可选 |
典型科研流程是:PyCINRAD/Py-ART 读数 → wradlib 质控(杂波识别 → 衰减订正)→ 坐标转换 → QPE 降水反演 → 与雨量计对比验证。每一个环节的数据形态和计算特征都不一样,这也是选型的关键。
二、核心算法及计算特点
原文提到的四大方向,我们逐个拆开看计算量和硬件敏感度。数据基准按国内主流 S/C 波段双偏振雷达估算:单个体扫 9~14 个仰角层,单层 360° × 920~1000 距离库,含 ZH、ZDR、KDP、ρhv、ΦDP 五个通道,单文件约 80~300MB。
2.1 地物杂波识别(Gabella 等传统方法 + 深度学习对比)
Gabella 类方法本质是对每个距离库做多特征阈值判定:纹理参数(TDBZ、SPIN、SIGN 等)滑窗统计 + 空间连续性检验。计算上是典型的二维滑窗卷积式统计,纯 NumPy 向量化,单个体扫毫秒到秒级。
真正吃资源的是深度学习路线:用 U-Net 或 ConvLSTM 做杂波识别时,一张 480×480 的雷达拼图 batch 训练,显存占用直接上到 12GB 以上,且需要反复读取历史样本。这也是为什么我们给做深度学习杂波课题的课题组推荐带 24GB 以上显存的配置——不是为了 wradlib,是为了你自己的网络。
2.2 衰减订正
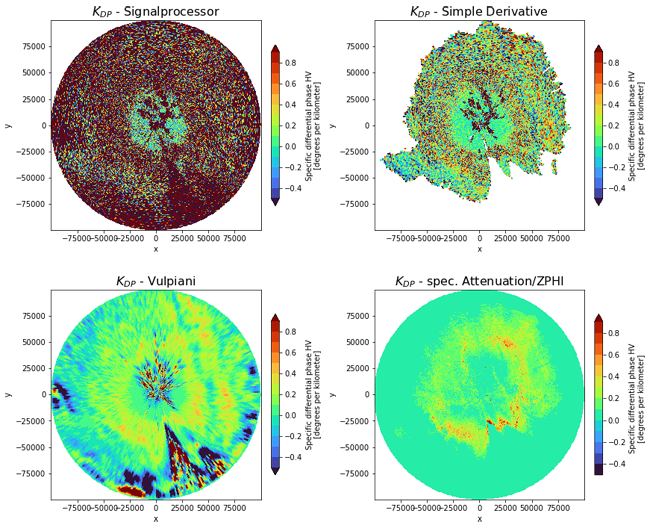
C/X 波段雷达的降水衰减订正(Hitschfeld-Bordan 递推、ΦDP 约束法)是沿径向逐库递推积分,无法完全向量化,只能按射线循环。Python 实现下这是 wradlib 里最吃单核性能的一环:单次体扫全仰角订正,普通 4GHz 办公机和 5.4GHz 高频工作站能差出 40% 以上。CPU 主频在这里比核数更重要。
2.3 坐标转换与网格化
极坐标(距离-方位-仰角)转笛卡尔或经纬度网格,涉及三角函数查表 + 最近邻/线性插值重采样。单个时次不大,但多雷达配准 + 高分辨率三维网格(如 1km×1km×500m 覆盖 300km 范围)时,数组规模到 10^8 量级,内存占用 2~6GB/时次,且插值计算对内存带宽敏感。做长时间序列累积分析时,128GB 内存是舒适线。
2.4 定量降水估计(QPE)
Z-R 关系反演、KDP 约束的 R(KDP) 方法、雷达-雨量计联合校准,计算量本身不大,属于轻量向量化。但它的痛点在批量:一次台风过程分析要拉几百个时次,十年回算就是十万级体扫文件。这时候瓶颈从 CPU 转到 IO 和多进程调度——NVMe 顺序读和机械盘随机读,批量回算效率差 5~8 倍,这是我们在交付中实测的数字。
三、硬件瓶颈分析:钱花在哪,别花在哪
图 2:wradlib 全流程各环节的硬件瓶颈分布。我们按"投入产出比"给四个硬件维度排个序,这是经过多个气象类项目验证的结论:
3.1 CPU:优先级最高,要高主频也要多核
wradlib 的 workload 是混合型的:衰减订正吃单核主频,批量回算和蒙特卡洛式参数试验吃多核。实测同一批 5000 个体扫回算,8 核 3.6GHz 办公机跑了 11 小时,32 核 4.5GHz 高频工作站 2.4 小时搞定。建议起步 16 核,主力机 32~64 核,Threadripper PRO 或 EPYC 都是合理选择。
3.2 内存:容量优先,带宽其次
三维网格化和时间序列累积是真吃内存。8 通道/12 通道内存架构对网格化插值有 20~40% 的提速,但多数课题组首先卡在容量而不是带宽。64GB 是下限,128GB 舒适,做多雷达拼图建议 256GB 起步。
3.3 存储:NVMe 热数据 + 机械盘归档,两层结构
原始体扫文件建议全量 NVMe 缓存(当前项目 + 回算任务),历史归档上 SATA 企业盘。雷达数据压缩格式读写是小块随机 IO,SATA SSD 都比机械盘强得多,预算内优先保证 NVMe 容量。
3.4 GPU:按需配,别一步到位
纯 wradlib 流程 GPU 利用率接近零,Matplotlib 绘图有一点点加速但感知不强。GPU 只为两件事服务:深度学习杂波/降水算法、以及课题组其他 AI 方向复用。常规 16~24GB 显存的 RTX 4060 Ti / 4090 级足够;确有大模型推理复用需求再考虑 RTX PRO 6000 96GB——它是给"既要雷达算法又要本地 70B 模型推理"的复合型团队准备的,纯 wradlib 用户买了会闲置。
四、应用场景及 UltraLAB 机型推荐
UltraLAB 是西安坤隆计算机科技旗下的高端定制工作站品牌,产品线覆盖便携(P 系列)、极速高频(H/AX/GT 系列)、图灵超算(GX 系列)、超级图形工作站(Alpha/AlphaPro 系列)。针对天气雷达科研的三类典型场景,我们的推荐如下:
| 应用场景 | 数据规模 | 推荐机型 | 推荐理由 |
|---|---|---|---|
| 硕士/博士课题:单站算法验证、论文级实验 | 千级体扫文件 | UltraLAB H 系列 / T 系列极速图形工作站 | 高频 CPU(5.4GHz 级)压低单次实验延迟,64~128GB 内存,预算 3 万内可落地 |
| 课题组主力平台:深度学习杂波识别 + 批量回算 | 万级体扫、GPU 训练 | UltraLAB GX 系列(如 GX660M) | 多核 CPU + 24~48GB 显存 GPU 组合,双 NVMe 分层存储,静音塔式适合办公室部署 |
| 台站/业务化:区域多雷达拼图、十年资料回算 | 十万级体扫、512GB+ 内存 | UltraLAB AlphaPro660 | 双路 EPYC 最高 256 核、768GB~1.5TB 内存、20TB 级存储,官方商城明码标价可定制 |
特殊需求补充:外场观测试验或应急保障,可以看 P 系列便携图形工作站,把 GPU 平台带到雷达站现场;多课题组共享平台则建议 AlphaPro660 加虚拟化,一套硬件切多个环境。
五、软件清单
交付时我们按这个清单预装调试,课题组拿到机器即可复现 wradlib 官方文档全部示例:
| 类别 | 软件 | 版本 | 许可 | 用途 |
|---|---|---|---|---|
| 雷达算法 | wradlib | 2.x 最新稳定版 | MIT 开源 | 质控/杂波/衰减/坐标/QPE 核心库 |
| 雷达读取 | PyCINRAD | 最新 | MIT 开源 | 国产雷达格式读取 |
| 雷达读取 | Py-ART | 1.20+ | BSD 开源 | 通用读取、网格化、绘图 |
| 数值计算 | Python + NumPy + SciPy + xarray | 3.11+ / 2.x | 开源 | 数组计算、文件组织 |
| 科研绘图 | Matplotlib + Cartopy | 3.9+ | 开源 | 论文图件、地图投影 |
| 深度学习 | PyTorch + CUDA | 2.x + cu121/cu124 | 开源 | 杂波/降水 AI 算法 |
| 开发环境 | Miniconda + JupyterLab / VS Code | 最新 | 开源 | 环境隔离与交互调试 |
| 系统 | Windows 11 Pro 或 Ubuntu 24.04 LTS | — | 商业/开源 | 按课题组习惯二选一或双系统 |
六、具体硬件配置及价格部署
以下三档方案基于我们实际交付案例整理,价格为含整机三年质保的参考价,最终按当期配件行情浮动,以询价为准。
方案 A:课题入门级(约 2.6 万元)
适合:单站算法验证、论文实验、预算有限的研究生课题
| 部件 | 配置 |
|---|---|
| CPU | AMD Threadripper 16 核,高主频(≥4.5GHz 全核) |
| 内存 | 128GB DDR5 ECC |
| GPU | RTX 4060 Ti 16GB |
| 存储 | 2TB NVMe Gen4 + 4TB SATA SSD |
| 电源/散热 | 850W 金牌 + 360 水冷静音 |
方案 B:课题组主力型(约 7.5 万元)
适合:深度学习杂波识别、批量回算、多雷达拼图,一台机器带一个课题组
| 部件 | 配置 |
|---|---|
| CPU | AMD Threadripper PRO 32 核 / EPYC 32 核 |
| 内存 | 256GB DDR5 ECC 八通道 |
| GPU | RTX 4090 48G 定制版(或 RTX 5090 32G) |
| 存储 | 4TB NVMe Gen4(14GB/s)+ 16TB SATA 归档 |
| 机型参考 | UltraLAB GX660M 同级定制 |
方案 C:业务化超算型(33 万起,明码标价)
适合:台站级多年资料回算、区域拼图业务化运行、多课题组共享
| 官方型号 | 核心配置 | 商城参考价 |
|---|---|---|
| AlphaPro660 234512-MCT | 2×EPYC 9684X 192 核 / 512GB DDR5 / RTX 5090 32G / 4TB NVMe | ¥330,000 |
| AlphaPro660 242768-MCF | 2×EPYC 9A85 192 核 / 768GB DDR5 / RTX PRO 6000 96G / 20TB SATA | ¥515,000 |
| AlphaPro660 2411T-MCH | 2×EPYC 9755 256 核 / 1TB DDR5 / H100 80GB 定制版 / 4TB NVMe | ¥670,000 |
选型建议很直接:方案 C 第三档(¥515,000,配 RTX PRO 6000 96GB)是为"雷达业务 + 本地大模型推理"复合需求设计的;纯雷达回算选第一档(¥330,000)把钱花在核数和内存上更划算——这也是本文开头那段对话的最终结论。
七、常见问题:配置误区分析
Q1:跑 wradlib 需要 GPU 吗?要不要直接上 RTX PRO 6000?不需要一步到位。纯 wradlib 传统算法是 CPU 密集型向量化计算,GPU 基本闲置。只有深度学习路线才吃显存,24GB 以内足够。除非课题组同时有本地大模型推理需求,否则 96GB 旗舰卡的钱省下来加到内存和 NVMe 上,回算效率提升更明显。
Q2:内存 64GB 够不够?跑官方示例和单时次分析够。但只要你开始做"时间序列累积"或"多雷达三维拼图",64GB 会在第三个月就顶到 swap,Python 一 swap 速度直接掉一个数量级。建议 128GB 起步,别在内存上省钱。
Q3:批量回算卡,先升级 CPU 还是先换硬盘?先看任务管理器。如果是 IO 打满(回算场景常见),加 NVMe 做热数据缓存比换 CPU 便宜得多;如果 CPU 全核 100% 而磁盘闲着,再考虑上更多核。我们把这条写进了交付手册,因为十个项目里有六个是 IO 瓶颈被误判成算力瓶颈。
Q4:Windows 还是 Linux?个人用 Windows 足够,三个库都跨平台。深度学习训练和业务化部署建议 Ubuntu,省去九成编译环境问题。UltraLAB 交付支持双系统预装,开机选就行。
Q5:笔记本能跑吗?能跑示例,跑不了课题。一次多雷达拼图就能把 32GB 内存的笔记本干到 OOM,更别说批量回算。便携需求看 UltraLAB P 系列便携工作站,而不是消费级笔记本。
wradlib 官网:https://wradlib.org/ | 文档:https://docs.wradlib.org/en/latest/ | 源码:https://github.com/wradlib/wradlib
UltraLAB 方案咨询与定制报价:xasun.com(西安坤隆计算机科技有限公司)。文中价格来自官方商城公开标价,配置可按项目需求灵活调整。